Regex et correspondance de motifs

Testeur regexavec captures visibles

Saisissez le corps du motif sans délimiteurs /. Les espaces et retours à la ligne sont conservés ; un motif vide est valide.

Testeur regex

Motif

Saisissez (cat), pas /cat/g, et placez g dans son champ. Le texte n’est pas rogné. L’éditeur ou le presse-papiers peut normaliser les fins de ligne : ce n’est pas un test de fichiers à l’octet près.

Texte de test

Résultat

Saisissez du texte ou lancez un test.

Le motif et le texte sont traités dans un Worker local au navigateur, sans envoi au serveur.

Options

Chaque flag apparaît une seule fois. u et v sont incompatibles. Sans g, recherche, remplacement et extraction utilisent la première correspondance.

Flags reconnus ici : Détection du navigateur…
  • d — Inclure les indices des captures.
  • g — Toutes les correspondances, sans effet sur split.
  • i — Ignorer la casse selon JavaScript.
  • m — ^ et $ reconnaissent les limites de ligne.
  • s — Le point inclut les fins de ligne.
  • u — Syntaxe Unicode et points de code.
  • v — Ensembles Unicode ; incompatible avec u.
  • y — Correspondre à lastIndex uniquement ; chaque test démarre à 0.

Identité du navigateur : Détection du navigateur…. Il s’agit du User-Agent annoncé, pas de la version exacte du moteur.

Limites en unités UTF-16 : texte 100000, motif 2000, remplacement 10000, sortie remplacée 1000000, rapport 4000000. Maximum 10000 éléments ; tout dépassement fait échouer le test entier. Délai : 2 secondes.

Saisissez du texte ou lancez un test.

Seul un remplacement à jour, Unicode valide et limité à 100000 unités UTF-16 peut devenir l’entrée. Vérifiez puis appliquez ; le retour arrière restaure entrée, options et résultat.

Le Testeur regex aide à comprendre pourquoi une recherche entre guillemets avale parfois plusieurs champs. Sur un texte contenant deux valeurs citées, comparez une répétition gourmande avec sa forme paresseuse et observez la plage réellement trouvée.

Pour tester des expressions régulières, gardez les guillemets et séparateurs de votre exemple réel. Cette regex en ligne affiche les groupes de capture, ce qui permet de vérifier si le remplacement reprend seulement une valeur ou aussi sa ponctuation.

Pourquoi utiliser ce Testeur regex

Relier le motif au résultat

Vérifier le champ réellement capturé

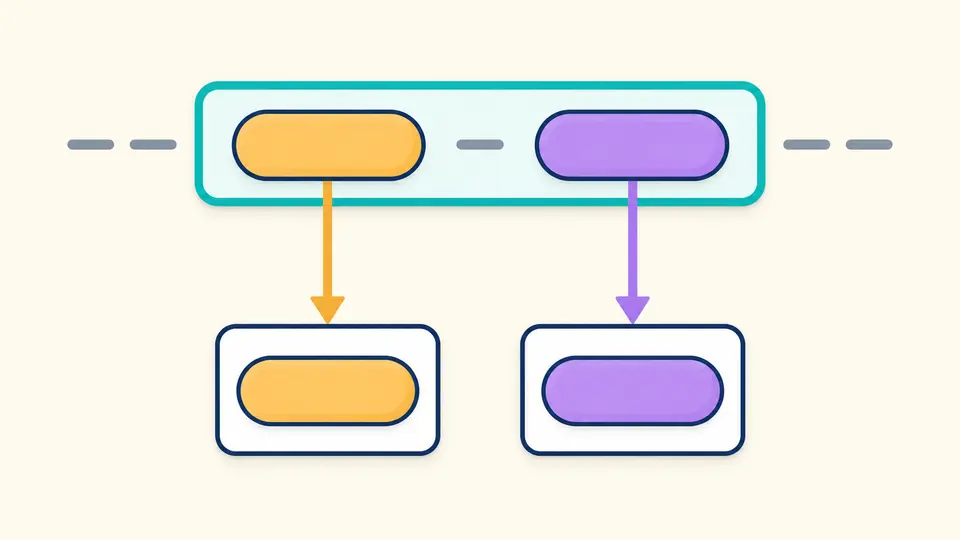
Le Testeur regex affiche séparément le résultat entier et ses groupes. Numéros, noms et positions UTF-16 permettent de vérifier le champ qui sera réutilisé dans le remplacement.

Une correspondance entière entoure deux captures colorées, reliées à leurs fiches de détails par des flèches.

Comparer un remplacement à tous

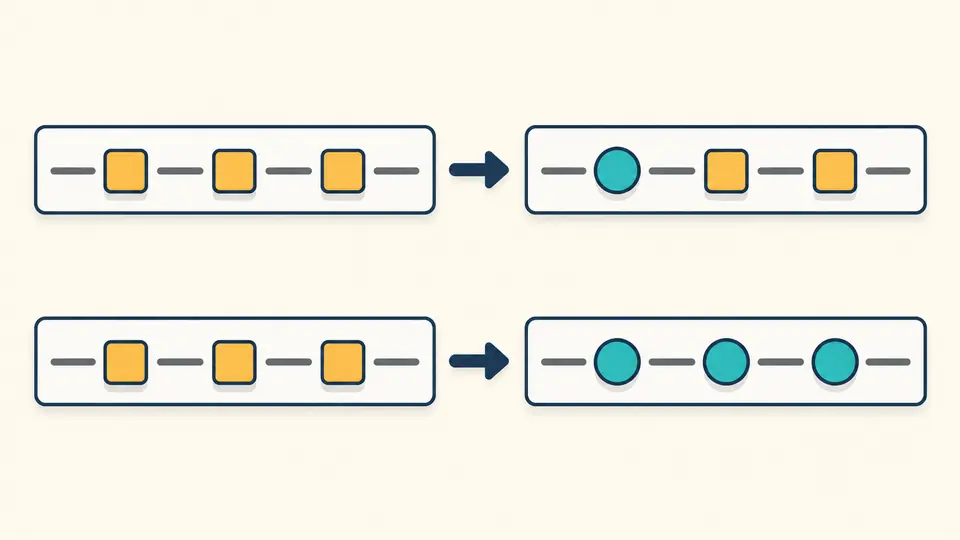
Sans g, seule la première occurrence change ; avec g, toutes changent. Comparez les deux sur le même texte, puis confirmez l’aperçu avant de remplacer l’entrée.

Deux lignes comparent le remplacement de la première occurrence au remplacement des trois occurrences.

Relier le motif au résultat

01

Saisir le motif sans le modifier

Saisissez (cat), pas /cat/g, et placez g dans son champ. Le texte n’est pas rogné. L’éditeur ou le presse-papiers peut normaliser les fins de ligne : ce n’est pas un test de fichiers à l’octet près.

  • Choisissez un exemple, vérifiez la modification puis appliquez-la.
02

Choisir le comportement

Cherchez cat dans cat cat, puis retirez g : deux résultats deviennent un. Le mode automatique attend 350 ms ; sinon, utilisez Ctrl/Cmd+Enter. split ne suit pas la restriction à la première occurrence.

  • Chaque flag apparaît une seule fois. u et v sont incompatibles. Sans g, recherche, remplacement et extraction utilisent la première correspondance.
03

Contrôler l’export complet

Distinguez null de "" dans les détails : groupe non participant ou capture vide. La liste augmente par 50 éléments ; le rapport JSON conserve tous les résultats acceptés.

  • Seul un remplacement à jour, Unicode valide et limité à 100000 unités UTF-16 peut devenir l’entrée. Vérifiez puis appliquez ; le retour arrière restaure entrée, options et résultat.

Quatre opérations sur le texte

Correspondances et groupes

Avec (Ada) (Lovelace), le résultat entier est Ada Lovelace, les groupes 1 et 2 sont les champs séparés. d ajoute leurs plages ; un lookbehind peut capturer hors de la plage complète.

Remplacement regex en aperçu

(?<year>\d{4})-(?<month>\d{2}) avec $<month>/$<year> transforme 2026-09 en 09/2026. Comparez g au remplacement unique avant d’appliquer la modification.

Extraire un groupe précis

Pour ID:(\d+), le groupe 1 extrait 42 de ID:42, tandis que 0 garde tout. L’existence du groupe est contrôlée seulement si des correspondances existent ; une sélection absente provoque alors une erreur.

Découper avec les séparateurs capturés

Découper a,b avec (,) donne ["a", ",", "b"]. Le séparateur capturé est conservé. Avec (,)|(;), les groupes non participants ajoutent des null ; les chaînes vides ne sont pas filtrées.

Comportement et limites

JavaScript du navigateur uniquement
Seul le JavaScript RegExp natif du navigateur s’exécute ici. Vérifiez PCRE et Python dans leur environnement cible. Les flags sont détectés ; le User-Agent du rapport n’est pas une version exacte du moteur.
Résultats vides et Unicode
Texte et motif vides sont valides. Le démarrage et Effacer restent en attente. Une recherche globale de largeur nulle avance par point de code avec u/v, sinon par unité UTF-16. Positions UTF-16 à partir de 0, fin exclue. Les indices de groupes nécessitent d ; une capture en lookbehind peut dépasser la correspondance entière.
Résultats complets avec limites
Limites en unités UTF-16 : texte 100000, motif 2000, remplacement 10000, sortie remplacée 1000000, rapport 4000000. Maximum 10000 éléments ; tout dépassement fait échouer le test entier. Délai : 2 secondes.
Conserver les chaînes
Le rapport JSON échappe les chaînes et conserve les surrogates isolés. TXT n’est proposé que pour une sortie remplacée avec Unicode bien formé. L’aperçu peut s’arrêter à 20000 unités UTF-16 ; l’export réussi reste complet.
Notes limitées et retour arrière
Notes lexicales limitées, sans analyse complète, IA ou diagnostic de performance. Une classe, un échappement inconnu ou une structure complexe rend tout le suffixe restant opaque. Seul un remplacement à jour, Unicode valide et limité à 100000 unités UTF-16 peut devenir l’entrée. Vérifiez puis appliquez ; le retour arrière restaure entrée, options et résultat.

Questions sur le Testeur regex

Comment limiter une capture trop gourmande ?

Une répétition gourmande essaie d’abord davantage de caractères. Sa forme paresseuse, comme +?, essaie moins de répétitions avant de poursuivre. Comparez les deux sur votre texte : les notes du Testeur regex ne constituent pas une preuve sémantique.

Une regex suffit-elle à valider un email ?

Une expression simple peut repérer une forme d’adresse, mais elle ne prouve ni l’existence d’une boîte ni sa propriété. L’exemple fourni sert à tester des correspondances ; adaptez-le au besoin et utilisez une vérification adaptée en production.

Pourquoi le même motif échoue-t-il dans un autre langage ?

JavaScript, Python et PCRE diffèrent sur les groupes, les échappements et Unicode. Ce testeur exécute uniquement le RegExp du navigateur. Conservez les flags et vérifiez de nouveau dans le moteur cible.

Un motif peut-il ralentir l'exécution ?

Oui, certaines entrées provoquent beaucoup de retours arrière. Chaque opération dispose d’un Worker arrêté après 2 secondes. Le test expire sans export partiel ; un résultat rapide ne garantit pas les performances sur d’autres textes.

Comment inclure plusieurs lignes dans la recherche ?

m applique ^ et $ aux limites de chaque ligne. s permet au point de traverser les retours à la ligne. Ce sont deux effets différents ; activez celui dont le motif a besoin, sans modifier le texte pour masquer le problème. Les entrées ne sont pas rognées. L’éditeur ou le presse-papiers peut normaliser les fins de ligne ; l’identité des octets n’est pas garantie.

Une autre question ?

Essayer le Testeur regex

Le Testeur regex propose des exemples de dates et de lettres Unicode à adapter à votre texte.

Vérifiez le rapport JSON complet avant de réutiliser le résultat dans votre code.

Par défaut, le test suit les modifications après 350 ms. Sans mode automatique, utilisez le bouton ou Ctrl/Cmd+Enter. Toute modification bloque immédiatement les exports périmés.