Texte et chaînes

Extracteur regexretrouver les valeurs et leur origine

Choisissez un type de motif, puis vérifiez chaque valeur et sa première ligne dans la source.

Extracteur regex

Texte de test

Résultat

Saisissez du texte ou appliquez un exemple.

Le motif et le texte sont traités dans un Worker local au navigateur, sans envoi au serveur.

Options

100 000 unités UTF-16 en entrée · motif de 2 000 unités · 10 000 candidats · 2 secondes. Tout dépassement annule le résultat.

Saisissez du texte ou appliquez un exemple.

Export complet. TXT sépare par LF. CSV ajoute une apostrophe aux valeurs de type formule ; JSON conserve les valeurs et les enregistrements multilignes.

Un extracteur regex est utile lorsque des coordonnées et des identifiants se perdent dans les commentaires d’un journal. La liste obtenue reste liée au texte de départ par ses numéros de ligne. Vous pouvez ainsi revenir au contexte avant de réutiliser un résultat.

Pourquoi utiliser cet extracteur regex ?

Garder une source, changer de liste

Cet extracteur regex permet de passer des emails aux URL, aux IP ou aux nombres sans remplacer le texte. Un motif personnalisé sert aux codes métier. Une seule catégorie est analysée à la fois : les chiffres contenus dans un lien ne polluent donc pas la liste des adresses.

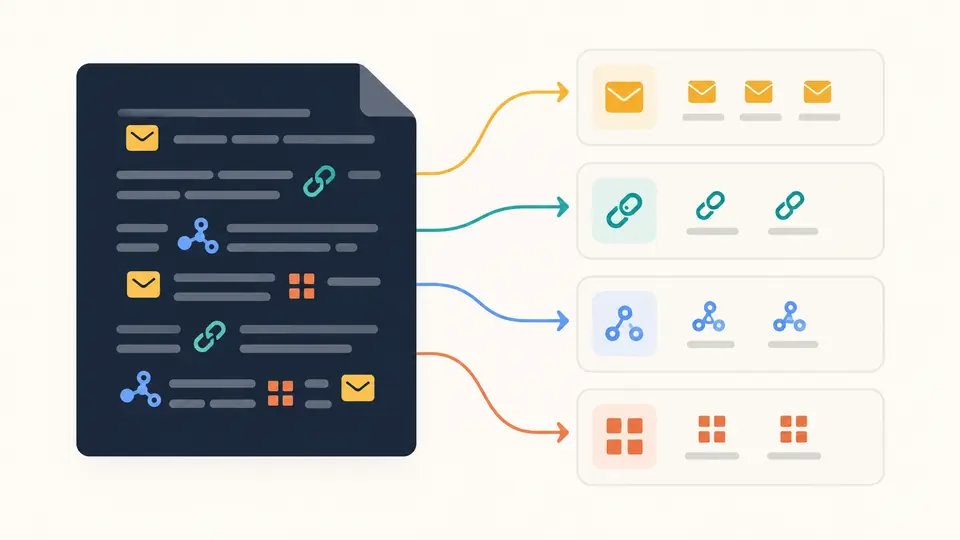
Un document mêlant plusieurs types de données alimente des listes symbolisées par une enveloppe, un lien, un réseau et des nombres.

Réduire les répétitions sans perdre la provenance

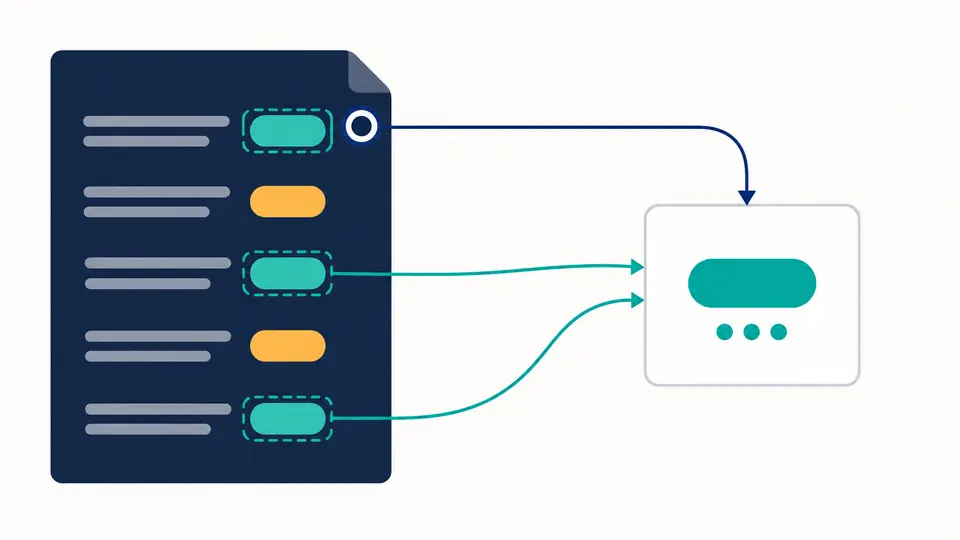
La déduplication conserve la première occurrence et additionne les suivantes. Désactivez-la pour retrouver chaque apparition dans son ordre initial. La casse et les différentes écritures IPv6 restent intactes, ce qui permet de distinguer une répétition exacte d’une simple ressemblance.

Des éléments répétés sont regroupés avec un lien vers la première ligne source et des points représentant les occurrences.

Définir la portée avant de sauvegarder

01

Vérifier le type choisi

Le mode initial concerne les emails. Changer de type conserve le texte. Exemple et Effacer ouvrent un aperçu indiquant les tailles avant et après remplacement. L’application réinitialise aussi les options ; Annuler la modification rétablit l’entrée et le résultat précédents.

02

Demander seulement le groupe utile

Avec ORD-(\d+), le groupe 1 fournit les chiffres et le groupe 0 le résultat complet. Les groupes nommés sont acceptés. g recherche toujours toutes les occurrences ; m change les ancres de ligne tandis que s autorise le point à couvrir les retours à la ligne.

03

Attendre la fin de la mise à jour

Le mode automatique attend 350 ms après une modification. Désactivez-le pour utiliser le bouton ou Ctrl/Cmd+Enter. Les exports restent désactivés tant que le résultat est périmé. L’affichage commence à 50 éléments ; la sauvegarde contient toujours la liste complète.

Des motifs prêts à utiliser et des groupes précis

Extraire des emails et extraire des URL

Les adresses ASCII courantes peuvent conserver leurs étiquettes avec un signe plus. Les liens HTTP(S) gardent requêtes et fragments. Les signes de ponctuation finaux et les parenthèses fermantes superflues sont retirés ; une paire équilibrée dans Topic_(part) reste dans le lien.

Préserver les nombres et les adresses réseau

Le mode IP vérifie les quatre octets IPv4 et reconnaît IPv6, y compris sa forme comprimée. Les valeurs -12.50, .75 ou 6.02e23 restent des chaînes. Aucune conversion en virgule flottante ne vient arrondir les grands entiers ni modifier leur écriture.

Choisir les groupes de capture

Les expressions régulières JavaScript peuvent renvoyer le résultat complet, un groupe numéroté ou un groupe nommé. La ligne indiquée est celle du début de la correspondance complète, même si la capture s’étend plus loin. CSV et JSON peuvent inclure cette ligne et le nombre d’occurrences.

Ce que la reconnaissance garantit

Une forme reconnue ne prouve pas une existence
Le motif email vise les adresses ASCII usuelles sans partie locale entre guillemets, avec un domaine contenant un point. Il ne couvre pas tous les cas RFC ou les adresses internationalisées. Seuls HTTP(S) sont reconnus comme liens ; aucune adresse n’est visitée et aucune délivrabilité n’est vérifiée.
Comparer sans réécrire
Les valeurs ne sont ni triées, ni converties en minuscules, ni normalisées en Unicode. Deux écritures IPv6 équivalentes restent distinctes. IPv4 refuse les zéros initiaux ; CIDR et zones ne sont pas interprétés. Les nombres utilisent des chiffres ASCII et un point : 1,234 produit deux valeurs, pas un décimal français.
Respecter la sémantique JavaScript
Saisissez le motif sans délimiteurs /. Le parcours global est permanent et les correspondances complètes ne se chevauchent pas. Les captures vides ou absentes sont ignorées et comptées. CRLF vaut un saut ; CR, LF et les séparateurs Unicode comptent aussi. PCRE, remplacement et filtrage de lignes ne sont pas proposés.
Refuser les résultats incomplets
Les limites sont de 100 000 unités UTF-16 en entrée, 2 000 dans le motif et 10 000 candidats avant déduplication. Les valeurs stockées totalisent au plus 1 000 000 unités, chaque export 4 000 000. Le Worker s’arrête après 2 secondes. Les substituts invalides sont rejetés, sans export tronqué ou périmé.
Tenir compte du format choisi
TXT relie les valeurs avec LF ; une capture multiligne peut donc occuper plusieurs lignes. JSON conserve les limites des enregistrements et les chaînes exactes. CSV cite toutes les cellules et ajoute une apostrophe devant les valeurs ressemblant à des formules. Préférez JSON pour éviter cet ajout. Aucun fichier ni historique d’entrée n’est géré.

Extracteur regex : questions fréquentes

Pourquoi mon motif ne trouve-t-il rien ?

Contrôlez le mode, la casse et le groupe demandé. Ne collez pas les délimiteurs / dans le champ du motif. Pour plusieurs lignes, m agit sur les ancres et s sur le point. Un groupe inexistant déclenche une erreur ; une capture vide est simplement comptée parmi les éléments ignorés.

Puis-je extraire directement le contenu d’un PDF ou de Word ?

Copiez d’abord le texte depuis l’application qui ouvre le document. Cet outil ne lit pas ces fichiers et ne fait pas de reconnaissance de caractères. Après copie, vérifiez qu’un retour à la ligne n’a pas coupé une adresse au milieu.

Quelle différence entre TXT, CSV et JSON ?

TXT contient les valeurs seules. CSV et JSON permettent d’ajouter la première ligne et le compteur. CSV adapte les valeurs pouvant devenir des formules dans un tableur. JSON préserve la chaîne exacte, y compris les retours à la ligne internes, sans ajouter de préfixe.

Peut-on extraire plusieurs types à la fois ?

Chaque exécution traite le type sélectionné. Changez de mode pour obtenir une autre liste à partir du même texte. Un motif personnalisé avec alternatives peut réunir plusieurs formes ; vérifiez alors que leur présence dans une liste commune correspond bien à votre besoin.

Quelle quantité de texte est acceptée ?

Collez jusqu’à 100 000 unités UTF-16 ; il n’y a pas de dépôt de fichier. La limite de 10 000 candidats intervient avant regroupement des doublons. Si le calcul dépasse une limite ou deux secondes, réduisez la portion du journal ou rendez le motif plus ciblé.

Une étape donne un résultat inattendu ?

Revenir à cet extracteur regex

Utilisez cet extracteur regex sur un extrait représentatif, vérifiez les lignes d’origine, puis enregistrez tous les résultats dans le format voulu.