Texte et octets

Convertisseur CRLFVérifier les changements invisibles

Uniformisez un texte ou plusieurs fichiers et contrôlez les octets réellement exportés.

Convertisseur CRLF

Entrée

UTF-8 ; BOM : aucun ; 0 octets. CRLF 0, LF 0, CR 0 ; NUL 0 ; saut final : non.

Résultat

Pas encore de résultat.

Le texte et les fichiers sont traités dans ce navigateur ; aucune donnée saisie n’est envoyée.

20 fichiers maximum : 2 MiB chacun, 16 MiB en entrée et 32 MiB en sortie au total.

Options de conversion

Un BOM reconnu est prioritaire. Le texte saisi est en UTF-8. Aucun encodage n’est déduit des NUL.

Saisissez du texte ou choisissez des fichiers.

Copier transmet du texte, pas l’encodage ni un BOM ajouté. Le téléchargement conserve les octets affichés.

BOM indique le préfixe réel. Après suppression d’une marque sur deux, un préfixe appartenant au texte peut subsister.

Un script peut sembler identique dans deux éditeurs et échouer à cause d’un CR supplémentaire. Le Convertisseur CRLF compte séparément les paires CRLF, les LF seuls et les CR seuls pour repérer les fins de ligne mixtes.

Le texte collé ne prouve pas l’encodage du fichier original. Choisissez les fichiers lorsque la signature ou l’ordre des octets importe. Le texte saisi est en UTF-8 ; les fichiers gardent l’encodage détecté ou explicitement choisi.

Pourquoi utiliser ce Convertisseur CRLF

Conserver chaque ligne

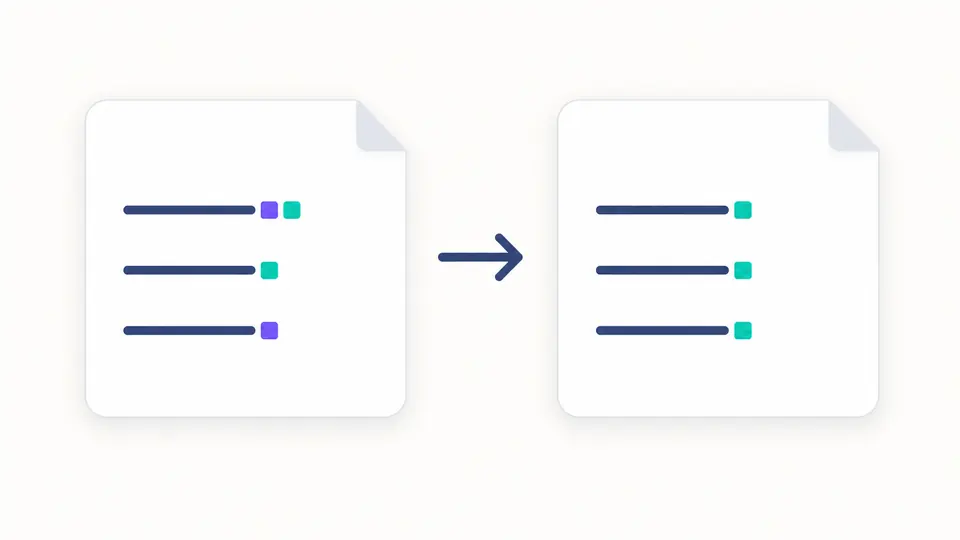
Le Convertisseur CRLF remplace les séparateurs existants sans nettoyer les espaces, tabulations ou lignes vides. Il conserve aussi la présence ou l’absence d’un saut final. Choisissez la conservation des fins de ligne pour modifier seulement le BOM.

Trois lignes de contenu restent identiques tandis que leurs marques de fin différentes deviennent uniformes

Séparer signature et contenu

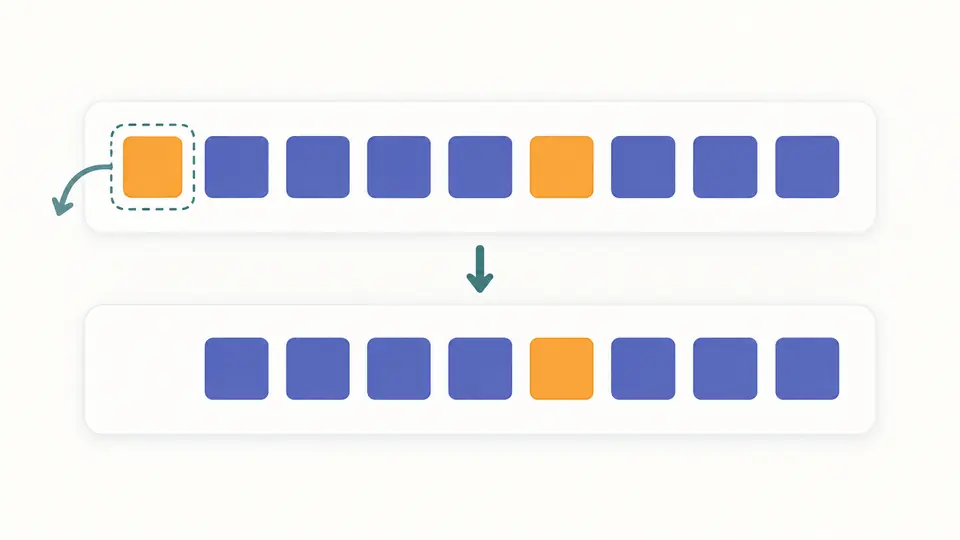
Le Convertisseur CRLF ne traite que la première signature comme un BOM. Un second U+FEFF ou celui du corps du texte reste présent. La comparaison hexadécimale indique précisément quels octets disparaissent.

La première marque d’une séquence d’octets disparaît tandis qu’une marque identique au milieu reste en place

Définir la source avant la destination

01

Lire les fichiers originaux

Sélectionnez au plus 20 fichiers puis vérifiez leur remplacement avant de l’appliquer. Un BOM détermine UTF-8 ou l’ordre UTF-16. Sans BOM, UTF-8 est utilisé ; indiquez UTF-16LE/BE ou Windows-1252 si vous connaissez la source.

02

Distinguer trois réglages

Par défaut : LF, BOM et encodage conservés. Passer de CRLF en LF ne crée pas de saut final. Pour changer un fichier en UTF-8, choisissez cette sortie puis cochez la confirmation. Modifier les données ou les options annule cette confirmation.

03

Examiner les octets puis exporter

L’aperçu s’étend par 10 000 caractères ou 256 octets ; le téléchargement reste complet. Le mode automatique attend 350 ms. Désactivez-le pour utiliser Convertir ou Ctrl/Cmd+Entrée. Toute modification bloque immédiatement l’export du résultat périmé.

Voir ce que l’éditeur masque

Compter sans doubler CRLF

Pour convertir les fins de ligne, une paire CRLF compte comme un seul séparateur. Les statistiques indiquent aussi les NUL et le saut final. U+0085, U+2028 et U+2029 restent du contenu.

Gérer le BOM adapté

UTF-8 et UTF-16LE/BE reçoivent leur signature respective. La suppression ne touche qu’un BOM initial. Windows-1252 n’en possède pas : pour ajouter une signature, il faut confirmer le passage en UTF-8.

Refuser les caractères de remplacement

UTF-8 mal formé, longueur UTF-16 impaire ou surrogate isolé provoquent une erreur. Windows-1252 suit la table WHATWG, valeurs C1 réversibles comprises. Aucun nettoyage des espaces, normalisation Unicode ou calcul de formule n’a lieu.

Produire un lot entier

Chaque BOM est détecté séparément avec des options communes. Les noms sûrs et numérotés évitent les collisions dans le ZIP. Un seul échec bloque tout le lot ; aucun fichier omis ne passe pour une réussite complète.

Limites et garanties de contenu

Un budget mémoire explicite
Chaque entrée est limitée à 2 MiB ; le lot à 20 fichiers et 16 MiB ; la sortie cumulée à 32 MiB. Un dépassement échoue sans tronquer. Les fichiers vides ou contenant uniquement un BOM sont acceptés.
Des encodages précis
UTF-8, UTF-16LE/BE et Windows-1252 sans BOM sont pris en charge. UTF-32 est détecté puis refusé. Pas de GBK, Shift_JIS, détection universelle, réparation binaire, lecture Office ou import d’archive. Un mauvais choix mono-octet peut rester réversible mais illisible.
Les guillemets ne protègent pas les sauts
Le contenu CSV ou le code n’est pas analysé : les vrais sauts à l’intérieur changent aussi. Aucun saut final n’est ajouté ni retiré. Espaces, tabulations, lignes vides, NUL et U+FEFF internes sont conservés.
Copier ne transfère pas l’encodage
Une application peut normaliser les fins avant le collage. L’éditeur garde les caractères reçus mais ne recrée pas les octets perdus. Copier transmet le texte sans signature de fichier ajoutée. Téléchargez pour obtenir les octets exacts.
Vérifier les remplacements
Exemple, effacement et remplacement des fichiers affichent d’abord les quantités concernées. Annuler restaure les deux entrées, options, mode automatique, confirmation et résultat. Changer d’entrée ne supprime rien. Les fichiers originaux ne sont jamais écrasés.

Questions sur le Convertisseur CRLF

Pourquoi les systèmes utilisent-ils des fins différentes ?

Les conventions historiques ont laissé CRLF dans de nombreux échanges Windows, LF dans les environnements Unix et CR dans certains anciens formats. Le Convertisseur CRLF propose LF par défaut. La contrainte du logiciel destinataire reste prioritaire.

Pourquoi choisir le fichier plutôt que coller son texte ?

Le trajet par le presse-papiers peut déjà avoir supprimé les CR. L’éditeur conserve CRLF et CR reçus par le collage, sans pouvoir retrouver ce qui a disparu. Le fichier donne accès aux octets originaux.

Quand ces différences provoquent-elles des problèmes ?

Elles peuvent multiplier les différences Git ou laisser un CR indésirable dans un script shell. Comparez les compteurs et l’hexadécimal, puis adaptez le format à l’outil qui lira le fichier.

Comment uniformiser un mélange de CRLF et LF ?

Choisissez un format cible pour l’ensemble du fichier. La conversion ne se limite pas aux lignes visuellement suspectes. Les sauts réels dans les champs CSV entre guillemets sont également concernés.

Git peut-il automatiser ces conversions ?

Les attributs text/eol et core.autocrlf contrôlent le traitement dans l’index et la copie de travail. Un fichier téléchargé peut donc changer de nouveau lors d’un checkout. Cette page ne modifie pas la configuration Git.

Des octets inattendus ?

Essayer le Convertisseur CRLF sur un exemple

Comparez les séparateurs et les premiers octets avec les attentes du logiciel destinataire avant de télécharger.