01
Leia os arquivos originais
Selecione até 20 arquivos e confira a substituição antes de aplicar. O BOM determina UTF-8 ou a ordem de UTF-16. Sem BOM, o padrão é UTF-8; escolha UTF-16LE/BE ou Windows-1252 se souber a codificação de origem.
Texto e bytes
Padronize texto ou vários arquivos e examine os bytes sem trocar a codificação sem confirmação.
UTF-8; BOM: nenhum; 0 bytes. CRLF 0, LF 0, CR 0; NUL 0; quebra final: não.
Ainda não há resultado.
Texto e arquivos são processados neste navegador; nenhum dado de entrada é enviado.
Até 20 arquivos: 2 MiB cada, 16 MiB de entrada e 32 MiB de saída no total.
Digite texto ou escolha arquivos.
Copiar transfere texto, não a codificação nem um BOM adicionado. O download mantém os bytes mostrados.
BOM mostra o prefixo real. Se havia duas marcas, remover uma pode deixar um prefixo pertencente ao texto restante.
Um script pode parecer igual em dois editores e falhar por um CR a mais. O Conversor de quebras de linha conta pares CRLF, LF isolados e CR isolados separadamente, mostrando quebras de linha misturadas antes da conversão.
O texto colado não comprova a codificação do arquivo original. Escolha arquivos para conferir a assinatura e a ordem dos bytes. A entrada de texto usa UTF-8; os arquivos mantêm a codificação detectada ou escolhida explicitamente.
O Conversor de quebras de linha troca apenas separadores existentes. Espaços, tabulações, linhas vazias e a presença de uma quebra final ficam como estavam. Preserve os finais para alterar somente o BOM.
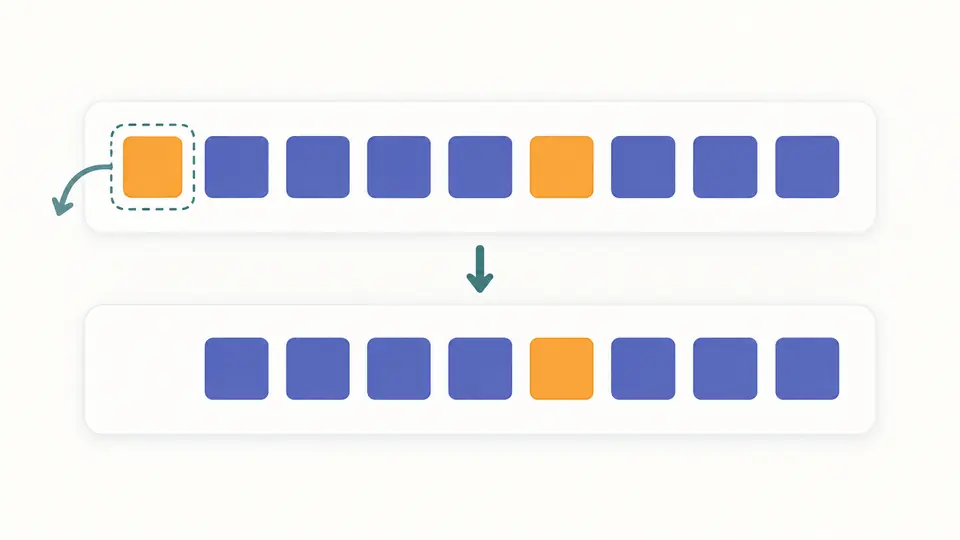
O Conversor de quebras de linha considera apenas a primeira assinatura como BOM. Um segundo U+FEFF ou um caractere igual no meio continua sendo conteúdo. A comparação hexadecimal revela quais bytes foram removidos.
Selecione até 20 arquivos e confira a substituição antes de aplicar. O BOM determina UTF-8 ou a ordem de UTF-16. Sem BOM, o padrão é UTF-8; escolha UTF-16LE/BE ou Windows-1252 se souber a codificação de origem.
O padrão é LF, mantendo BOM e codificação. Mudar CRLF para LF não acrescenta uma quebra final. Para recodificar em UTF-8, escolha essa saída e marque a confirmação. Alterar dados ou opções de conversão desmarca a confirmação.
A prévia cresce de 10.000 em 10.000 caracteres ou de 256 em 256 bytes. O download contém tudo. O modo automático aguarda 350 ms; desligue-o para usar Converter ou Ctrl/Cmd+Enter. Editar bloqueia imediatamente a exportação antiga.
CRLF conta como um único separador. As estatísticas também mostram NUL e a presença da quebra final. U+0085, U+2028 e U+2029 são mantidos como conteúdo, sem virar finais de linha.
BOM UTF-8 e as assinaturas UTF-16LE/BE são tratados conforme a codificação. Remover afeta só uma assinatura inicial. Windows-1252 não tem BOM; para adicionar um, é necessário confirmar a mudança para UTF-8.
UTF-8 inválido, UTF-16 com quantidade ímpar de bytes e substitutos isolados geram erro. Windows-1252 segue o mapeamento WHATWG, inclusive valores C1 reversíveis. Não há limpeza de espaços, normalização Unicode ou execução de fórmulas.
O BOM é detectado por arquivo, com opções comuns ao lote. Nomes seguros e numerados evitam colisões no ZIP. Se um arquivo falhar, todo o lote fica sem exportação; nenhum item é omitido como se tudo tivesse dado certo.
São convenções históricas: CRLF é frequente em fluxos Windows, LF em sistemas Unix e CR em formatos antigos. O Conversor de quebras de linha começa com LF, mas a exigência do programa que receberá o arquivo vem primeiro.
A área de transferência pode remover CR antes da chegada ao editor. Os CRLF e CR entregues pelo evento de colagem são mantidos, mas não se recupera o que já foi alterado. O arquivo permite conferir os bytes originais.
Quando o Git mostra diferenças em quase todas as linhas ou um script shell recebe CR inesperado. Confira as contagens e os bytes e escolha o formato exigido pelo destino.
Escolha um formato para todos os separadores. A conversão não fica restrita às linhas que parecem suspeitas. As quebras reais em campos CSV entre aspas também mudam, então confira a exigência do formato.
Os atributos text/eol e core.autocrlf controlam o tratamento no índice e na cópia de trabalho. Um arquivo baixado pode voltar a mudar durante o checkout. Esta página não altera configurações do repositório.
Encontrou bytes inesperados?
Compare as contagens e os primeiros bytes com os requisitos do programa de destino antes de baixar os arquivos.