01
Confira a prévia antes de substituir
A entrada começa vazia. Exemplo e Limpar exibem as quantidades de unidades UTF-16 antes e depois. Aplicar confirma a mudança; em seguida, há uma única ação para desfazer a substituição.
Entenda o tamanho do seu texto
Cole seu texto e confira palavras, grafemas, bytes e frequências no mesmo painel.
A análise acontece no seu navegador. O texto não é enviado a um servidor para fazer os cálculos.
As medidas de caracteres incluem toda a entrada, com espaços e pontuação. UTF-8 mede o texto atual do editor, sem adicionar BOM.
0.0000
Amostras: 0 · Entradas distintas: 0
H = −Σ p log₂(p), em bits por amostra filtrada. p usa as amostras retidas, não o total de grafemas. O cálculo usa toda a distribuição: mudar apenas a ordem mantém a entropia. Não mede segurança de senhas nem comprova aleatoriedade.
O percentual de palavras usa todos os segmentos isWordLike como denominador. Para caracteres, entram apenas grafemas com letras, marcas, números ou símbolos Unicode; pontuação pura, espaços e controles ficam fora da amostra e do denominador.
Idioma efetivo da análise: Indisponível
Nenhum item para exibir.
Digite um texto ou experimente o exemplo.
Um limite de formulário pode contar de um jeito, enquanto uma integração mede bytes. O contador de caracteres separa unidades UTF-16, pontos de código e grafemas para você identificar qual medida corresponde à sua necessidade.
O contador de palavras e o contador de linhas complementam a análise de extensão. Para investigar repetição, as tabelas mostram ocorrências e percentuais; a entropia descreve a distribuição dos caracteres selecionados, sem avaliar a qualidade da escrita.
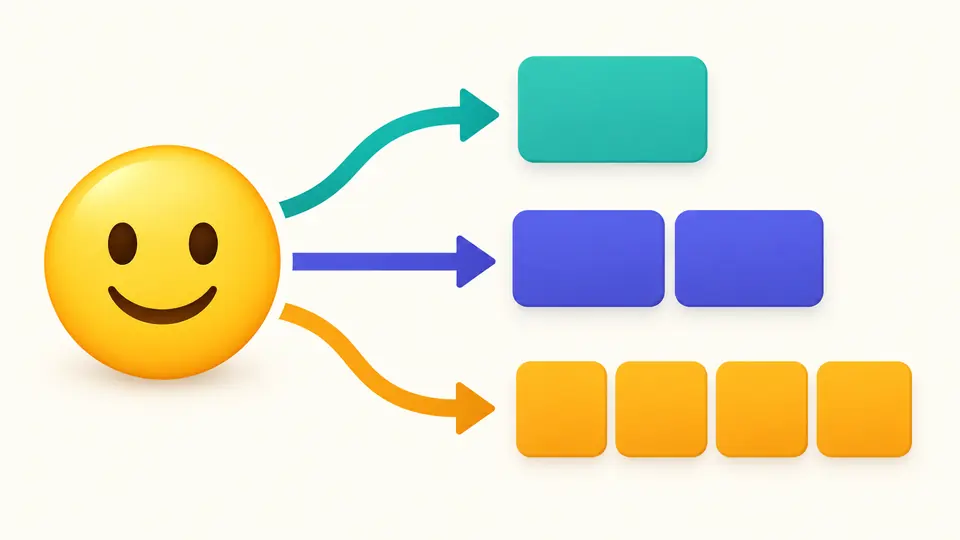
O contador de caracteres mostra a diferença entre aparência e codificação. Um emoji simples de rosto sorridente ocupa um grafema, duas unidades UTF-16 e quatro bytes UTF-8. Emojis compostos podem reunir ainda mais pontos de código em um único grafema.
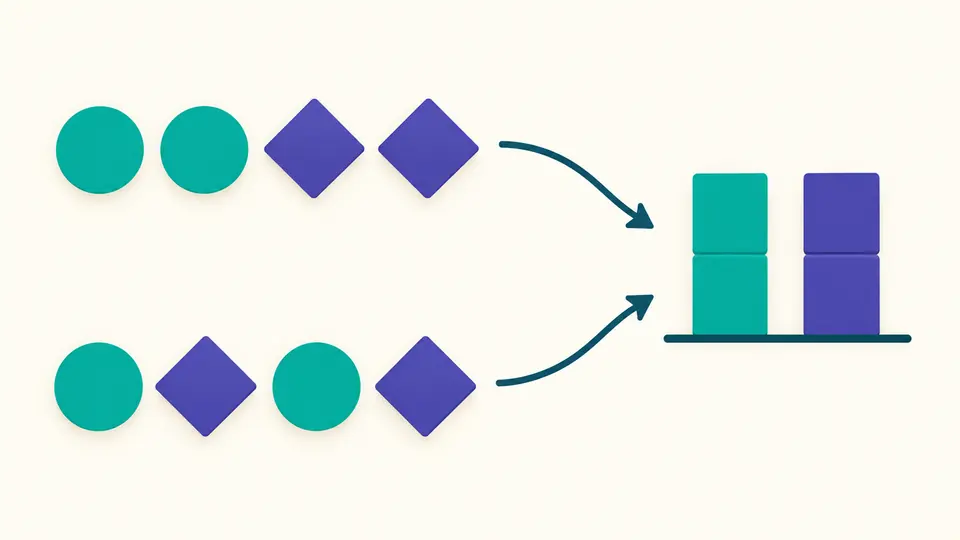
Sequências com as mesmas quantidades de cada símbolo produzem a mesma entropia, mesmo em outra ordem. A medida considera a distribuição completa de caracteres filtrados, incluindo as entradas ainda não exibidas na tabela.
A entrada começa vazia. Exemplo e Limpar exibem as quantidades de unidades UTF-16 antes e depois. Aplicar confirma a mudança; em seguida, há uma única ação para desfazer a substituição.
O padrão é inglês, mesmo nesta página em português. A contagem automática espera 350 ms após uma alteração. Para escolher o momento do cálculo, desative a opção e use Contar ou Ctrl/Cmd+Enter.
A lista começa com 50 entradas e permite mostrar mais 50 por vez. Copiar e baixar incluem todas as entradas em JSON. Alterar o texto ou as opções suspende a exportação até a próxima análise atualizada.
Consulte palavras, linhas e parágrafos ao lado de unidades UTF-16, pontos de código, grafemas e bytes UTF-8. A referência é sempre o conteúdo atual do editor.
A tabela de palavras mostra quantas vezes cada segmento ocorre e sua participação no total de palavras. Isso ajuda a localizar repetições sem remover palavras comuns ou alterar o texto.
Por padrão, cada segmento é convertido em minúsculas conforme o idioma escolhido para formar as chaves de frequência. A opção de diferenciar a caixa separa essas entradas e preserva a escrita original.
Cada item da tabela de caracteres traz sua sequência U+. Use-a para distinguir acentos combinados de caracteres pré-compostos que parecem iguais na tela.
Sim. As medidas gerais incluem espaços, tabulações, quebras de linha e pontuação, de acordo com a unidade indicada. A tabela de frequência usa um filtro próprio e não deve ser confundida com a contagem geral sem espaços.
Depende da unidade. Um rosto sorridente simples ocupa duas unidades UTF-16, mas um grafema. Famílias e outras combinações podem reunir vários pontos de código em um grafema. Compare sempre a unidade que o formulário ou sistema de destino utiliza.
Escolha o idioma do conteúdo nas opções; o padrão é inglês. Português, chinês, japonês e outros idiomas disponíveis usam a segmentação de Intl.Segmenter. A língua da interface não altera essa opção automaticamente.
Não é garantido. Esses editores podem adotar outras regras para palavras e incluir partes do documento que não foram coladas aqui. Confira a mesma entrada, a unidade e o idioma de análise ao comparar.
A ferramenta calcula as estatísticas localmente, sem enviar a entrada para análise em um servidor. Não há salvamento de rascunho nem sincronização. Para guardar as estatísticas, use a cópia ou o download do JSON.
Algum resultado ficou difícil de interpretar?
Use o contador de caracteres para conferir a unidade certa e guardar um relatório completo antes de enviar seu texto ao destino final.