01
先确定分析语言
默认英语分词不随界面语言变化。中文段落可主动选择中文,并在频率区域检查实际生效的语言;词边界不保证与 Word 一致。
文本与字符串
比较字符长度、分词结果与频率分布。
文本仅在当前浏览器内处理,不会上传。
UTF-16 单位、代码点、字素及 UTF-8 字节均包含空白与标点。字素按完整文字簇计数,各项单位不同,不能直接互换。
0.0000
样本数:0;不同键:0
H = −Σ p log2(p),单位为比特/过滤后字符样本,分母不是总字素数,使用完整分布。同频率而不同排列的文本熵相同;它不代表密码强度,也不能证明随机性。
字频保留含 Unicode 字母、标记、数字或符号的字素,排除纯标点、空白和控制字符;百分比分母为过滤后的样本总数。词频百分比以全部计入的词语为分母。
实际分词语言:不可用
暂无可计入的词语或字符。
输入文本开始统计;空输入各项为零。
写论文摘要、表单说明或中英文混合文案时,字数统计的“字”可能指不同单位。先区分词语、字素和编码长度,再与接收方的要求比较,能解释同一段文本为什么出现多个数字。
字符数统计与字节数计算解决的不是同一个问题。页面保留原文,另列词频统计和字频分布,方便检查重复用词,也能观察组合音标与表情符号的表示差异。
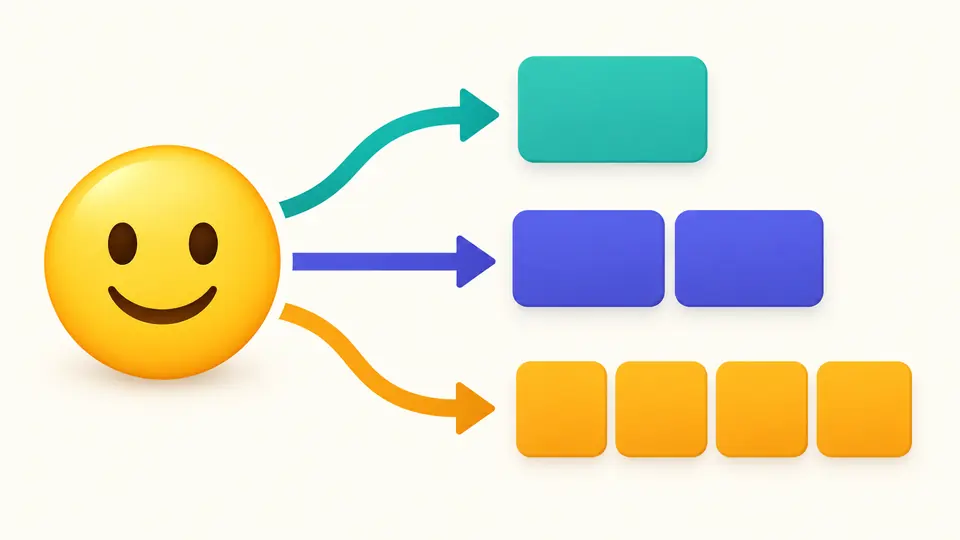
字数统计将一个普通笑脸分别记为一个字素、两个 UTF-16 单位和四个 UTF-8 字节。核对数据库字段或表单限制时,先确定限制使用哪个单位。
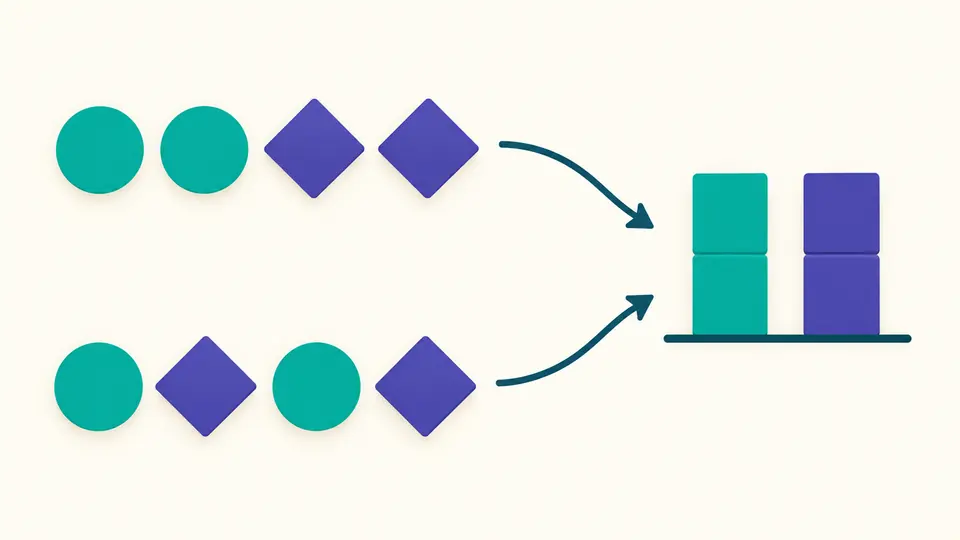
相同符号只改变排列顺序,出现次数与熵不会改变。字频表说明重复情况,无法单靠这个数字判断文章质量、密码强度或生成方式。
默认英语分词不随界面语言变化。中文段落可主动选择中文,并在频率区域检查实际生效的语言;词边界不保证与 Word 一致。
自动统计在停止编辑约 350 毫秒后运行。关闭后显示统计按钮,也可按 Ctrl/Cmd+Enter;修改输入或选项后,旧报告暂不可复制。
示例与清空会先显示替换前后长度,应用才生效;撤销恢复一次完整统计快照。频率先显示 50 项,可逐批增加,JSON 始终包含全部结果。
同时呈现 UTF-16 单位、代码点、字素、字节、词语、行数和段落,不用平均字长估算词数。
只统计浏览器识别为词语的片段,不删除停用词。大小写开关同时影响词频与字频的合并方式。
识别 CRLF、CR、LF、U+2028 与 U+2029;CRLF 作为一个分隔符,末尾换行另计空行。
字频条目附有 U+ 代码点序列,方便分辨看起来相近的符号与组合标记。
基础长度的代码单元、代码点、字素和字节都包含标点与空白。字频另有过滤规则,纯标点不进入该样本,不能把字频样本数当成总字数。
不保证。Word 有自己的字数口径,本工具按浏览器词段统计,并单列代码点和字素。比较之前应确认所选语言及接收方究竟要求字数、词数还是字符数。
词频来自 Intl.Segmenter 的词语片段,按全部词语次数计算占比,不删除停用词。默认合并大小写,浏览器词典版本会影响中文分词。
字符描述文字单位,字节描述编码长度。普通汉字通常占三个 UTF-8 字节,而一个普通笑脸占四个字节;页面分列各项,避免把储存长度当成文字个数。
当前上限为 100000 个 UTF-16 单位。超限时请自行分段,不会自动截取前半段。分段后各段熵不能简单相加得到全文熵。
发现某个分词或计数边界值得核对?