01
한국어 분석을 직접 선택
화면이 한국어여도 분석 기본값은 영어입니다. 분석 언어를 고른 뒤 빈도 영역의 실제 로케일을 확인하세요. 단어 경계는 브라우저의 언어 데이터에 따릅니다.
텍스트와 문자열
텍스트 길이와 단어 경계, 반복 빈도를 함께 살펴보세요.
텍스트는 이 브라우저에서 처리하며 업로드하지 않습니다.
UTF-16 단위, 코드 포인트, 자소 군집, UTF-8 바이트에는 공백과 문장 부호가 포함됩니다. 자소 군집은 하나로 묶인 문자 단위를 세므로 각 수치는 서로 다른 단위를 나타냅니다.
0.0000
표본: 0 · 서로 다른 키: 0
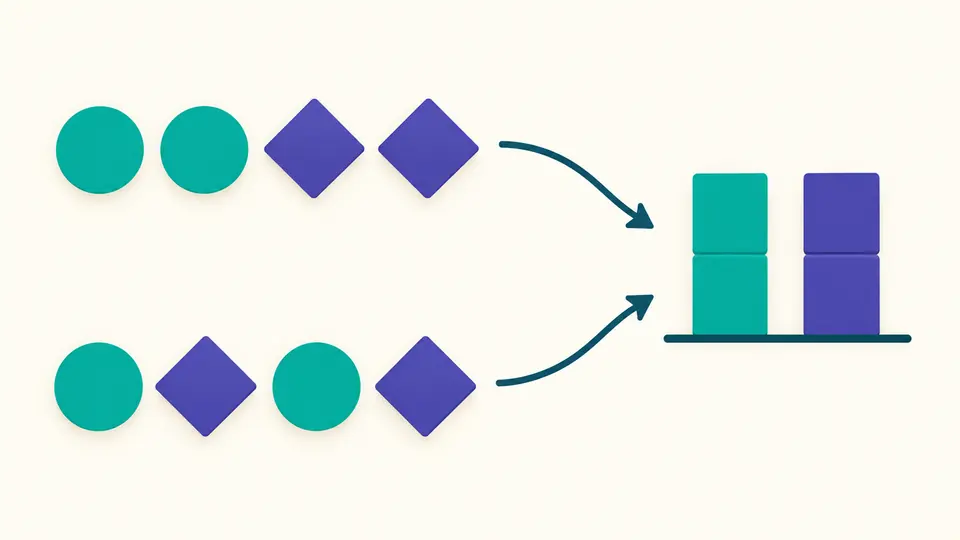
H = −Σ p log2(p), 단위는 필터링된 문자 표본당 비트입니다. 분모는 전체 자소 군집 수가 아닙니다. 전체 분포를 사용하며 빈도가 같으면 순서가 달라도 값이 같습니다. 비밀번호 강도나 무작위성의 증명이 아닙니다.
문자 빈도는 Unicode 문자·결합 표지·숫자·기호가 들어 있는 자소 군집을 포함합니다. 문장 부호, 공백, 제어 문자만 있는 군집은 제외하며 비율의 분모는 필터링 후 표본 수입니다. 단어 비율은 단어로 집계된 전체 구간 수가 기준입니다.
실제 분절 로케일: 사용 불가
집계할 항목이 없습니다.
텍스트를 입력하세요. 빈 입력은 모두 0입니다.
자기소개서 제출 화면의 제한이 글자인지 바이트인지 먼저 확인하세요. 글자수 세기는 같은 문장을 여러 단위로 보여 주므로, 눈에 보이는 글자 수와 인코딩 길이가 다른 이유를 확인할 수 있습니다.
단어 수는 공백만으로 나누지 않고 브라우저의 언어별 분절을 사용합니다. 빈도 표에서는 반복되는 단어와 기호를 살펴볼 수 있으며, 보고서에는 어떤 언어와 기준으로 계산했는지도 기록됩니다.
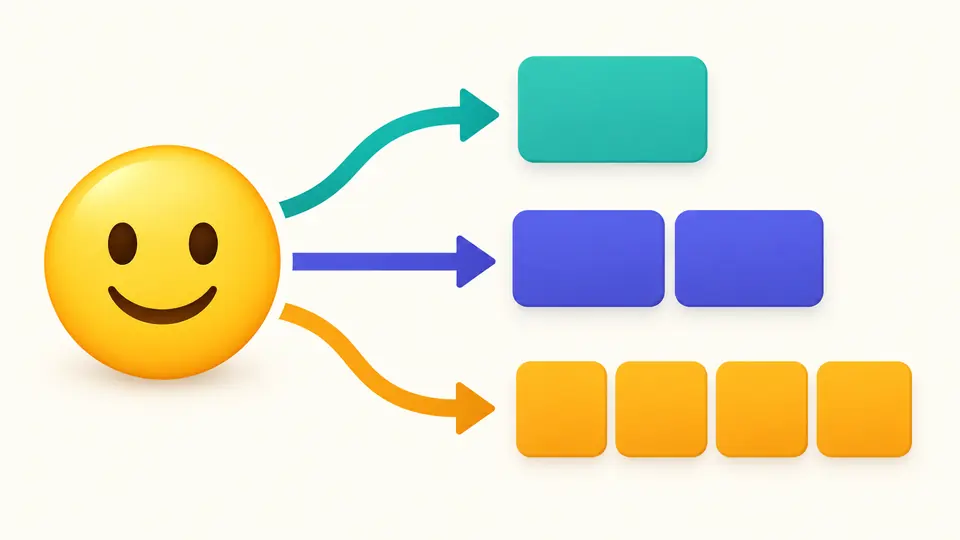
글자수 세기에서 보통의 웃는 이모지 하나는 자소 군집 1개, UTF-16 단위 2개, UTF-8 바이트 4개로 나옵니다. 입력칸의 제한이 어느 단위인지 알아야 알맞은 수치를 고를 수 있습니다.
같은 기호를 재배열해도 빈도와 엔트로피는 그대로입니다. 이 값은 반복 분포를 설명할 뿐, 문장이 좋아졌는지 또는 비밀번호가 추측하기 어려운지는 알려 주지 않습니다.
화면이 한국어여도 분석 기본값은 영어입니다. 분석 언어를 고른 뒤 빈도 영역의 실제 로케일을 확인하세요. 단어 경계는 브라우저의 언어 데이터에 따릅니다.
자동 집계는 마지막 수정 후 350밀리초 뒤 실행됩니다. 끄면 집계 버튼이 보이며 Ctrl/Cmd+Enter도 사용할 수 있습니다. 입력이나 옵션을 바꾸면 내보내기가 잠시 비활성화됩니다.
예제와 지우기는 먼저 변경 전후 길이를 보여 줍니다. 적용 후에는 한 번 실행 취소할 수 있습니다. 표는 50개씩 더 보지만 JSON 보고서에는 처음부터 모든 항목이 들어갑니다.
UTF-16 단위, 코드 포인트, 자소 군집, UTF-8 바이트 계산과 단어·줄·문단 집계를 따로 확인합니다. 평균 글자 길이로 단어 수를 추정하지 않습니다.
단어로 인식한 구간을 모두 셉니다. 대소문자 구분 옵션은 단어와 문자 빈도에 함께 적용됩니다.
CRLF를 하나의 구분자로 처리하고 CR, LF, U+2028, U+2029도 인식합니다. 끝에 구분자가 있으면 마지막 빈 줄이 추가됩니다.
문자 빈도에는 U+ 코드 포인트 목록이 붙습니다. 겉모양이 비슷한 기호나 결합 표지가 다른지 확인하는 데 도움이 됩니다.
인코딩 방식이 다르기 때문입니다. 완성된 한글 음절은 보통 UTF-8에서 3바이트입니다. 이 도구는 UTF-8만 계산하므로 EUC-KR을 쓰는 제출 화면의 수치와 같지 않을 수 있습니다.
모집 요강의 기준을 따르세요. 이 도구의 기본 길이는 공백 포함이며 별도 공백 제외 총계는 없습니다. 문자 빈도 표본은 문장 부호 등도 제외하므로 이를 공백만 뺀 글자 수로 사용하면 안 됩니다.
기본 문자 길이와 UTF-8 바이트에 모두 포함됩니다. CRLF는 두 코드 단위와 두 바이트지만 줄을 나눌 때는 한 구분자입니다. 탭은 줄 수를 늘리지 않습니다.
보통의 웃는 이모지는 자소 군집 1개, 코드 포인트 1개, UTF-16 단위 2개, UTF-8 바이트 4개입니다. 가족 이모지처럼 여러 코드 포인트가 한 군집을 이루는 경우도 있습니다.
아니요. 계산은 브라우저 메모리에서 실행하고 입력을 업로드하거나 초안으로 저장하지 않습니다. 사용자가 복사하거나 다운로드한 보고서에는 통계와 빈도 키가 포함됩니다.
단어 경계나 계산 결과에 의견이 있나요?