01
Проверьте замену перед применением
Редактор изначально пуст. Пример и Очистить сначала показывают длину до и после в единицах UTF-16. Текст меняется только после применения; затем замену можно отменить один раз.
Длина текста в понятных единицах
Вставьте текст и выберите язык анализа, чтобы проверить объём, частоты и байты UTF-8.
Расчёты выполняются в браузере. Исходный текст не отправляется на сервер для анализа.
Общие показатели символов учитывают весь ввод, включая пробельные знаки и пунктуацию. Байты UTF-8 относятся к текущему тексту редактора без добавления BOM.
0.0000
Элементов в выборке: 0 · Различных записей: 0
H = −Σ p log₂(p), бит на отобранный элемент. Знаменатель p — размер отфильтрованной выборки, а не общее число графем. Используется всё распределение: перестановка при тех же частотах не меняет энтропию. Это не оценка стойкости пароля и не доказательство случайности.
Доля слова рассчитывается от всех сегментов isWordLike. Доля символа — от графем с буквами, метками, числами или символами Unicode. Графемы только из пунктуации, пробельных или управляющих знаков исключены вместе с их вкладом в знаменатель.
Фактический язык анализа: Недоступно
Нет элементов для отображения.
Введите текст или откройте пример.
При подготовке текста для формы важно понять, что именно ограничено: видимые знаки, единицы UTF-16 или байты. Счётчик символов выводит эти показатели отдельно, поэтому различия из-за эмодзи и составных букв можно увидеть сразу.
Подсчёт строк и абзацев помогает проверить структуру, а счётчик слов — объём содержания. Частоты символов и слов показывают повторения. Исходная строка при анализе не исправляется и не нормализуется, поэтому внешне похожие записи могут остаться разными элементами.
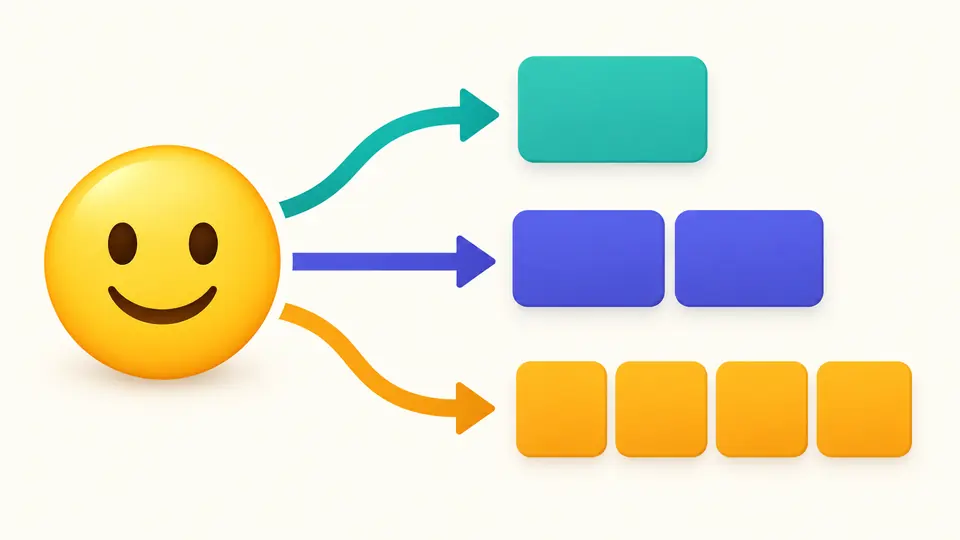
Счётчик символов позволяет проверить разницу на простом улыбающемся эмодзи: одна графема, две единицы UTF-16 и четыре байта UTF-8. Это помогает выбрать подходящий показатель для технического ограничения и не принять байты за видимые знаки.
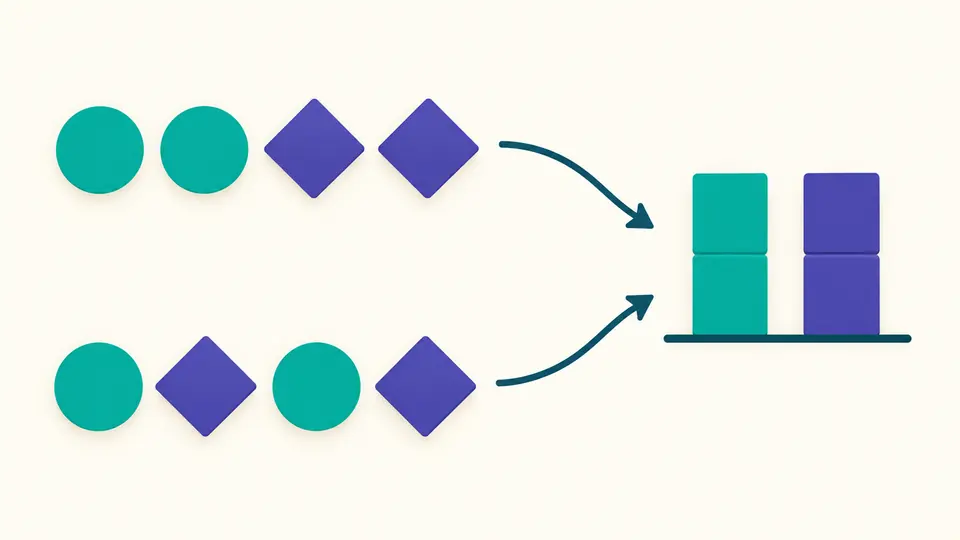
Порядок символов может полностью измениться, а распределение остаться прежним. Энтропия Шеннона в этом случае не меняется. В расчёт входят все отобранные символы, в том числе записи за пределами видимой части таблицы.
Редактор изначально пуст. Пример и Очистить сначала показывают длину до и после в единицах UTF-16. Текст меняется только после применения; затем замену можно отменить один раз.
Начальное значение — английский, даже на русской странице. Автоматический расчёт запускается через 350 мс после последнего изменения. В ручном режиме используйте Подсчитать или Ctrl/Cmd+Enter.
В таблице сначала 50 записей; следующие добавляются по 50. В JSON всегда входят все записи. Изменение текста или настроек делает статистику устаревшей и блокирует экспорт до нового расчёта.
Слова, строки и абзацы дополняют единицы UTF-16, кодовые точки, графемы и байты UTF-8. Все показатели относятся к текущей строке редактора.
В число слов попадают сегменты, отмеченные Intl.Segmenter как isWordLike. Фактически применённый язык указан рядом с таблицей, что помогает проверять различия между средами.
По умолчанию ключи частот переводятся в нижний регистр по выбранному языку. Можно разделить варианты написания, включив учёт регистра; исходный текст и его базовые размеры не меняются.
Рядом с каждым элементом символьной таблицы видна последовательность U+. Так проще различить готовую букву с диакритикой и букву с отдельной комбинируемой меткой.
Да. Общие показатели включают пробелы, табуляцию, переводы строк и пунктуацию в соответствующих единицах. Таблица частот использует отдельный фильтр и не является общим счётчиком без пробелов.
Считаются сегменты Intl.Segmenter с признаком isWordLike для выбранного языка. Деление не ограничивается пробелами. Отдельная пунктуация не считается словом, а обработка дефисов и других границ зависит от данных браузера.
У пустого ввода ноль строк. В непустом тексте разделителями служат CRLF, CR, LF, U+2028 и U+2029, причём CRLF считается одним разделителем. Перенос в конце добавляет пустую последнюю строку. Автоматический перенос по ширине редактора число строк не меняет.
Да, можно выбрать русский и другие доступные языки анализа. Сегментация выполняется средствами Intl.Segmenter, поэтому точные границы зависят от языка и версии данных браузера. Совпадение с Word или лингвистическим эталоном не гарантируется.
Инструмент не сохраняет черновики и не отправляет текст на сервер для вычислений. Данные обрабатываются в браузере. Если нужно оставить статистику, скопируйте или скачайте JSON до закрытия страницы.
Нужна ясность по конкретному результату?
Счётчик символов поможет проверить единицы измерения и частоты: вставьте текст, выберите его язык и сохраните полный отчёт.