01
日本語の解析を選ぶ
初期値は英語です。日本語の文章なら解析言語を切り替え、頻度欄の実際のロケールを確認します。ブラウザの辞書が単語境界を決めます。
テキスト・文字列
長さ、単語の区切り、出現頻度を同じ入力から調べます。
テキストはこのブラウザ内で処理され、アップロードされません。
UTF-16単位、コードポイント、字素、UTF-8バイト数には空白と句読点を含みます。字素は文字のまとまりを数えるため、それぞれの単位は異なります。
0.0000
サンプル数:0・異なるキー:0
H = −Σ p log2(p)。単位は除外後の文字サンプル当たりのビットで、分母は総字素数ではありません。全分布を使い、頻度が同じなら並び順が違っても同じ値です。パスワードの強度やランダム性の証明ではありません。
文字頻度にはUnicodeの文字、結合マーク、数字、記号を含む字素を採用します。句読点のみ、空白のみ、制御文字のみの字素は除外し、割合の分母は除外後の総数です。単語の割合は数えた全単語が分母です。
実際の分割ロケール:利用不可
集計対象がありません。
テキストを入力してください。空入力はゼロです。
レポートの文字数カウントでは、提出先が空白や改行を含めるかによって使う数字が変わります。このページは見た目のまとまりと符号化の長さを分け、何を数えた値なのか確認できるようにしています。
単語数は空白の数から推定せず、ブラウザの言語別分割を利用します。文章中の繰り返しは頻度表で確認でき、保存する報告には画面の表示件数にかかわらず全件が入ります。
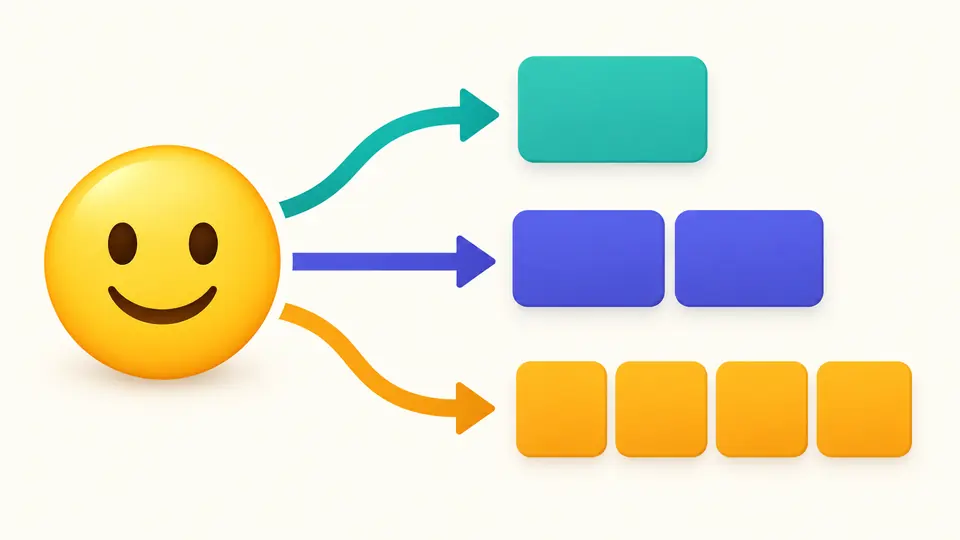
文字数カウントでは、普通の笑顔の絵文字が1字素、2 UTF-16単位、4 UTF-8バイトになります。見た目がひとつでも、入力欄が使う単位によって消費量は変わります。
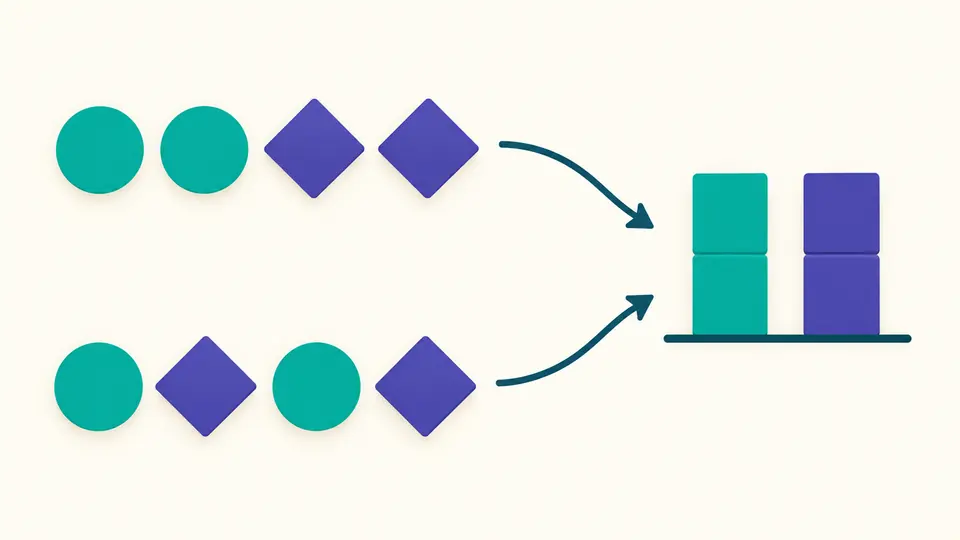
同じ記号を並べ替えただけなら頻度とエントロピーは変わりません。繰り返しの分布を読む値であり、文章の良し悪しや予測しにくさとは別です。
初期値は英語です。日本語の文章なら解析言語を切り替え、頻度欄の実際のロケールを確認します。ブラウザの辞書が単語境界を決めます。
自動集計は編集後350ミリ秒待ちます。オフにすると集計ボタンが現れ、Ctrl/Cmd+Enterでも実行できます。古い結果は保存できません。
例文と消去は適用前に長さの変化を表示し、適用後は1回分を復元できます。頻度は50件ずつ追加表示しますが、JSONには全件が入ります。
コード単位、コードポイント、字素、UTF-8バイト数を別々に表示します。単語、行、段落も同じ入力から集計します。
単語として認識した区間をすべて数えます。大文字と小文字の合算は設定で変更できます。
CRLF、CR、LF、U+2028、U+2029を認識します。CRLFはひとつの区切りで、末尾の区切りは空行を作ります。
文字頻度の各項目にU+コードポイント列を添えます。結合マークや外見の似た記号を比べる手掛かりになります。
はい。JSON報告のコピーか保存を選べます。全頻度データと設定、計数の規則を含み、表示中の50件だけに制限されません。
現在の入力をUTF-8で符号化した長さです。BOMは追加せず、Shift-JISやEUC-JPの推定は行いません。元のファイルサイズを再現する機能ではありません。
空白行で区切られた連続する非空行を数えます。空白だけなら0段落で、同じ段落内の改行は段落を増やしません。
100000 UTF-16単位まで処理できます。絵文字には2単位以上を使うものもあります。上限を超えた文章は分割してください。
はい。基本のコード単位、コードポイント、字素、バイト数には含まれます。文字頻度には別の除外規則があるので、サンプル総数を空白抜き文字数として使わないでください。
単語の区切りや数値で気になる点はありますか?