01
Vor dem Ersetzen den Umfang prüfen
Das Feld startet leer. Beispiel und Leeren zeigen zuerst die UTF-16-Länge vor und nach der Änderung. Erst Anwenden ersetzt den Inhalt; danach lässt sich diese Ersetzung einmal rückgängig machen.
Textlänge nachvollziehen
Text einfügen, Analysesprache wählen und Länge, Häufigkeiten sowie Zeichenentropie prüfen.
Die Analyse läuft lokal im Browser. Der eingegebene Text wird dafür nicht hochgeladen.
Die Zeichenmaße zählen die gesamte Eingabe einschließlich Leerraum und Satzzeichen. UTF-8 misst den aktuellen Editorinhalt ohne zusätzliches BOM.
0.0000
Stichprobenumfang: 0 · Verschiedene Einträge: 0
H = −Σ p log₂(p), in Bits je gefilterter Stichprobe. Der Nenner von p ist die Zahl der behaltenen Stichproben, nicht aller Grapheme. Die vollständige Verteilung zählt: Gleiche Häufigkeiten ergeben bei anderer Reihenfolge dieselbe Entropie. Kein Maß für Passwortsicherheit oder Nachweis von Zufälligkeit.
Der Wortanteil bezieht sich auf alle isWordLike-Wortsegmente. Der Zeichenanteil verwendet nur Grapheme mit Unicode-Buchstaben, Markierungen, Zahlen oder Symbolen als Nenner; reine Satzzeichen, Leerraum und Steuerzeichen sind ausgeschlossen.
Verwendete Analysesprache: Nicht verfügbar
Keine auswertbaren Einträge.
Text eingeben oder das Beispiel ausprobieren.
Für ein Formularlimit möchtest du Zeichen zählen, für einen Entwurf Wörter zählen. Der Zeichenzähler zeigt beide Größen getrennt und macht sichtbar, warum ein Emoji mehr als eine UTF-16-Einheit belegen kann. So vergleichst du Zahlen erst, nachdem ihre Einheit feststeht.
Bei mehrsprachigen Texten reicht das Aufteilen an Leerzeichen nicht aus. Wähle die passende Analysesprache und kontrolliere die erkannten Wörter in der Häufigkeitstabelle. Der Text bleibt dabei unverändert; Akzente, kombinierte Zeichen und vorhandene Zeilenumbrüche gehören zur Messgrundlage.
Der Zeichenzähler trennt Grapheme von Codepunkten, UTF-16-Einheiten und UTF-8-Bytes. Ein einfaches lächelndes Emoji entspricht einem Graphem, zwei UTF-16-Einheiten und vier UTF-8-Bytes. Für technische Längenlimits ist deshalb die benannte Einheit entscheidend.
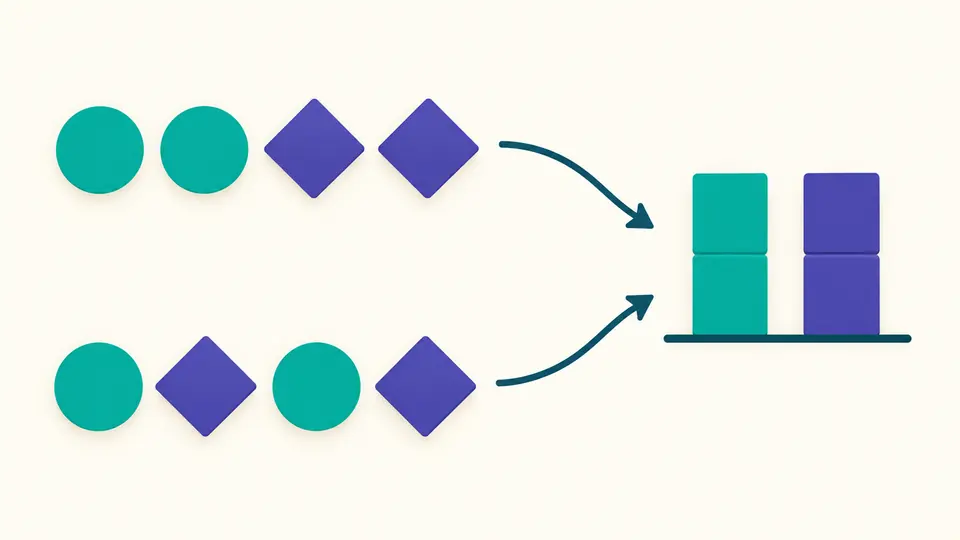
Zwei Texte mit denselben Zeichenhäufigkeiten haben dieselbe Shannon-Entropie, auch wenn ihre Zeichen ganz anders angeordnet sind. Die Berechnung berücksichtigt sämtliche gefilterten Einträge, nicht nur die gerade sichtbaren Tabellenzeilen.
Das Feld startet leer. Beispiel und Leeren zeigen zuerst die UTF-16-Länge vor und nach der Änderung. Erst Anwenden ersetzt den Inhalt; danach lässt sich diese Ersetzung einmal rückgängig machen.
Englisch und automatische Statistik sind voreingestellt. Nach Eingabe- oder Optionsänderungen wartet die Analyse 350 ms. Für deutsche Wortgrenzen Deutsch auswählen; ohne Automatik mit Zählen oder Strg/Cmd+Enter starten.
Die Tabelle beginnt mit 50 Einträgen und zeigt auf Wunsch jeweils 50 weitere. Kopieren und Download enthalten die gesamte Verteilung. Nach Änderungen wird der Export erst mit einer aktuellen Analyse wieder freigegeben.
UTF-16-Einheiten, Codepunkte, Grapheme, UTF-8-Bytes, Wörter, Zeilen und Absätze zeigen unterschiedliche Eigenschaften desselben Editorinhalts.
Die Wortstatistik zählt nur als wortartig erkannte Segmente. Die tatsächlich verwendete Sprache wird angezeigt, damit du Ergebnisse verschiedener Browser nachvollziehen kannst.
Ohne Unterscheidung der Großschreibung werden Häufigkeitsschlüssel mit der gewählten Sprache kleingeschrieben. Der Originaltext und seine grundlegenden Längenwerte ändern sich dadurch nicht.
Die Zeichentabelle zeigt zusätzlich U+-Codepunkte. Damit kannst du ähnlich aussehende Einträge mit kombinierten Akzenten voneinander unterscheiden, ohne den Text umzuschreiben.
Intl.Segmenter zerlegt den Text in der ausgewählten Analysesprache. Gezählt werden nur Segmente mit isWordLike. Satzzeichen und reine Leerzeichen sind keine Wörter; Trennstriche oder Abkürzungen können je nach Browserdaten unterschiedlich behandelt werden.
Ein Absatz ist eine Folge nicht leerer Zeilen. Eine Zeile, die nach trim() leer ist, beendet den Absatz, also auch eine Zeile nur aus Leerzeichen oder Tabs. Mehrere leere Zeilen erzeugen keine zusätzlichen Absätze.
Die eigentliche Berechnung läuft lokal. Ist die Seite mitsamt dem Werkzeug bereits vollständig geladen, benötigt die Analyse keine Serveranfrage. Ein erstmaliger Aufruf oder erneutes Laden ohne Netz wird nicht garantiert.
Erlaubt sind 100.000 UTF-16-Einheiten. Das ist keine feste Wortzahl und entspricht bei Emojis nicht unbedingt 100.000 sichtbaren Zeichen. Überlange Eingaben werden mit einer Fehlermeldung abgewiesen, nicht gekürzt.
Word verwendet eigene Regeln für Wortgrenzen und Dokumentbereiche. Hier wird ausschließlich der aktuelle Editortext ausgewertet, mit der gewählten Intl.Segmenter-Sprache. Prüfe daher identischen Text, Analysesprache und die verglichene Einheit.
Fehlt eine Erklärung zu deinem Text?
Öffne den Zeichenzähler, stelle die Analysesprache ein und sichere die vollständige Statistik für einen nachvollziehbaren Vergleich.