Contrôler ce qui va remplacer le texte
La page commence avec un champ vide. Exemple et Vider ouvrent un aperçu des longueurs avant et après ; Appliquer confirme le remplacement. Un retour à l’état précédent est ensuite disponible une seule fois.
Mesurer un texte sans le modifier
Collez votre texte, choisissez sa langue et comparez les mots, les caractères et les octets.
Le texte est analysé localement dans votre navigateur, sans envoi pour le calcul.
Les mesures de caractères portent sur toute la saisie, espaces et ponctuation compris. Les octets UTF-8 correspondent au texte actuel de l’éditeur, sans ajout de BOM.
0.0000
Échantillons : 0 · Entrées distinctes : 0
H = −Σ p log₂(p), en bits par échantillon filtré. Le dénominateur de p est le nombre d’échantillons retenus, pas le total des graphèmes. Toute la distribution est prise en compte : les mêmes fréquences dans un autre ordre conservent l’entropie. Ce n’est ni une mesure de sécurité d’un mot de passe ni une preuve de hasard.
La part d’un mot utilise tous les segments isWordLike comme dénominateur. Celle d’un caractère utilise les graphèmes contenant une lettre, une marque, un nombre ou un symbole Unicode ; ponctuation seule, espaces et contrôles sont exclus de la base.
Langue effectivement utilisée : Indisponible
Aucun élément à afficher.
Saisissez un texte ou essayez l’exemple.
Un brief demande un nombre de mots, une interface limite les signes et un échange technique parle en octets. Ce compteur de mots présente ces mesures séparément pour éviter de comparer des nombres qui ne désignent pas la même chose.
Les espaces, les accents combinés et les emojis rendent la notion de caractère moins évidente. Le compteur de caractères distingue les graphèmes visibles, les points de code et les unités UTF-16 ; les fréquences permettent ensuite de vérifier quels éléments ont réellement été retenus.
Le compteur de mots accompagne le travail de rédaction avec des mesures techniques explicites. Un simple emoji souriant occupe un graphème, deux unités UTF-16 et quatre octets UTF-8. Une limite formulée en caractères doit donc être rapprochée de la convention du service concerné.
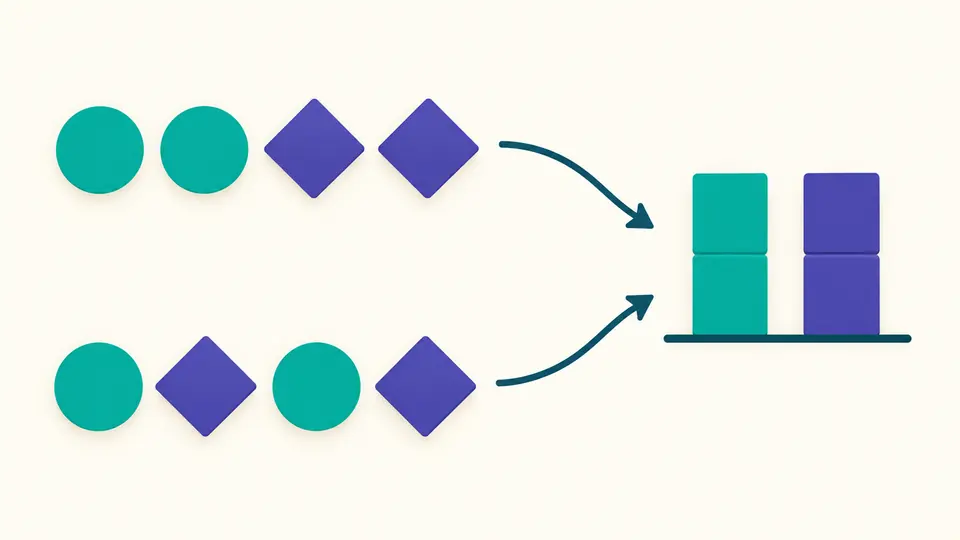
L’entropie décrit la répartition des caractères retenus. Deux suites réordonnées avec les mêmes fréquences aboutissent à la même valeur. La totalité de la distribution participe au calcul, même si la table n’affiche encore que ses premières entrées.
La page commence avec un champ vide. Exemple et Vider ouvrent un aperçu des longueurs avant et après ; Appliquer confirme le remplacement. Un retour à l’état précédent est ensuite disponible une seule fois.
L’anglais est sélectionné au départ, même sur cette page française. L’analyse automatique se déclenche après 350 ms sans modification. Désactivez-la pour utiliser Analyser ou Ctrl/Cmd+Entrée.
Chaque modification rend les anciennes statistiques périmées et désactive leur export jusqu’au calcul suivant. La table avance par groupes de 50 entrées ; le rapport JSON contient toujours la distribution complète.
Comparez mots, lignes et paragraphes avec quatre mesures de caractères : unités UTF-16, points de code, graphèmes et octets UTF-8.
Seuls les segments identifiés comme des mots par Intl.Segmenter sont comptés. La langue effectivement retenue est indiquée pour faciliter la comparaison entre environnements.
Le réglage de casse concerne les clés des deux tables de fréquences. Par défaut, chaque segment est mis en minuscules selon la langue choisie, sans réécrire le texte saisi.
La table de caractères affiche les points de code U+ de chaque entrée. Elle permet de distinguer une lettre accentuée précomposée d’une lettre accompagnée d’une marque combinante.
L’analyse utilise les segments Intl.Segmenter marqués isWordLike dans la langue choisie. Elle ne découpe pas simplement sur les espaces. Une ponctuation seule n’est pas un mot, et les règles du navigateur peuvent influencer les apostrophes ou les mots composés.
L’outil effectue ses calculs dans le navigateur et ne téléverse pas le texte pour l’analyser. Il ne propose pas de sauvegarde de brouillon ; copiez ou téléchargez le rapport si vous souhaitez conserver les statistiques.
Il n’existe pas de nombre unique ici : unités UTF-16, points de code et graphèmes ont chacun leur carte. Tous incluent espaces et signes de ponctuation. La table des fréquences applique un filtre distinct et ne doit pas servir de total des caractères.
Les outils peuvent utiliser les espaces, leurs propres règles linguistiques ou une autre version des données de segmentation. Vérifiez la langue sélectionnée et les entrées de la table avant de comparer les résultats ; une égalité avec un traitement de texte n’est pas garantie.
La limite est de 100 000 unités UTF-16 par saisie. Un emoji peut utiliser plusieurs unités ; ce seuil n’est donc ni un nombre de mots ni un nombre garanti de caractères visibles. Une saisie trop longue entraîne une erreur sans troncature.
Un cas de comptage reste obscur ?
Utilisez le compteur de mots sur votre texte, vérifiez la langue d’analyse et conservez un rapport complet des mesures et des fréquences.