Texte et chaînes

Trier les lignesdans un ordre que vous maîtrisez

Déplacez les étapes pour comprendre leur effet sur votre liste.

Trier les lignes

Texte source

Lignes du résultat

Le texte reste dans ce navigateur, sans envoi.

Étapes ordonnées

  1. 1. Nettoyer les extrémités

  2. 2. Supprimer les lignes vides

  3. 3. Supprimer les doublons

CRLF, CR et LF séparent les lignes en entrée ; la sortie utilise LF. Retours finaux et séparateurs de découpage conservent les entrées vides. Repères de vide et numéros en marge servent uniquement à l’affichage.

20 étapes, 50 000 lignes et 1 000 000 d’unités UTF-16 au maximum à chaque étape ; 1 000 unités par paramètre textuel. Un dépassement invalide tout le calcul.

Saisissez du texte ou appliquez un exemple. Une saisie vide compte zéro ligne.

Trier les lignes devient plus simple quand chaque modification reste visible. Une liste copiée peut contenir des doublons, des espaces aux extrémités et des entrées vides : choisissez les étapes utiles sans remplacer le texte de départ.

L’ordre du traitement compte autant que ses options. Numéroter avant de supprimer les doublons rend chaque entrée distincte. Les étapes peuvent être déplacées, retirées ou ajoutées plusieurs fois.

Pourquoi trier les lignes ici ?

L’ordre décide des entrées conservées

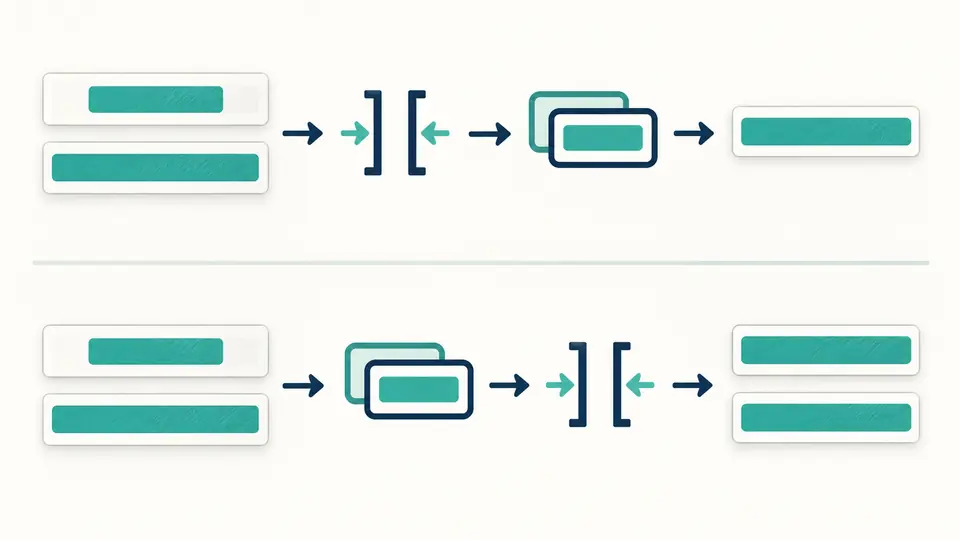
Pour trier les lignes proprement, retirez les espaces avant la recherche de doublons. En inversant ces étapes, deux entrées avec des marges différentes restent distinctes au moment du contrôle. Les compteurs de chaque étape montrent ce qui entre et ce qui reste.

Deux suites d’étapes montrent comment les espaces aux extrémités modifient la conservation des doublons.

Comparer avant de remplacer

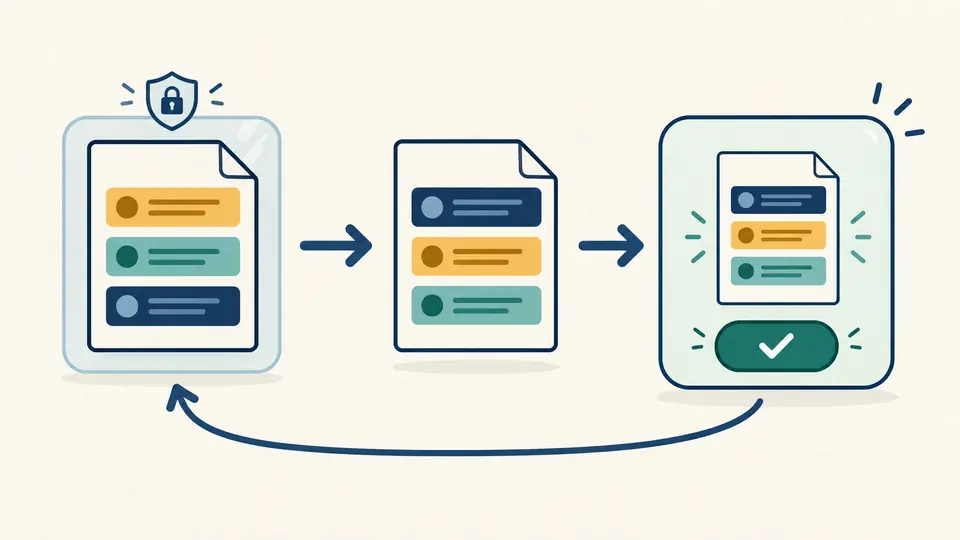
Inversez ou mélangez les lignes en gardant la source intacte. Le mélange utilise une graine fixe et reste identique à chaque recalcul ; avancez la graine pour obtenir une autre disposition. Une prévisualisation séparée précède le remplacement, qui peut être annulé une fois.

Le texte initial reste visible à côté du résultat, avec un aperçu de remplacement et une flèche d’annulation.

Construire une suite vérifiable

01

Examiner le nettoyage initial

Par défaut, les espaces des deux extrémités sont retirés, puis les lignes vides et les doublons sont supprimés. La première occurrence reste en place. Retirez une étape inutile ou répétez une opération avec d’autres paramètres.

02

Déplacer les étapes au bon endroit

Placez le filtre avant la numérotation, ou séparez une liste fusionnée avant son classement. Le mode automatique attend 350 ms après une modification. Sinon, utilisez Exécuter ou Ctrl/Cmd+Entrée. Tout changement de calcul bloque aussitôt l’export.

03

Vérifier les compteurs avant d’appliquer

L’aperçu affiche d’abord 50 lignes et peut en montrer davantage. Copie et téléchargement comprennent le résultat entier. Exemple, Effacer et Utiliser le résultat passent par un aperçu à appliquer. Annuler rétablit la saisie, les étapes, le mode et le résultat précédents.

Préparer une liste exploitable

Comparer et réorganiser

Le classement standard compare les unités UTF-16. Le tri naturel suit une comparaison anglaise des groupes de chiffres, par exemple fichier2 avant fichier10. Inverser ne change que l’ordre des lignes. La déduplication conserve la graphie de la première occurrence.

Garder les lignes pertinentes

Incluez ou excluez les lignes contenant une sous-chaîne littérale : un point reste un point, sans expression régulière. Les opérations de début et de fin conservent le nombre demandé dans l’ordre existant ; zéro produit une liste vide.

Mettre en forme les entrées

Ajoutez un préfixe, un suffixe ou des numéros avec valeur initiale, incrément et séparateur. Vous pouvez fusionner les lignes avec un délimiteur ou découper le texte LF courant. Des séparateurs successifs ou finaux produisent des entrées vides.

Comprendre les limites et les lignes vides

Retours à la ligne et entrées vides
CRLF, CR et LF séparent les lignes en entrée ; la sortie utilise LF. Un retour final ajoute une entrée vide, tandis qu’une saisie initialement vide compte zéro ligne. Retirer un espace laisse une entrée vide à laquelle un préfixe peut encore être ajouté. Zéro ligne et une ligne vide donnent le même texte vide à l’export ; sa réutilisation repart de zéro ligne.
Des comparaisons précisément définies
Le retrait des espaces suit JavaScript. La suppression des lignes vides peut aussi viser celles composées uniquement d’espaces blancs. Ignorer la casse passe en minuscules sans normalisation Unicode. La comparaison naturelle reste anglaise et traite des groupes de chiffres, sans interpréter les nombres négatifs ou décimaux comme des valeurs arithmétiques.
Aucun export tronqué en silence
La saisie et chaque résultat intermédiaire sont limités à 1 000 000 d’unités UTF-16 et 50 000 lignes logiques. Vous disposez de 20 étapes au maximum et de 1 000 unités par paramètre textuel. Un dépassement invalide le calcul et indique l’étape concernée si possible. Les substituts UTF-16 isolés sont refusés avant l’export UTF-8.
Des paramètres littéraux
Fusion et découpage décodent uniquement \n, \r, \t et \\. Un délimiteur vide est admis pour fusionner, mais refusé pour découper ou filtrer. Préfixes, suffixes, séparateurs de numéros et filtres tiennent sur une ligne. Aucun traitement d’expressions régulières, analyse des guillemets CSV, import de fichier, enregistrement de recette ou mélange cryptographique n’est prévu.

Questions pour trier les lignes

La casse modifie-t-elle la comparaison ?

La recherche de doublons et le filtrage proposent une option pour ignorer la casse. Ils comparent alors les minuscules JavaScript tout en conservant le texte de l’entrée retenue. Le classement utilise son propre mode de comparaison ; cette option ne lui est pas transmise.

Que deviennent les répétitions et les espaces superflus ?

Trier les lignes ne retire rien à lui seul. Une étape distincte supprime les doublons en gardant la première occurrence ; une autre retire les espaces aux extrémités. Placez le nettoyage avant la déduplication pour comparer des valeurs déjà nettoyées.

Le contenu reste-t-il sur mon appareil ?

Le traitement s’effectue dans votre navigateur sans envoyer la saisie. Vous décidez de copier ou de télécharger le résultat. Recharger la page réinitialise le texte et les étapes, car aucune recette n’est enregistrée.

Pourquoi un classement textuel place-t-il 10 avant 9 ?

La comparaison UTF-16 examine les caractères : 1 précède 9, donc 10 arrive avant 9. Elle ne convertit pas le contenu de chaque ligne en nombre.

Comment classer les chiffres dans les noms de fichiers ?

Choisissez la comparaison naturelle anglaise pour placer fichier2 avant fichier10. Elle reconnaît les groupes de chiffres ; elle ne garantit ni un ordre de dictionnaire français ni un classement numérique des valeurs négatives et décimales.

Une étape donne un résultat inattendu ?

Revenir pour trier les lignes

Trier les lignes avec des étapes visibles permet de vérifier chaque changement. Ajustez la suite, contrôlez les totaux et enregistrez le résultat complet.