01
Revisa el reemplazo antes de aplicarlo
El editor empieza vacío. Ejemplo y Vaciar muestran las longitudes UTF-16 anterior y posterior; solo Aplicar cambia el contenido. Después puedes deshacer ese reemplazo una vez.
Cada medida tiene su unidad
Introduce texto y elige su idioma para consultar recuentos y distribuciones sin modificarlo.
El análisis se realiza en tu navegador. El texto no se envía a un servidor para calcular las estadísticas.
Las medidas de caracteres incluyen toda la entrada, con espacios y puntuación. Los bytes UTF-8 corresponden al texto actual del editor, sin añadir BOM.
0.0000
Muestras: 0 · Entradas distintas: 0
H = −Σ p log₂(p), en bits por muestra filtrada. p usa el total de muestras retenidas, no todos los grafemas. Se calcula con la distribución completa: el mismo reparto en otro orden da la misma entropía. No mide la seguridad de contraseñas ni demuestra aleatoriedad.
El porcentaje de palabras usa todos los segmentos isWordLike como denominador. El de caracteres usa solo grafemas con letras, marcas, números o símbolos Unicode; excluye grafemas compuestos únicamente por puntuación, espacios o controles.
Idioma efectivo del análisis: No disponible
No hay elementos para mostrar.
Escribe un texto o prueba el ejemplo.
Al revisar un artículo, el número de palabras orienta sobre su extensión, pero no explica cuánto se repite cada término. Este contador de palabras reúne el recuento y las frecuencias para que puedas revisar ambos aspectos sobre el mismo texto.
También funciona como contador de caracteres con unidades explícitas. Un emoji o una tilde combinada pueden dar cifras distintas en grafemas, puntos de código, unidades UTF-16 y bytes UTF-8. Elige la medida que realmente exige tu destino antes de compararla con un límite.
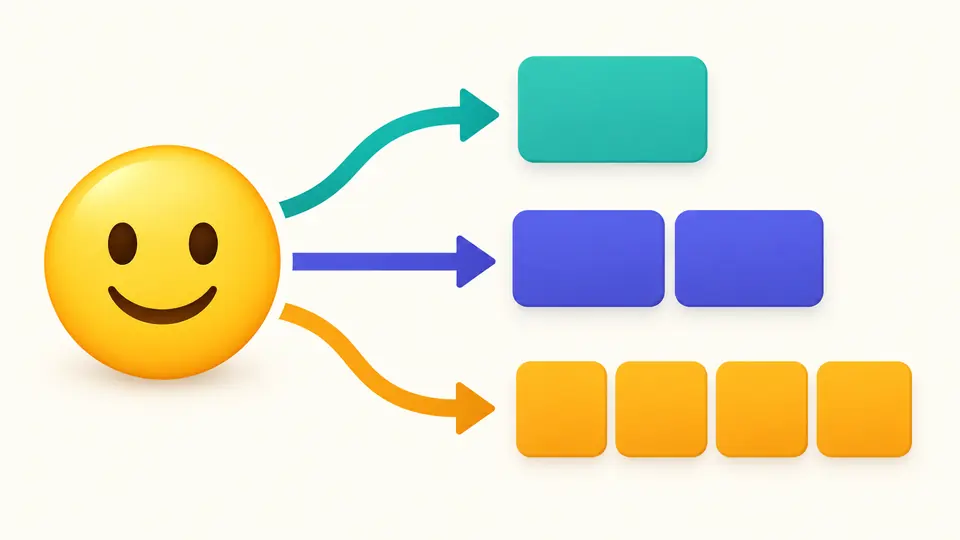
El contador de palabras separa la extensión lingüística de las unidades de codificación. Un emoji sonriente sencillo representa un grafema, dos unidades UTF-16 y cuatro bytes UTF-8. No conviene usar una cifra de bytes como si fuera un límite de caracteres visibles.
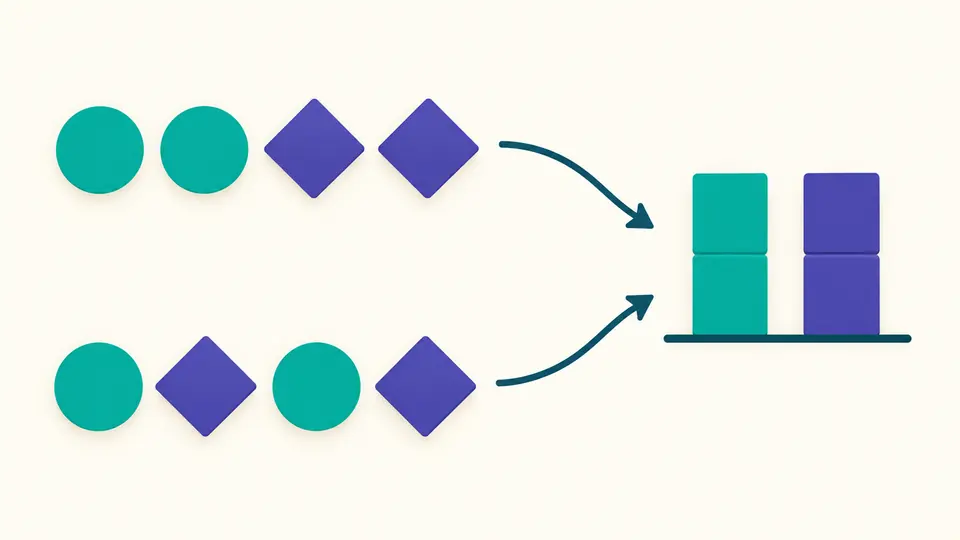
Dos secuencias pueden colocar sus símbolos en posiciones distintas y compartir las mismas frecuencias. Su entropía de Shannon será igual. La cifra incluye toda la distribución de caracteres filtrados, aunque la tabla solo muestre una parte.
El editor empieza vacío. Ejemplo y Vaciar muestran las longitudes UTF-16 anterior y posterior; solo Aplicar cambia el contenido. Después puedes deshacer ese reemplazo una vez.
El idioma predeterminado es inglés, aunque la página esté en español. El modo automático espera 350 ms tras un cambio. Si lo desactivas, ejecuta el cálculo con Contar o Ctrl/Cmd+Intro.
La tabla muestra primero 50 entradas y permite añadir otras 50 cada vez. El JSON incluye todas. Al editar texto u opciones, debes actualizar el análisis antes de volver a copiar o descargar.
Palabras, líneas y párrafos conviven con unidades UTF-16, puntos de código, grafemas y bytes UTF-8. Todos parten del contenido actual del editor.
La frecuencia y el porcentaje permiten localizar términos repetidos. Las palabras únicas corresponden a las claves distintas de la tabla según el ajuste de mayúsculas, no a un análisis de sinónimos.
Por defecto se pasa cada segmento a minúsculas según el idioma elegido para agrupar frecuencias. Activar la distinción conserva grupos separados, sin cambiar el texto ni los recuentos básicos.
Cada entrada de caracteres incluye sus puntos de código U+. Así puedes detectar acentos combinados o símbolos visualmente similares que se mantienen como claves distintas.
Se cuentan los segmentos que Intl.Segmenter marca como isWordLike para el idioma elegido. El método no consiste en dividir solo por espacios. La puntuación aislada queda fuera y las fronteras de palabras pueden variar con los datos del navegador.
Sí. Las medidas generales incluyen espacios, tabulaciones, saltos y puntuación según cada unidad. La frecuencia de caracteres tiene otro criterio: excluye grafemas que contienen únicamente espacios, puntuación o controles. No es un total general sin espacios.
Son los grupos distintos de la tabla de palabras, después de aplicar el ajuste de mayúsculas. Casa y casa se agrupan por defecto. No se agrupan sinónimos ni formas flexionadas, y las palabras que aparecen una sola vez son un concepto diferente.
Cada bloque de líneas consecutivas no vacías cuenta como un párrafo. Una línea que queda vacía tras trim(), incluso si contiene espacios o tabulaciones, separa bloques. Varias líneas vacías seguidas no crean párrafos vacíos.
Pueden utilizar otras reglas para guiones, apóstrofos y límites de palabras, además de contar partes de un documento que aquí no has pegado. Compara el mismo texto y la misma unidad; este resultado depende también del idioma y de Intl.Segmenter.
¿Tienes una duda sobre un resultado?
Abre el contador de palabras, comprueba las repeticiones y guarda las estadísticas completas para compararlas con otra versión.