Text und Zeichenfolgen

Text extrahierenmit nachvollziehbaren Fundstellen

Wählen Sie einen Mustertyp und prüfen Sie die Werte mit ihrer ersten Fundzeile.

Text extrahieren

Testtext

Ergebnis

Text eingeben oder ein Beispiel übernehmen.

Muster und Text werden lokal im Browser-Worker verarbeitet und nicht hochgeladen.

Optionen

100.000 UTF-16-Einheiten Eingabe · 2.000 im Muster · 10.000 Kandidaten · 2 Sekunden. Ein Limit verwirft den ganzen Lauf.

Text eingeben oder ein Beispiel übernehmen.

Exportiert alle Ergebnisse. TXT trennt mit LF. CSV ergänzt formelähnliche Werte um ein Apostroph; JSON erhält Werte und mehrzeilige Datensätze.

Text extrahieren wird bei kopierten Protokollen schnell zur Sucharbeit: Zwischen Meldungen stehen Adressen, Links und Kennungen. Hier bleibt die Vorlage sichtbar, während eine Liste der passenden Werte entsteht. Die erste Fundzeile führt zurück zum ursprünglichen Zusammenhang.

Text extrahieren mit Bezug zur Quelle

Eine Vorlage, getrennte Ergebnislisten

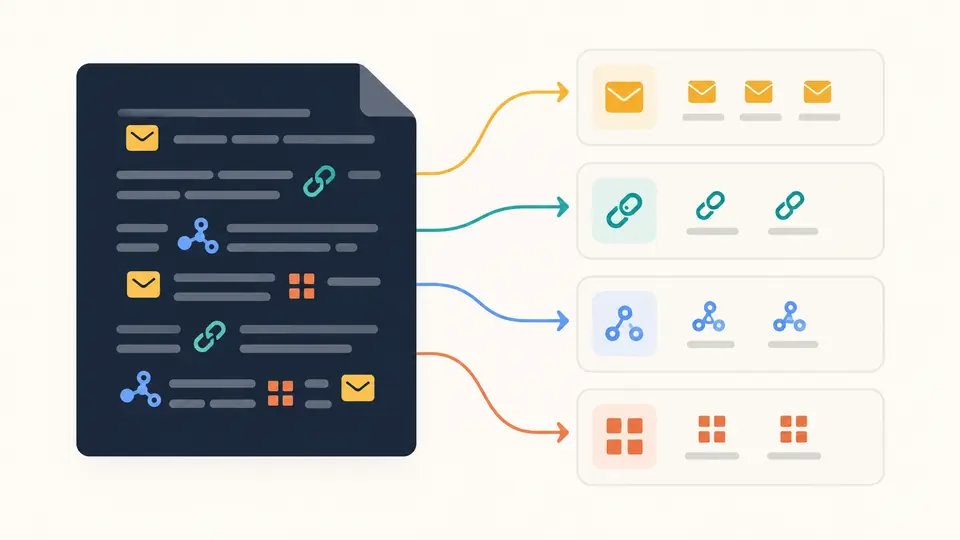
Text extrahieren funktioniert für jeweils einen Typ. Wechseln Sie von E-Mails zu URLs, IPs oder Zahlen, ohne die Vorlage neu einzufügen. Für Bestellkennungen dient ein eigenes Muster. So vermischen sich Ziffern aus einer Adresse nicht unbemerkt mit einer Liste eigenständiger Zahlen.

Ein gemischtes Dokument wird in Listen mit Brief-, Link-, Netzwerk- und Zahlensymbolen aufgeteilt.

Duplikate mit Fundstelle zusammenfassen

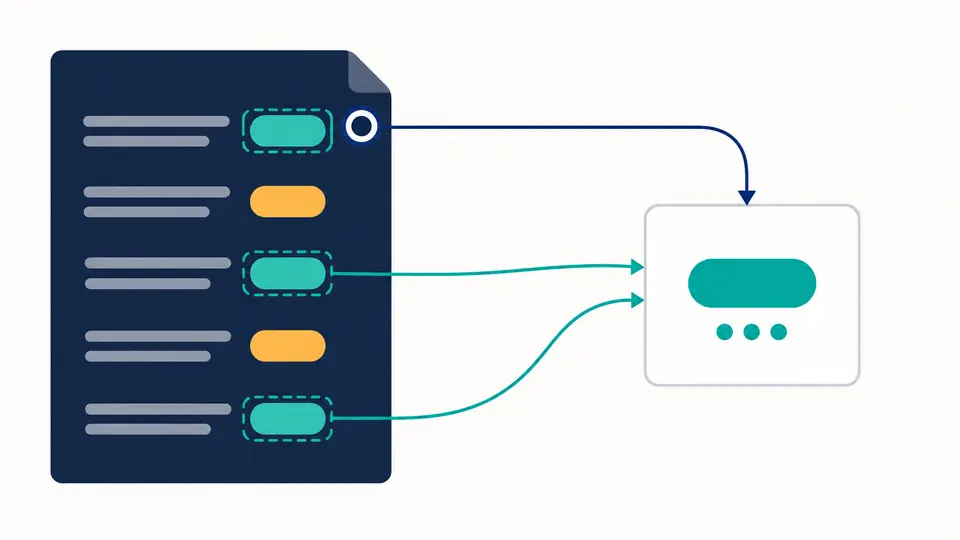
Gleiche Zeichenfolgen werden an ihrer ersten Position behalten; weitere Treffer erhöhen den Zähler. Ohne Deduplizierung erscheint jedes Vorkommen. Großschreibung und IPv6-Schreibweise bleiben erhalten. Dadurch lässt sich nachvollziehen, welche Werte tatsächlich gleich waren und welche nur ähnlich aussehen.

Wiederholte Markierungen werden zu einem Eintrag zusammengeführt; eine Verbindung bleibt zur ersten Quellzeile bestehen.

Muster, Gruppen und Aktualität prüfen

01

Den passenden Typ wählen

E-Mail-Adressen sind voreingestellt. Ein Moduswechsel behält die Eingabe. Beispiel und Leeren öffnen zunächst eine Vorschau mit Zeichenzahlen. Anwenden setzt dabei auch Optionen zurück; Rückgängig stellt Eingabe und Ergebnis gemeinsam wieder her.

02

Nur die benötigte Gruppe ausgeben

Das Muster ORD-(\d+) liefert mit Gruppe 1 nur die Ziffern und mit 0 den gesamten Treffer. Gruppennamen sind ebenfalls möglich. Alle Vorkommen werden gesucht. m beeinflusst Zeilenanker; erst s lässt den Punkt auch Zeilenumbrüche erfassen.

03

Ein aktuelles Ergebnis abwarten

Automatische Läufe starten 350 ms nach Änderungen. Ausgeschaltet stehen die Schaltfläche und Ctrl/Cmd+Enter bereit. Veraltete Ergebnisse lassen sich nicht exportieren. Die Anzeige wächst in Schritten von 50; Kopieren und Herunterladen umfassen trotzdem sämtliche Ergebniszeilen.

Von Adressen zu eigenen Suchmustern

E-Mail-Adressen extrahieren und URLs extrahieren

Voreinstellungen erkennen übliche ASCII-Adressen mit Plus-Tags sowie HTTP(S)-Links. Query und Fragment bleiben erhalten. Abschließende Satzzeichen und überzählige schließende Klammern werden entfernt, zusammengehörige Klammern in Pfaden wie Topic_(part) dagegen beibehalten.

Zahlen extrahieren, ohne sie umzurechnen

IPv4-Kandidaten werden auf vier Abschnitte von 0–255 geprüft; IPv6 unterstützt komprimierte Schreibweisen. Zahlen wie -12.50, .75 oder 6.02e23 bleiben Zeichenfolgen. Auch lange Ganzzahlen behalten ihre Ziffern, weil keine Umwandlung in Gleitkommazahlen erfolgt.

Regex Extraktor mit Quellangaben

Eigene JavaScript-Ausdrücke geben vollständige Treffer oder nummerierte beziehungsweise benannte Gruppen zurück. Die angezeigte Zeile gehört zum Beginn des vollständigen Treffers, auch bei mehrzeiligen Gruppen. CSV und JSON können erste Zeile und Häufigkeit zusammen mit dem Wert enthalten.

Grenzen der Erkennung und Ausgabe

Treffer sind keine Existenzprüfung
E-Mails sind auf übliche unquotierte ASCII-Formen mit gepunkteter Domain beschränkt. Internationale Mailboxen und sämtliche RFC-Sonderformen sind nicht abgedeckt. Links benötigen HTTP(S); reine Domains und FTP fehlen. Das Werkzeug öffnet keine Links und prüft weder Zustellbarkeit noch Erreichbarkeit.
Exakte Zeichenfolgen statt Vereinheitlichung
Es gibt keine Sortierung, Kleinschreibung oder Unicode-Normalisierung. Unterschiedliche IPv6-Schreibweisen bleiben getrennt. IPv4 mit führenden Nullen wird abgelehnt; CIDR und Zonen werden nicht interpretiert. Dezimalzahlen verwenden den Punkt: 1,234 liefert zwei Teile, keine deutsche Kommazahl.
JavaScript und vollständige Trefferpositionen
Muster werden ohne /-Begrenzer eingegeben. g ist immer aktiv; i, m, s und u sind optional. Ganze Treffer überlappen nicht. Leere Werte und nicht beteiligte Gruppen werden übersprungen und gezählt. CRLF zählt als ein Umbruch; CR, LF und Unicode-Zeilentrenner ebenfalls. PCRE, Ersetzen und Zeilenfilter sind nicht enthalten.
Ein Limit verwirft den gesamten Lauf
Die Grenzen liegen bei 100.000 UTF-16-Einheiten Eingabe, 2.000 im Muster und 10.000 Kandidaten vor Deduplizierung. Gespeicherte Werte dürfen insgesamt 1.000.000, ein Export 4.000.000 Einheiten haben. Nach zwei Sekunden wird der Worker beendet. Ungültige Surrogate sowie abgeschnittene oder veraltete Ergebnisse werden nicht exportiert.
Ausgabeformate unterscheiden sich
TXT verbindet Werte mit LF und trennt mehrzeilige Datensätze dadurch nicht eindeutig. JSON erhält Werte und Datensatzgrenzen. CSV setzt Anführungszeichen und ergänzt bei formelähnlichen Werten ein Apostroph. Für unveränderte Zeichenfolgen wählen Sie JSON. Dateiimport, Dokumenterkennung und Eingabeverlauf sind nicht vorgesehen.

Text extrahieren: häufige Fragen

Warum liefert mein Muster keine Treffer?

Prüfen Sie zunächst Modus, Großschreibung und Gruppe. /-Begrenzer gehören nicht ins Musterfeld. Für zeilenweise Anker verwenden Sie m, für einen Punkt über Zeilenumbrüche hinweg s. Eine unbekannte Gruppe erzeugt einen Fehler; eine leere oder nicht beteiligte Gruppe zählt als übersprungen.

Kann ich Text aus PDF oder Word direkt übernehmen?

Öffnen Sie das Dokument in seiner Anwendung und kopieren Sie den Text in die Eingabe. Dateien werden hier nicht analysiert. Bei gescannten Seiten ist vorher eine Texterkennung nötig. Zusätzliche Umbrüche innerhalb einer Adresse können die Erkennung verändern.

Worin unterscheiden sich TXT, CSV und JSON?

TXT enthält ausschließlich Werte. CSV und JSON können zusätzlich erste Fundzeile und Anzahl enthalten. CSV schützt formelähnliche Zellwerte durch ein Apostroph. JSON eignet sich, wenn Werte einschließlich eingebetteter Umbrüche und ohne diesen Zusatz erhalten bleiben müssen.

Kann ich mehrere Mustertypen gleichzeitig extrahieren?

Pro Lauf wird ein Typ verarbeitet. Wechseln Sie den Modus für eine weitere Liste derselben Vorlage. Ein eigener Ausdruck mit Alternativen kann mehrere Formen erfassen; die Werte landen dann gemeinsam in einer Liste und sollten vor dem Export geprüft werden.

Wie groß darf der Text sein?

Fügen Sie bis zu 100.000 UTF-16-Einheiten ein; einen Datei-Upload gibt es nicht. Auch wiederholte Werte zählen vor dem Zusammenfassen gegen das Limit von 10.000 Kandidaten. Bei Überschreitung oder Zeitablauf teilen Sie den Text auf oder grenzen das Muster stärker ein.

Verhält sich ein Schritt anders als erwartet?

Text extrahieren und Ergebnisse speichern

Text extrahieren lässt sich zunächst an einem kleinen Ausschnitt prüfen. Vergleichen Sie Fundzeilen und Häufigkeiten und speichern Sie dann die vollständige Liste.