01
先用示例核对模式
默认选择邮箱,切换模式不会删除原文。示例与清空会先展示替换前后的字符数,应用后恢复默认选项;撤销能同时恢复旧输入和结果。文本提取针对匹配片段,不会自动保留其所在的整行。
文本与字符串
选择提取模式,核对来源行号,再复制或下载完整结果。
输入文本,或应用示例。
文本与表达式只在当前浏览器处理,不会上传。
输入 100,000 个 UTF-16 单元 · 模式 2,000 个单元 · 候选 10,000 次 · 超时 2 秒。超限整次报错。
输入文本,或应用示例。
导出包含全部结果。TXT 用 LF 分隔;CSV 给类似公式的值加单引号前缀;JSON 保留原值和多行记录边界。
日志里混着地址、编号和说明文字时,正则提取可以把同一类内容集中成列表。原文始终留在左侧,结果带着首次出现的行号,便于回到上下文判断这条记录是否正是你要的内容。
正则提取保留当前输入,让你依次切换邮箱提取、网址提取、IP 地址和数字提取。查订单号时再使用自定义模式。每次只输出所选类型,避免网址里的数字和独立数值混在一起,形成难以核对的综合列表。
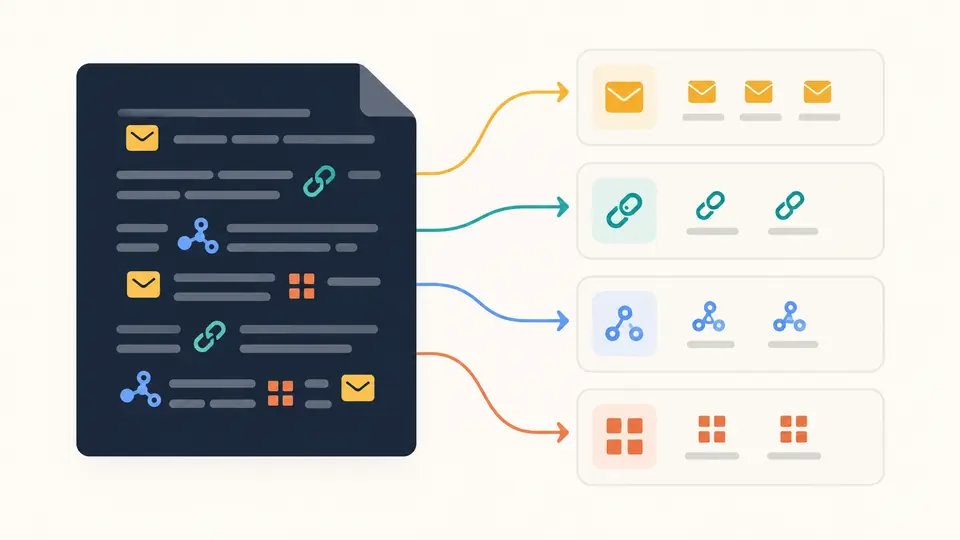
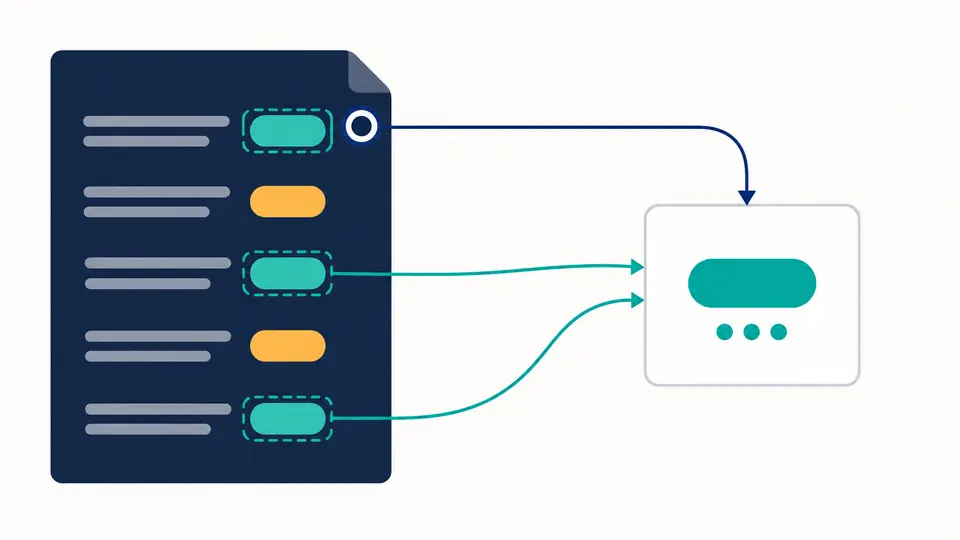
去重会留下第一次出现的位置,并累计该值的出现次数。关闭去重后,每次命中重新成为一条记录。大小写、链接写法和 IPv6 缩写都按原文保留,因此看似相同但字符串不同的值不会被擅自合并。
默认选择邮箱,切换模式不会删除原文。示例与清空会先展示替换前后的字符数,应用后恢复默认选项;撤销能同时恢复旧输入和结果。文本提取针对匹配片段,不会自动保留其所在的整行。
自定义模式填写 ORD-(\d+),捕获组填写 1,就能只取订单数字。填写 0 返回整段匹配,也可以填写命名组。全局搜索始终开启;需要跨行处理时,再按实际目的设置 m 或 s。
自动提取会在修改后等待 350 ms;关闭后显示提取按钮,并支持 Ctrl/Cmd+Enter。旧结果会变淡,复制和下载同时禁用。列表先显示 50 项,继续展开只影响显示,完整导出不受分页限制。
邮箱模式识别常见 ASCII 地址,保留加号标签和原有大小写。链接模式识别 HTTP(S),保留查询参数和片段,去掉句末常见标点及外层多余的右括号;Topic_(part) 这样的成对括号仍保留在路径里。
IPv4 的四段必须处于 0–255,IPv6 支持压缩形式及嵌入式 IPv4。数字模式返回原始字符串,包括 -12.50、.75 与 6.02e23,不转换成浮点数,所以超出 JavaScript 安全整数范围的长编号也能保留每一位。
原生 JavaScript 正则可返回完整匹配、编号组或命名组。行号始终表示完整匹配开始的位置,即使捕获内容跨行也如此。需要机器读取时选择 JSON,需要表格复核时选择 CSV,并按需保留行号和次数。
先检查当前模式,再检查表达式和捕获组。自定义框里只填模式正文,不要带 / 分隔符。m 改变行首行尾锚点的含义,s 才允许点号匹配换行。不存在的组会报错;没有参与匹配或值为空的组会跳过并计数。
这里接收的是纯文本,不解析 PDF、Word 或图片。先在原应用复制文本,再粘贴到输入框。扫描件需要先识别文字;换行和空格可能影响邮箱、链接的完整性,应先用几条记录检查效果。
TXT 只包含提取值,不加入行号。CSV 和 JSON 还可包含首次行号与出现次数。CSV 会对类似公式的值增加单引号前缀,JSON 则保留原值;自定义捕获含换行时,JSON 更容易保持记录边界。
每次只运行当前模式,切换后继续使用同一份输入并替换结果。这样检查邮箱时不会同时混入 IP 或网址中的数字。确实需要多类混合时,可以在自定义表达式里使用分支,导出前再核对匹配范围。
粘贴上限是 100,000 个 UTF-16 单元,没有文件上传入口。候选匹配超过 10,000 次也会整次失败,即便去重后只剩一项。遇到限制或超过 2 秒时,缩小日志范围或简化模式后重新运行。
某一步与预期不同?