01
検索用の値を区別する
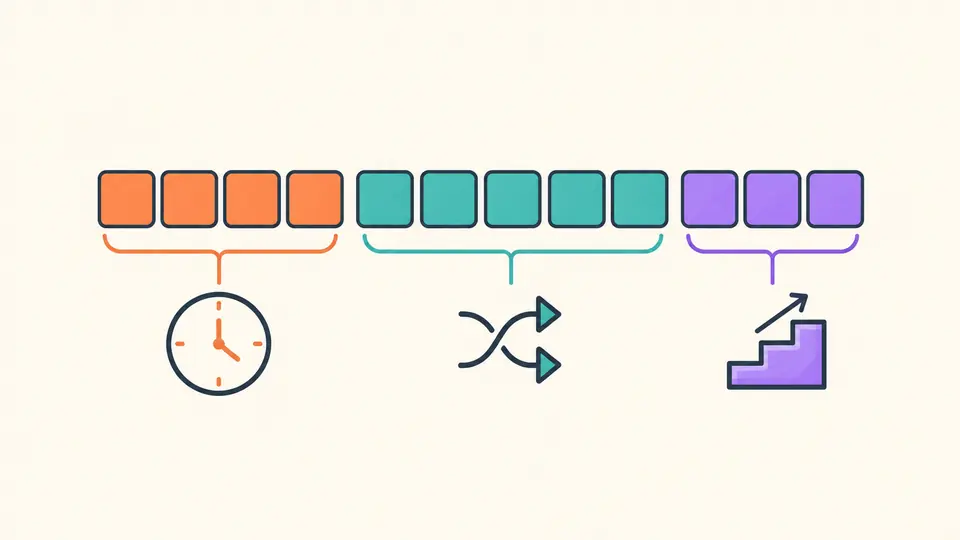
生成は新しいテストID、解析は既存値の確認、日付境界は末尾をゼロにした比較用の値を作ります。
- 日付境界を新規文書の一意なIDとして使わないでください。
識別子
生成・解析・日付境界から操作を選択してください。
4バイトの符号なしタイムスタンプ、5バイトの乱数値、3バイトのカウンター。乱数部分からマシンIDやPIDは復元できません。
入力はこのブラウザー内で処理され、サーバーには送信されません。
デコード:1行に24桁の16進ObjectIdを1つ入力。生成:空欄なら現在時刻、または時刻を1つ入力。下限値:1行に時刻を1つ入力。整数のUnix秒、または秒とZか±HH:mmを含むISO時刻を使用します。空白は除去しません。
最大1,000行、100,000 UTF-16コード単位。生成数は1~1,000個。時刻の範囲はUnix秒で0~4294967295です。
入力するかサンプルを読み込んでください。
ObjectId生成は、データベースを用意する前にAPIのテスト値を作りたいときに役立ちます。ログに残った値は解析モードに貼り付ければ、先頭の時刻部分を確認できます。
形式が正しい値でも、そのIDの文書が存在するとは限りません。保存日時を正確に知る必要がある場合は、IDとは別の日時フィールドを使ってください。
ObjectId生成では、4バイトの時刻、5バイトのランダム値、3バイトのカウンターを分けて表示します。中央部分からマシン名やプロセスIDを復元できるとは扱いません。
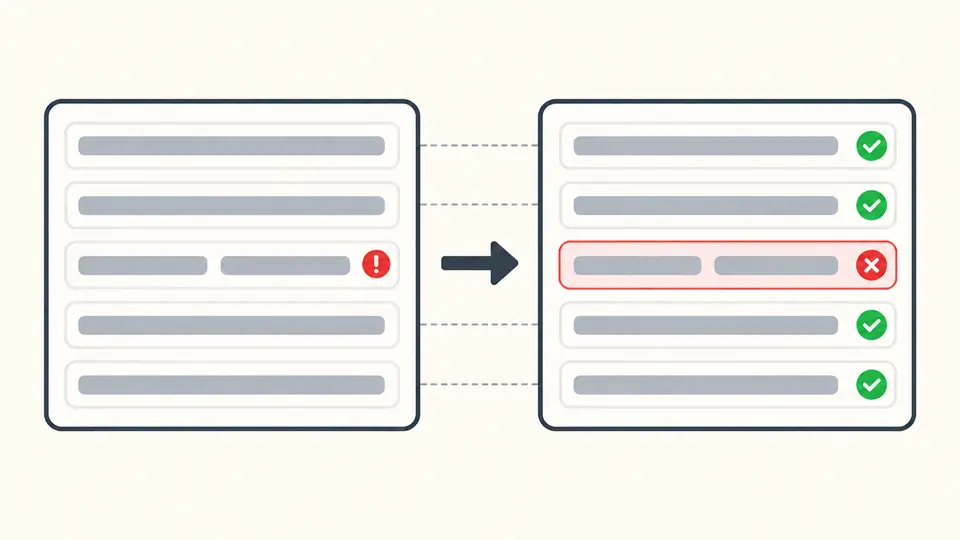
一括解析は成功した行だけを拾いません。元の入力とエラーを残すので、ログのどこを直すべきかを確認できます。
生成は新しいテストID、解析は既存値の確認、日付境界は末尾をゼロにした比較用の値を作ります。
生成時の入力が空なら現在の秒を使います。指定する場合はUnix秒か、Zまたは時差を含むISO日時を入力します。
解析は1行に24桁の16進数を入力します。表示行数の上限と出力全体の行数は別です。 解析と日付境界は、初期設定では編集の350 ms後に自動更新します。自動変換をオフにすると、変換ボタンまたはCtrl/Cmd+Enterで実行できます。生成は明示的な操作が必要で、自動では実行されません。
1回に1~1,000件を生成します。暗号学的乱数で初期値を用意し、同じ実行コンテキスト内でカウンターを進めます。
ObjectId解析では符号なしビッグエンディアンのUnix秒を読み、タイムスタンプに対応するUTC日時、ランダム値、カウンターを表示します。
指定秒のプレフィックスにゼロを付けたBSON値を作ります。データベースへの問い合わせ自体は実行しません。
生成結果は1行1IDのTXT、解析と境界の結果は元の入力とエラーを含むJSONです。未表示の行も含まれます。
日付境界モードで開始と終了の秒をそれぞれ変換し、生成された比較値を範囲条件に使えます。終了を含めるかどうかはクエリ側で決めます。境界値は一意性を目的としていません。
このページでは24桁以外、16進数以外、ラッパーや余分な空白を含む行は無効です。アプリのCastErrorではIDとして渡した値そのものも確認してください。形式検証だけでルーティングの問題は解決できません。
先頭4バイトをUnix秒として読み取れます。ただしIDを生成した側の時計や指定時刻による値なので、実際の保存時刻とは限りません。
ObjectId生成は1回に1~1,000件です。各値のカウンターが進み、コピーやダウンロードは表示済み行に限定されません。
不要です。ObjectId生成と解析はローカルに実行されます。そのため、解析に成功しても指定IDの文書が存在するかは分かりません。
気になる解析結果がありますか?