01
発行方式を先に確認
Twitter原版はsnowflake-2010の保存コードに対応します。Discordには符号なしの公式形式を使います。独自方式ならカスタムを選び、サービス側の仕様からエポックと各ビット数を転記してください。
IDと生成時刻
数字を読む前に、発行元のレイアウトを選んでください。
IDの計算はブラウザ内で行い、入力は送信しません。
十進IDを一つ、256文字以内で入力。URLや一覧は使えません。
Twitter snowflake-2010:41/5/5/12。ノードの上位はデータセンター、下位はworker。予約符号ビットは0。 出典を見る
IDを入力するか例を読み込んでください。
ログにIDしか残っていないとき、Snowflake IDデコードで埋め込まれた時刻を調べられます。ただし数字だけでは発行元のエポックは分かりません。もっともらしい日付が出ても形式が正しい証拠にはならないため、まず生成サービスの設定と照合してください。
Snowflake IDデコードではTwitterの保存版とDiscordを別の形式として扱います。時刻はそれぞれ41ビットと42ビットで、ノードを構成する二つの部分の名前も異なります。プリセットの出典を開いて、解釈の根拠まで確認できます。
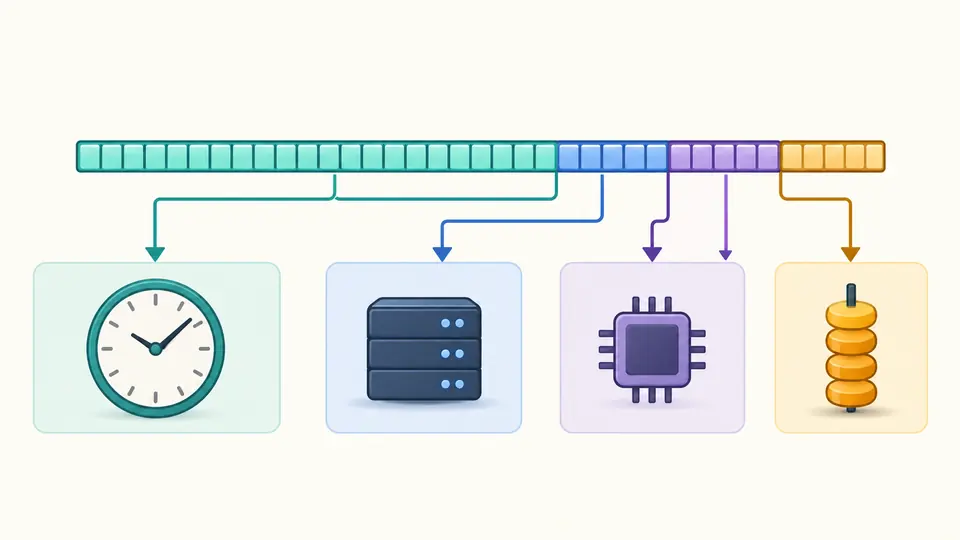
時刻、ノード、連番を固定すると同じIDになります。ビットをまとめて表示するので、アプリのシフト量やマスクとの比較に便利です。独自の割り当てに切り替えれば、境界を変えた際に各フィールドがどう読まれるかも調べられます。
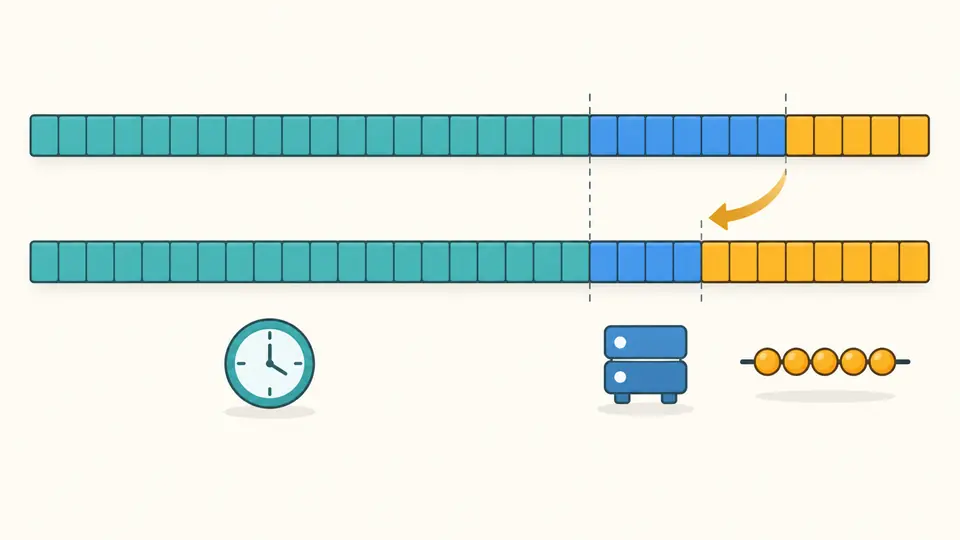
Twitter原版はsnowflake-2010の保存コードに対応します。Discordには符号なしの公式形式を使います。独自方式ならカスタムを選び、サービス側の仕様からエポックと各ビット数を転記してください。
エポックも生成時刻もUnixミリ秒です。プリセットのノード値は上位部分×32+下位部分。Twitterではデータセンターとworker、Discordではworkerとprocessに相当します。
自動デコードは編集が止まってから350ミリ秒後に実行します。オフにするとボタンまたはCtrl/Cmd + Enterで実行できます。変更直後は古い結果のコピーを無効にし、テスト生成は常に手動で行います。
Snowflakeデコーダーは十進文字列をBigIntとして処理します。Discordの175928847299117063は2016-04-30T11:18:25.796Z、ノード32、連番7です。通常の浮動小数点で同じ値に丸められる隣接IDも区別できます。
タイムスタンプはUTC、Unixミリ秒、エポックからの経過時間を表示します。二進表現は先頭のゼロを保持し、時刻・ノード・連番ごとに区切ります。Twitterの予約符号ビットはゼロ、Discordは64ビット全体を使用します。
独自設定は上位から時刻、ノード、連番の連続配置です。ノードや連番を0ビットにすると、そのフィールドには0だけを指定できます。存在しないビットに値を詰め込んで隣の欄を壊すことはありません。
生成時刻を指定すると再現可能なテストIDを作れます。空欄なら実行時の時計を使用します。生成直後に同じ設定で解析し、IDのコピーとレイアウトを含むJSONレポートの保存に対応します。
Discordを選び、元のID文字列を入力します。Snowflake IDデコードは下位22ビットを取り除いて1420070400000ミリ秒を加えます。結果はID内の時刻を示し、メッセージの存在を別途確認するものではありません。
Twitter原版は1288834974657ミリ秒、Discordは1420070400000ミリ秒を起点にします。時刻の幅も41ビットと42ビットで異なるため、エポックだけを入れ替えると境界の扱いを間違える場合があります。
プリセットの各ノード部分は5ビットで0~31、合成値は10ビットで0~1023です。連番は12ビットで0~4095。上限を超える値は次のフィールドにあふれるため生成時に拒否します。
はい。カスタムを選び、符号付きUnixミリ秒のエポックと三つのビット幅を設定します。生成時刻はエポック以降で、その差が時刻フィールドに収まる必要があります。
表計算や数値パーサーが大きな整数を丸めた可能性があります。このツールはBigIntを使いますが、入力前に失われた桁は復元できません。IDを数値化する前の文字列から取り直してください。
別のレイアウトで困っていますか?