01
确认原始发号方案
预设里的 Twitter 指归档的 snowflake-2010 实现,Discord 使用其官方无符号布局。数字本身没有平台标签;自定义模式需要填写业务系统真实的纪元和位宽。
标识符与时间
先选来源布局,再解释这串数字。
全部 ID 计算在浏览器内完成,输入不会上传。
每次一个十进制 ID,最多 256 字符,不接受链接或列表。
Twitter snowflake-2010:41/5/5/12,高位节点为数据中心,低位为工作节点;保留符号位恒为 0。 查看来源
输入 ID 或载入示例。
日志里只有订单号,没有单独记录生成时间时,雪花 ID 解析可以帮你检查其中的时间字段。前提是知道发号系统采用的布局:同一串数字配上不同的纪元,可能都得到看似合理的日期。先查系统配置,再判断解析出来的时间是否符合预期。
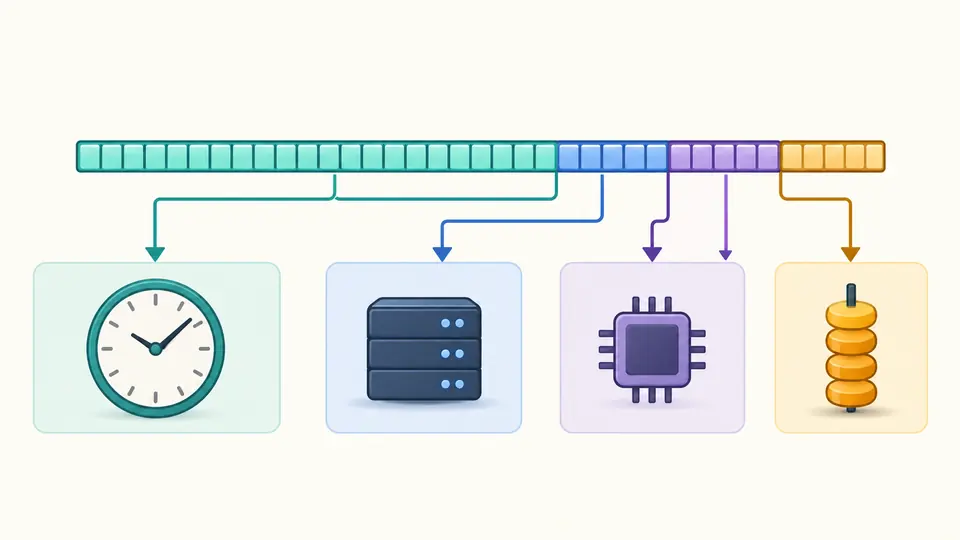
雪花 ID 解析将 Twitter 归档原版与 Discord 分开处理:时间位分别为 41 位和 42 位,两个节点子字段的含义也不同。选项显示纪元、位宽及来源,排查时间偏差时可以先核对格式,不必猜测是哪一段代码算错了。
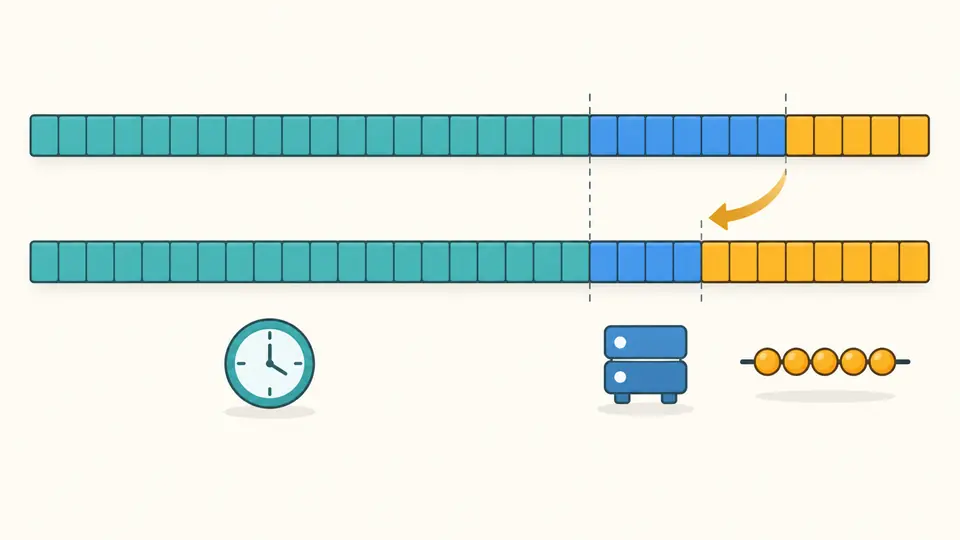
指定毫秒时间、节点号和序列号,会得到相同的测试标识符。对照二进制分段能检查位移和掩码是否对齐;自定义布局还允许调整节点与序列的分界,帮助定位业务发号器的字段装配问题。
预设里的 Twitter 指归档的 snowflake-2010 实现,Discord 使用其官方无符号布局。数字本身没有平台标签;自定义模式需要填写业务系统真实的纪元和位宽。
纪元与生成时间都填 Unix 毫秒,不能直接粘十位的秒时间戳。预设的合并节点号等于高位子字段 × 32 + 低位子字段;Twitter 对应数据中心与工作节点,Discord 对应工作节点与进程。
自动解析在修改后等待 350 毫秒执行;关闭后可按 Ctrl/Cmd + Enter 手动运行。参数一变,旧结果立即失效,复制和下载恢复可用才表示新计算完成。测试生成始终需要主动执行。
这个 Snowflake ID 解析器直接把十进制字符串交给 BigInt。以 Discord 示例 175928847299117063 为例,得到 UTC 时间 2016-04-30T11:18:25.796Z、节点 32 和序列 7;相邻编号的序列差异不会因浮点舍入消失。
雪花 ID 时间戳同时以 UTC、Unix 毫秒和距纪元的偏移展示。二进制按时间、节点、序列分组并保留前导零;Twitter 另列保留的零符号位,Discord 使用完整 64 位。
自定义模式按从高到低的时间、节点、序列分配位数。时间至少占一位,节点或序列可以为零位。后者表示没有这个字段,只能写入数值零,不能通过填大数绕过约束。
测试生成按雪花算法的位装配方式组合三个字段,并立即反解供核对。时间留空取点击时刻,指定时间则可以复现。复制按钮给出编号本身,下载报告保留布局和各项字段。
时间位保存的是相对纪元的毫秒偏移。Twitter 原版与 Discord 的纪元不同,时间字段还分别占 41 位和 42 位。雪花 ID 解析会使用你选择的完整布局,因此需要先确认编号来源。
普通 JavaScript 数字无法精确表示所有超过 2^53 − 1 的整数。BigInt 可以保住原始字符串的每一位;但如果表格或其他程序已经把尾数四舍五入,就必须重新取得原始值,无法反推丢失的数字。
从发号服务取得纪元、时间位数、节点位数和序列位数,选择自定义后按原值填写。纪元允许有符号的 Unix 毫秒值;生成时间不能早于纪元,时间差和另外两个字段都必须装得进分配的位数。
日期统一显示带 Z 的 UTC 时间,同时提供 Unix 毫秒时间戳。它们表示同一瞬间,不随浏览器所在地改变。需要本地时区展示时,可继续使用日期与时间类工具转换。
可以。选 Discord 并切换测试生成,填写 Unix 毫秒时间、合并节点和序列。节点与序列都为零时得到该毫秒的最小布局值。它是算出来的测试编号,不代表存在对应的账号或消息。
遇到了不同的位布局?