01
保留待检查的原始文本
每行应为 8-4-4-4-12 分组的十六进制值。大写字母可以接受,但不会自动去掉前后空格、花括号或 URN 前缀。
- 空行单独计数,不算格式错误。
标识符
每行一个 UUID,查看首个格式有效值的字段和完整报告。
输入仅在此浏览器内处理,不会发送到服务器。
时间只是编码值,不证明实际创建时刻;节点字段不能确认设备身份。
每行一个标准 36 字符 UUID。接受大写,不自动移除空格或包装。
最多 2,000 行、200,000 个 UTF-16 码元。
输入 UUID 或选择示例以开始。
从 API 或日志复制的一批标识符可能混有多个版本。UUID 解码器先检查文本格式,再按变体与版本决定能读取哪些字段,让 UUID 解析不止停留在一条正则表达式。
UUID 验证器通过格式检查,并不等于记录存在或生成过程正确。UUID 时间戳只是标识符中的编码值,可以来自测试数据、自定义时钟或被复制的旧标识。
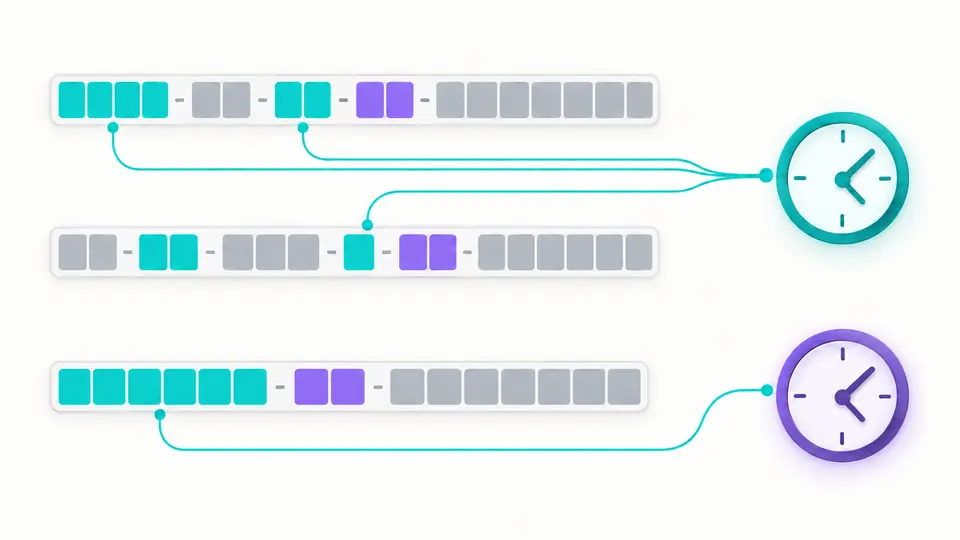
UUID 解码器分别处理 v1、v6 的 Gregorian 计时和 v7 的 Unix 毫秒值。v4 不含标准时间字段,因此不会把随机内容解释为业务事件的日期。
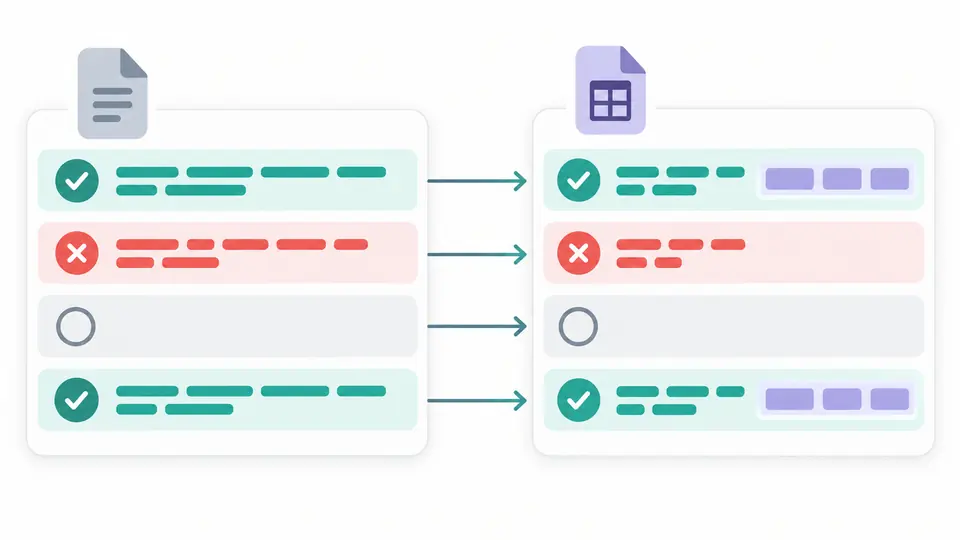
一个错误标识不会中断相邻行。报告保留原输入、行号、错误与空行,便于和原日志逐项对照,避免有效总数掩盖漏掉的数据。
每行应为 8-4-4-4-12 分组的十六进制值。大写字母可以接受,但不会自动去掉前后空格、花括号或 URN 前缀。
默认在最后一次编辑后等待 350 ms 自动解码。关闭自动运行后,可点击按钮或按 Ctrl/Cmd+Enter 执行。
字段面板展示首个格式有效的 UUID;JSON 报告包含全部行,包括未支持的布局和预览之外的错误。
读取变体位并区分 NCS、RFC、Microsoft 与保留布局。非 RFC 布局只做分类,不套用 RFC 时间公式。
识别 1–8 的版本编号,以及全零 Nil 和全一 Max。未知版本与文本格式错误分开标记。
v1/v6 的 Gregorian 计数以十进制字符串保留,另列不足一毫秒的 100 ns 余数;v7 提取前 48 位 Unix 毫秒字段。
复制或下载包含原输入和逐行结论的完整结果。分批显示仅影响预览,不会截短导出内容。
不能。v4 的标准布局不包含时间字段。UUID 解码器会显示版本与变体,不把随机位转成日期;如需实际事件时间,应查看应用单独记录的时间。
v1/v6 的编码单位是 100 ns,v7 的标准时间字段单位是毫秒。这是字段分辨率,并不表示系统时钟有同样的准确度,也不能证明真实创建时间。
本页不提供版本转换。仅修改版本数字会改变标识值,而且不会自动使其它位符合目标生成方法。某些版本布局可专门转换,但需要明确的转换规则。
不能仅凭 node 判定。v1/v6 可以使用生成的节点值;即使数值看似 MAC 地址,也不证明当前设备身份。multicast 位只是一个可读取的标志。
先检查 36 字符的 8-4-4-4-12 十六进制形式,再看变体、版本编号和特殊值分类。格式正确不代表其唯一、真实或生成过程合规。
发现结果与预期不符?