Kennungen und Zeit

Snowflake ID Decoder

Wähle das Layout des ausstellenden Systems.

Snowflake ID Decoder

Dezimale Snowflake-ID

Ergebnisbericht

Alle ID-Berechnungen laufen im Browser; Eingaben werden nicht hochgeladen.

Optionen

Eine dezimale ID, maximal 256 Zeichen. Keine URLs oder Listen.

Twitter snowflake-2010: 41/5/5/12. Oberer Knoten = Rechenzentrum, unterer = Worker; reserviertes Vorzeichenbit 0. Quelle ansehen

ID eingeben oder Beispiel laden.

Der Snowflake ID Decoder hilft, wenn im Log nur eine Kennung steht und kein separates Erstellungsdatum. Entscheidend ist das Schema des ausstellenden Systems. Dieselbe Zahl kann unter verschiedenen Epochen plausible, aber unterschiedliche Daten ergeben. Prüfe deshalb die Konfiguration, bevor du daraus eine zeitliche Reihenfolge ableitest.

Warum dieser Snowflake ID Decoder?

Die Unterschiede der Plattformen sehen

Dieser Snowflake ID Decoder trennt das archivierte Twitter-Original von Discord. Das Zeitfeld umfasst 41 beziehungsweise 42 Bits; auch die beiden Knotenhälften haben andere Bedeutungen. Epoche und Quellenlink bleiben sichtbar, damit du eine Abweichung gegen die richtige Spezifikation prüfen kannst.

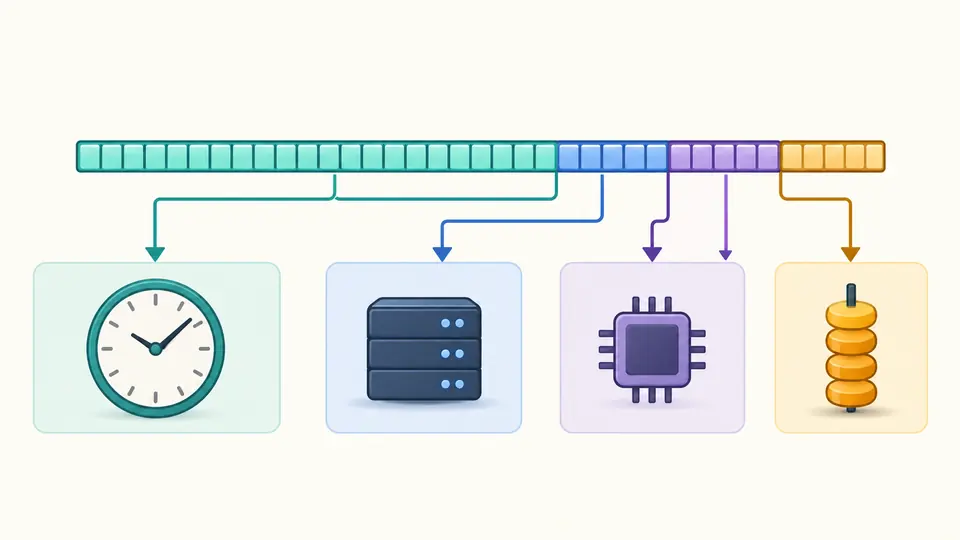
Eine Kennung wird in Zeit, zwei Knotenhälften und Sequenz zerlegt; eine Uhr ist mit dem Zeitfeld verbunden.

Einen Fehlerfall gezielt nachbauen

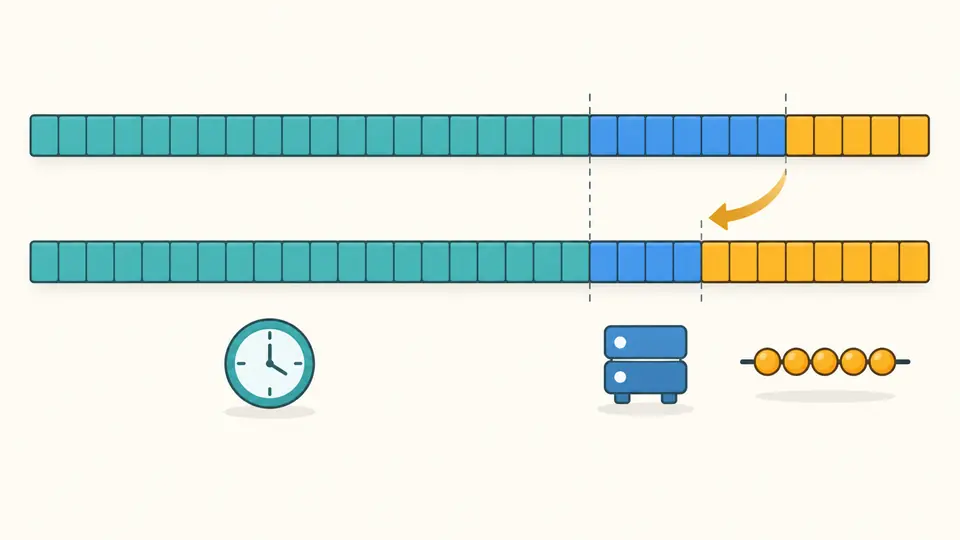
Ein fester Zeitpunkt, Knoten und Sequenzwert ergeben immer dieselbe Testkennung. Vergleiche die Bitgruppen mit den Masken deiner Anwendung. Im eigenen Layout lassen sich Feldgrenzen verschieben, um eine falsche Bitzuordnung nachvollziehbar zu machen, ohne Datensätze anzufassen.

Zwei zusammenhängende Bitlayouts mit unterschiedlichen Grenzen zwischen Zeit, Knoten und Sequenz.

Drei Annahmen zuerst prüfen

01

Das Ursprungsschema auswählen

Twitter Original bezeichnet den archivierten Stand snowflake-2010. Discord nutzt sein dokumentiertes vorzeichenloses Format. Für einen eigenen Dienst brauchst du dessen Epoche und Bitbreiten; die Kennung liefert diese Angaben nicht mit.

02

Einheiten und Knotenhälften prüfen

Epoche und Erzeugungszeit sind Unix-Millisekunden. Der kombinierte Knoten ist oberer Wert × 32 + unterer Wert. Bei Twitter sind das Rechenzentrum und Worker, bei Discord Worker und Prozess.

03

Nur einen aktuellen Stand exportieren

Automatisches Dekodieren wartet nach einer Änderung 350 ms. Ausgeschaltet lässt es sich per Schaltfläche oder Ctrl/Cmd + Enter auslösen. Geänderte Werte sperren den Export bis zum nächsten Erfolg; Test-IDs werden immer ausdrücklich erzeugt.

Die Felder hinter der Zahl

Jede Dezimalstelle erhalten

Der Decoder liest die Zeichenfolge direkt als BigInt. Die Discord-Kennung 175928847299117063 ergibt 2016-04-30T11:18:25.796Z, Knoten 32 und Sequenz 7. Benachbarte IDs bleiben unterscheidbar, auch wenn eine Gleitkommazahl sie auf denselben Wert runden würde.

Zeit und Bitgruppen zusammen lesen

Der Bericht enthält UTC, Unix-Millisekunden und den Abstand zur Epoche. Die Binärgruppen behalten führende Nullen. Twitter zeigt zusätzlich sein reserviertes Null-Vorzeichenbit; Discord verwendet alle 64 Bits für die Felder.

Eigene Epoche und Feldbreiten

Zeit, Knoten und Sequenz stehen lückenlos von oben nach unten. Knoten und Sequenz dürfen null Bits haben und dann nur den Wert null enthalten. So lässt sich eine andere Aufteilung testen, ohne sie irrtümlich als Plattformstandard zu bezeichnen.

Wiederholbare Testdaten erzeugen

Der Snowflake ID Generator setzt Zeit, Knoten und Sequenz zusammen und zerlegt das Ergebnis sofort wieder. Ein leeres Zeitfeld verwendet die Uhr beim Ausführen. Eine explizite Millisekundenangabe macht den Fall reproduzierbar. Kopiere die Kennung oder lade den vollständigen JSON-Bericht herunter.

Aussagekraft und Grenzen

Keine Plattform aus der Zahl erraten
Ein Discord Zeitstempel kann mit Twitters Epoche um Jahre verschoben erscheinen und trotzdem plausibel wirken. Der gewählte Standard beweist keine Herkunft. Twitter Original steht zudem nicht für jede aktuelle interne Variante von X.
Millisekunden und maximal 64 Bits
Nur zusammenhängende Felder in der Reihenfolge Zeit, Knoten, Sequenz sind vorgesehen. Zeit benötigt mindestens ein Bit. Sekunden, Mikrosekunden, verteilte Bitpositionen und andere Feldfolgen werden nicht unterstützt.
Eine dezimale Kennung pro Durchlauf
Erlaubt sind Rand-Leerzeichen und führende Nullen. Negative IDs, Brüche, Exponentialschreibweise, Hexwerte, URLs und mehrere Werte werden abgelehnt. Jedes Zahlenfeld ist auf 256 Zeichen begrenzt; Ganzzahlen bleiben im Export Zeichenfolgen.
Keine verteilte Vergabe eindeutiger IDs
Gleiche Parameter erzeugen dieselbe ID. Es gibt keine Worker-Vergabe, keinen dauerhaften Zähler und keine Koordination bei rückwärts laufender Uhr. Null und zukünftige Zeiten sind gültige Testfälle, wenn sie in das Layout passen.
Keine Abfrage von Konten oder Beiträgen
Knotenwerte verraten weder Nutzernamen noch Standort oder Nachrichteninhalt. Eine API-Prüfung auf Existenz findet nicht statt. Zeiten außerhalb des unterstützten Date-Bereichs werden ausdrücklich abgelehnt und nicht abgeschnitten.

Snowflake ID Decoder: Fragen

Wie erhalte ich aus einer Discord-ID die Erstellungszeit?

Wähle Discord und füge die ursprüngliche Zeichenfolge ein. Der Snowflake ID Decoder entfernt die unteren 22 Bits und addiert 1420070400000 Millisekunden. Die UTC-Ausgabe beschreibt die codierte Zeit, bestätigt aber nicht unabhängig die Existenz einer Nachricht.

Was unterscheidet die Epochen von Twitter und Discord?

Twitter Original beginnt bei 1288834974657 ms, Discord bei 1420070400000 ms. Auch das Zeitfeld unterscheidet sich mit 41 beziehungsweise 42 Bits. Nur die Epoche auszutauschen reicht für eine vollständige Formatprüfung nicht aus.

Warum enden die Knotenhälften bei 31 und die Sequenz bei 4095?

Fünf Bits je Hälfte erlauben 0–31, zusammen zehn Bits also 0–1023. Die zwölf Sequenzbits erlauben 0–4095. Größere Werte werden abgelehnt, damit sie nicht in das benachbarte Feld überlaufen.

Kann ich die Epoche meines eigenen Dienstes verwenden?

Ja. Wähle das eigene Layout und trage die vorzeichenbehaftete Unix-Millisekundenepoche sowie alle drei Breiten ein. Die Erzeugungszeit darf nicht davor liegen; ihr Abstand zur Epoche muss in das Zeitfeld passen.

Warum fehlen am Ende meiner eingefügten ID Ziffern?

Ein vorheriges Programm kann die Zahl bereits gerundet haben. BigInt verhindert neue Rundung, kann verlorene Stellen aber nicht rekonstruieren. Hole den Wert aus der ursprünglichen Zeichenfolge, bevor Tabellen oder JSON-Zahlenparser ihn umwandeln.

Fehlt ein Layoutdetail?

Die nächste Kennung prüfen

Der Snowflake ID Decoder hält die Annahmen zur Kennung im Bericht fest. Prüfe Zeit und untere Felder, bevor du das Ergebnis in deine Fehleranalyse übernimmst.