Kennungen

ULID-Generatorund Zeitdecoder

Neue IDs ausdrücklich erzeugen oder vorhandene Werte zeilenweise prüfen. Die Dekodierung kann automatisch aktualisiert werden.

ULID-Generator

Eingabe

Leer lassen, um die aktuelle Millisekunde einmal für diesen Stapel zu lesen. Sonst eine Ganzzahl von 0 bis 281474976710655 eingeben. Keine Erkennung von Sekunden oder ISO-Daten.

Die Verarbeitung erfolgt in diesem Browser. Eingaben werden nicht an einen Server gesendet.

Ergebnis

Einstellungen

Aktiv: erste 80-Bit-Endung zufällig wählen, danach jeweils um eins erhöhen. Inaktiv: jede Endung unabhängig ziehen. Zwischen getrennten Erzeugungsvorgängen gilt keine Reihenfolgegarantie.

1–1.000 IDs; Dekodierung bis 1.000 physische Zeilen und 100.000 UTF-16-Codeeinheiten. Der Export enthält alle Ergebnisse.

Einstellungen wählen und starten.

Wenn die Reihenfolge von IDs in einem Protokoll überrascht, lohnt sich ein Blick auf Zeitpräfix und Zufallsteil. Der ULID-Generator zeigt, ob verschiedene Millisekunden oder unterschiedliche Endungen innerhalb derselben Millisekunde die Ursache sind.

Ein festgelegter Zeitpunkt erleichtert vergleichbare Testdaten, fixiert aber keine Zufallswerte. Beim Sortieren vorhandener IDs bleibt die Eingabe erhalten; die ursprüngliche Zeilennummer verbindet jeden Berichtseintrag mit seiner Quelle.

Was der ULID-Generator sichtbar macht

Millisekunden neben dem lesbaren Datum

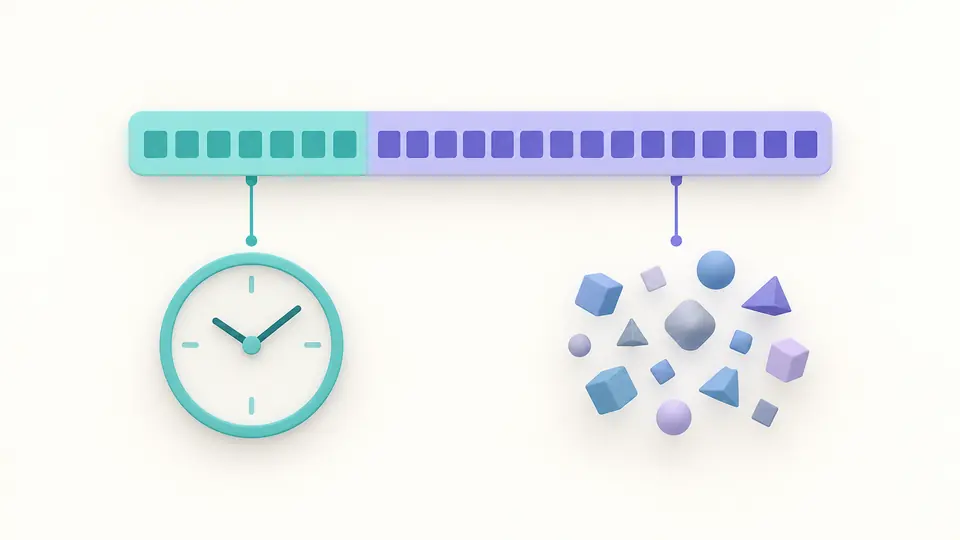
Der ULID-Generator trennt die zehn Zeitzeichen von den sechzehn Zufallszeichen. Der ganzzahlige Zeitwert steht neben UTC, sodass eine versehentliche Eingabe in Sekunden nicht durch eine hübsche Datumsanzeige verdeckt wird.

Ein Bezeichner wird in ein mit einer Uhr verbundenes Präfix und einen undurchsichtigen Zufallsteil zerlegt.

Sortieren mit nachvollziehbarer Herkunft

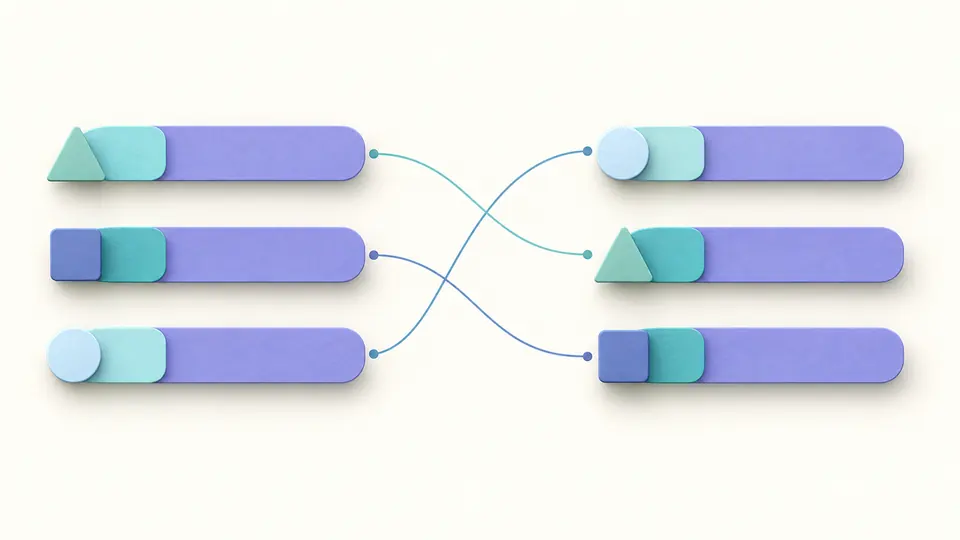
Jeder Eintrag behält sourceLine. Auch doppelte Werte bleiben getrennt erhalten, und die Eingabe wird nicht umgestellt. So lässt sich eine neue Ergebnisposition zuverlässig der ursprünglichen Zeile zuordnen.

Verbindungslinien ordnen unsortierte Bezeichner ihren sortierten Positionen zu.

Zeitbasis und Geltungsbereich festlegen

01

Mit einem festen Zeitpunkt vergleichen

Das Beispiel im Erzeugungsmodus trägt nur Millisekunden ein und erzeugt noch keine IDs. Nur ein leeres Zeitfeld bedeutet jetzt; 1700000000 wird ebenfalls wörtlich als Millisekunden gelesen.

  • Die Uhr wird pro Stapel genau einmal abgefragt.
02

Die gewünschte Monotonie wählen

Im monotonen Modus steigt die Endung innerhalb eines Stapels um eins. Ohne ihn können unabhängige Zufallswerte derselben Millisekunde anders sortiert sein als ihre Erzeugungsreihenfolge.

  • Ein weiterer Klick übernimmt keine Endung aus dem vorherigen Stapel.
03

ULID dekodieren und die Herkunft prüfen

Das Dekodierbeispiel ist absichtlich durcheinander. ASCII aufsteigend wählen und sourceLine vergleichen. Automatik wartet 350 ms; ausgeschaltet stehen die Schaltfläche und Ctrl/Cmd+Enter bereit.

  • Änderungen sperren den Export sofort. Beispiel und Leeren zeigen eine Vorschau mit einmaligem Rückgängig.

Von Testwerten zu prüfbaren Feldern

Stapel mit gleichem Zeitpräfix

1–1.000 kanonische Großbuchstabenwerte erzeugen. Ein fester Zeitpunkt bestimmt nur das Präfix. Der erste Zufallsteil kommt aus sicheren Zufallsbytes; weitere Werte werden erhöht oder unabhängig gezogen.

Zeitstempel vollständig auslesen

Der Bericht enthält Unix-Millisekunden, UTC im ISO-Format, beide Zeichenabschnitte und den Zufallsteil als Hexadezimalzahl. Aus der Endung wird keine Benutzer- oder Maschinenkennung abgeleitet.

Fehler mit Originalposition

Falsche Länge, ungültige Zeichen und Überlauf werden mit Zeile und Spalte angezeigt. Ein fehlerhafter Eintrag lässt die gesamte Dekodierung scheitern; kein stilles Weglassen beim Export.

Vollständige Dateien trotz kurzer Vorschau

Die Vorschau beginnt mit 50 Zeilen und wächst um jeweils 100. TXT enthält die erzeugten IDs; JSON enthält Stapelmetadaten beziehungsweise alle dekodierten Felder, auch außerhalb der sichtbaren Vorschau.

Grenzen von Format und Reihenfolge

Nur Groß- und Kleinschreibung tolerieren
Genau 26 ASCII-Zeichen aus Crockford Base32 pro Zeile. Keine Korrektur von I/L zu 1 oder O zu 0. Leerzeilen, Abstände, Anführungszeichen und Bindestriche sind Fehler; doppelte Werte bleiben erhalten.
48 Bit für vorzeichenlose Millisekunden
Der Bereich ist 0–281474976710655; das erste Zeichen muss 0–7 sein. Sehr weit zukünftige Zeiten können formal gültig sein. Ein eingebetteter Zeitpunkt beweist weder Erstellung noch Datenbankeinfügung.
Monotonie endet an der Stapelgrenze
Ein Überlauf der 80-Bit-Endung verwirft den Stapel. Weder Zeit noch Zufall werden heimlich korrigiert. Klicks, Tabs und Geräte teilen keinen Zustand, auch wenn derselbe Zeitpunkt erneut eingegeben wird.
Keine UUID und kein Geheimnis
Gleiche 128-Bit-Breite bedeutet keine identische Text- oder Versionsstruktur. Es gibt keine UUID-Konvertierung oder Prüfung vorhandener Datensätze. Lesbare Zeit und vorhersagbare monotone Nachbarn eignen sich nicht als Passwort oder Zugriffstoken.
Begrenzte, ausdrückliche Ein- und Ausgabe
Maximal 1.000 erzeugte IDs sowie 1.000 physische Eingabezeilen und 100.000 UTF-16-Codeeinheiten. Kein Datei- oder URL-Import, SQL-Wrapper, Entfernen von Duplikaten oder Zurückschreiben sortierter Eingaben.

Fragen zum ULID-Generator

Worin unterscheiden sich ULID und UUID?

ULIDs verwenden 26 Base32-Zeichen mit einem 48-Bit-Millisekundenpräfix. UUIDs besitzen versionsabhängige Felder und werden meist als 36 Zeichen lange Hexadezimalzeichenfolge geschrieben. Die gleiche Speicherbreite macht die Texte nicht austauschbar.

Welche Informationen stecken in den 26 Zeichen einer ULID?

Die ersten zehn Zeichen bilden die Zeit ab, die übrigen sechzehn den 80-Bit-Zufallsteil. Weil 26 Base32-Zeichen 130 Bit aufnehmen könnten, nutzt das erste Zeichen nur drei Bits und darf höchstens 7 sein.

Was ist Monotonie bei ULIDs?

Der ULID-Generator erhöht nach einem zufälligen Start die Endung innerhalb eines Stapels jeweils um eins. Ein erfolgreicher Stapel ist damit streng aufsteigend. Getrennte Vorgänge oder verteilte Rechner erhalten keine gemeinsame Reihenfolgegarantie.

Welchen Zeichensatz verwendet ULID?

Crockford Base32 verwendet Ziffern und lateinische Buchstaben ohne I, L, O und U. Diese Seite akzeptiert gültige Kleinbuchstaben und normalisiert sie zu Großbuchstaben. Verwechslungen mit Ziffern werden nicht automatisch repariert.

Kann ich die Erstellungszeit aus einem ULID wiederherstellen?

Ja, die ersten zehn Zeichen lassen sich in Unix-Millisekunden und UTC umrechnen. Der Zeitpunkt kann jedoch frei gewählt oder durch eine ungenaue Uhr bestimmt worden sein. Sie erhalten das kodierte Datum, keinen Nachweis des tatsächlichen Erstellungszeitpunkts.

Eine Frage zu einer Kennung?

ULID-Generator ausprobieren

Mit dem ULID-Generator einen kleinen Teststapel für einen festen Zeitpunkt erzeugen und anschließend die sortierten Beispielwerte anhand ihrer Quellzeilen vergleichen.