01
Укажите конкретную кодировку
По умолчанию выбрана o200k_base. Если нужен другой реализованный словарь, переключитесь на cl100k_base. ID токенов относятся к выбранной кодировке, а не к любому похожему названию модели.
Инструменты ИИ / LLM
Выберите реализованную кодировку, изучите ID и задайте собственный размер окна контекста.
Текст остаётся в браузере. Данные словаря могут загрузиться один раз; запрос не отправляется в API модели.
Введите текст для подсчёта.
Введите текст для подсчёта.
Короткий на вид запрос с кодом, знаками препинания или несколькими языками может разбиться на неожиданно много частей. Счётчик токенов показывает реальные ID выбранного словаря вместо оценки по числу символов.
Для пакета каждый элемент массива JSON считается отдельным запросом. Счётчик токенов суммирует общий объём работы, а остаток окна рассчитывает по каждому элементу.
Счётчик токенов выводит каждый ID выбранного словаря BPE. Пробел перед словом, перевод строки и кириллица могут менять разбиение. Границы байтов сохраняются даже там, где один символ Unicode занимает несколько ID.
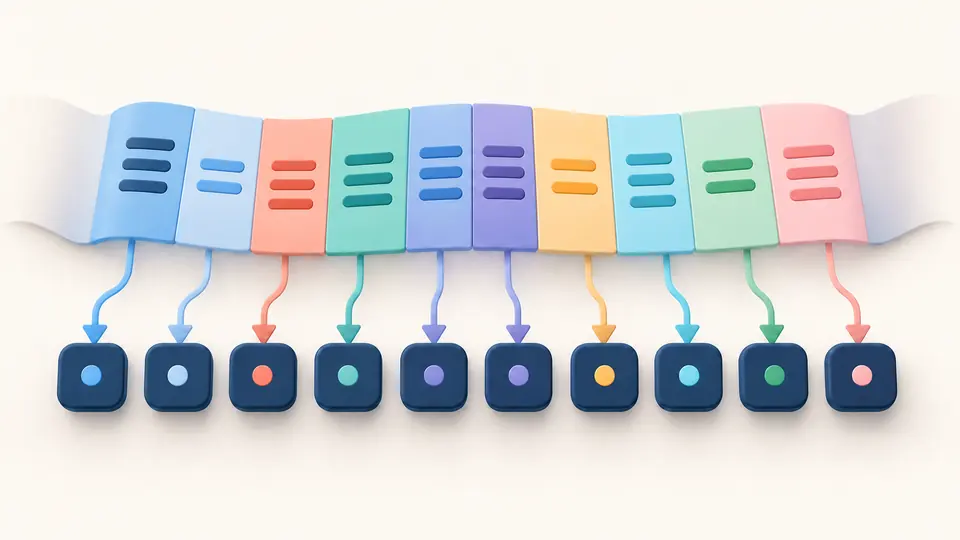
Пакет не использует одно общее окно контекста. Счётчик токенов заново кодирует каждый элемент с общими префиксом и суффиксом, затем учитывает резерв ответа и добавку, которую вы оценили сами. Сумма пакета показывает нагрузку, а не одну заявку.
По умолчанию выбрана o200k_base. Если нужен другой реализованный словарь, переключитесь на cl100k_base. ID токенов относятся к выбранной кодировке, а не к любому похожему названию модели.
Режим пакета принимает массив строк JSON. Перевод строки внутри одного элемента остаётся в нём. Автоподсчёт ждёт 350 мс после правки; в ручном режиме можно нажать Ctrl/Cmd+Enter.
Префикс и суффикс кодируются вместе с текстом. Из-за слияния BPE на границе разница бывает отрицательной. Введите размер окна, резерв ответа и известную добавку; устаревший результат нельзя экспортировать.
Вместо деления числа символов на четыре доступен токенизатор онлайн с o200k_base и cl100k_base. Каждый ID и байт UTF-8 соответствует выбранному словарю.
До 100 строк JSON считаются отдельно, включая запросы с переводами строк. На экране открывается по 50 элементов, но выгрузка JSON содержит все значения и ID.
Общие префикс и суффикс присоединяются к каждому тексту. Отдельно показаны токены источника, итогового текста и разница; простое сложение частей может ошибаться.
Вы задаёте размер окна и резерв ответа. Дополнительная упаковка остаётся вашей оценкой; сервис не подставляет тайком лимиты моделей или цены. Контекстное окно задаётся вашим числом.
У словарей разные правила объединения. Сравните один текст в o200k_base и cl100k_base, чтобы увидеть разницу между двумя реализованными кодировками.
Нет. Это лишь грубый ориентир для английской прозы. Код, пробелы и кириллицу лучше измерять на реальном тексте.
Нет. Статический словарь загружается в браузер, а текст обрабатывается локально без обращения к API модели.
Чтобы оценить, поместятся ли ввод и ожидаемый ответ в заданный контекст. Реальные ограничения модели нужно проверить отдельно.
Не как точное число. У этих поставщиков иные токенизаторы; используйте их средство подсчёта для нужного запроса.
API может учитывать границы сообщений, системный текст, инструменты, вложения и результат генерации. Здесь есть только введённый текст и ваша оценка добавки.
Неожиданный результат?
Вставьте типичный текст или массив JSON, изучите ID и укажите размер контекста для вашей настоящей заявки.