01
拿序列化后的数据来算
UTF-8 模式保留原文,不做 trim。Hex 可以夹带 ASCII 空白,但须是完整字节对且不带 0x;标准 Base64 需要补齐规定的填充。切换编码只是重新解释当前输入,不会自动改写文本。
协议 / 二进制序列化
输入一个 key 和分区总数,按明确选择的兼容 Java Murmur2 算法计算。
文本按原样保留,包括空格和换行。字节 key 可以为空;缺失 key 请明确选择 null。
68 65 6c 6c 6f
计算在当前浏览器标签页完成,不发送或保存 key,也不连接 Kafka 集群。
适用于兼容 Java 的有键 Murmur2 路由。显式分区、忽略 key、自定义序列化器或其他分区器都可能改变实际去向。
计算完成。
日志里的消息 key 看起来相同,实际分区却不一致,问题可能发生在序列化之后。Kafka 分区计算把字节、哈希和取模结果放在一起,让你先判断是输入发生了变化,还是生产者采用了另一种路由策略。
排查时应拿到序列化字节,而不只是业务对象的展示值。整数的二进制表示和十进制文本不是同一组字节;从日志复制时多出的换行也会参与哈希。对非字符串序列化器,使用 Hex 或 Base64 更容易复现实际输入。
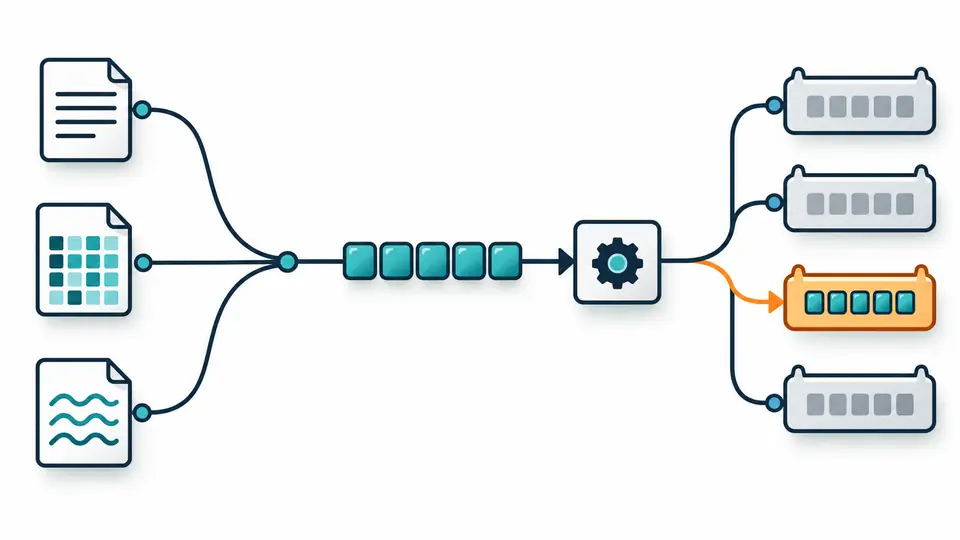
Kafka 分区计算支持三种输入方式,并展示解码后的十六进制序列。同一组字节无论来自文本、Hex 还是 Base64,都应得到相同哈希;首尾空格、多字节字符和零字节则能在预览中直接核对。
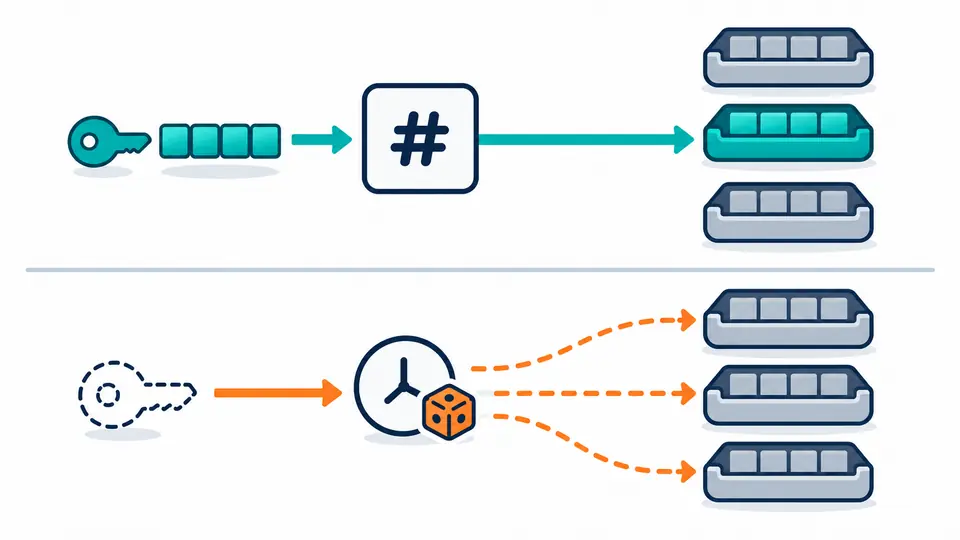
空字符串经 UTF-8 编码后得到长度为零的字节数组,它仍能参与确定性哈希。null 表示没有 key,可能进入依赖批次和运行状态的策略。面板会明确显示无法确定固定分区,不把 null 偷换成分区 0。
UTF-8 模式保留原文,不做 trim。Hex 可以夹带 ASCII 空白,但须是完整字节对且不带 0x;标准 Base64 需要补齐规定的填充。切换编码只是重新解释当前输入,不会自动改写文本。
默认的 12 只是示例,不能当作容量建议。分区编号从 0 开始,12 个分区对应 0 到 11。分区数增加后,哈希可能完全不变,但取模得到的未来写入位置可能改变。
展开测试向量,加载 abc 或 foobar,再对照预期有符号哈希。自动计算等待输入停顿 350ms;关闭后可按 Ctrl/Cmd + Enter 手动运行。结果过期时,复制和下载会禁用。
使用种子 0x9747b28c、四字节小端分组和 32 位乘法。有符号与无符号显示代表相同位模式;路由前用 0x7fffffff 清除符号位。这个操作不是求绝对值,负哈希直接取绝对值可能导向另一个分区。
文本保留大小写、换行和 Unicode 形式;Hex 与标准 Base64 可表达任意字节,包括 00 和 ff。奇数位十六进制、错误填充、无效的 Base64 末尾位都会报错,避免容错解码悄悄改变输入。
面板列出 abc、foobar、21 的 Apache Kafka 官方预期值。字节预览先显示 100 字节,每次再展开 100;导出的 JSON 保留完整字节、算法、编码、key 类型、分区总数及各阶段数值,便于和客户端日志逐项比较。
当生产者确实使用选定的有键路由时,对序列化字节执行 Murmur2,清除符号位,再对分区总数取模。例如 abc 的有符号哈希为 479470107,在 12 个分区时得到分区 3。实际分区总数应从主题元数据核实。
先检查是不是一直使用同一个 key,或当前主题只有一个分区。不同 key 也可能在取模后落入同一分区,这不一定是哈希碰撞。对于缺失 key 的记录,还需要核对客户端的 sticky 等批次策略,不能从少量消息推断总体分布。
首先逐字节比较序列化输出,再核对分区总数、算法和配置。不同客户端的默认分区器未必一致,显式分区或忽略 key 也会覆盖有键路由。消费者再均衡改变分区的消费归属,并不会直接改变这个哈希公式。
不是必须。是否需要 key 取决于业务的分组和顺序要求。未指定 key 的记录仍可发送,但其去向不再能仅用这里的有键 Murmur2 公式确定。选择 null 模式即可查看这一边界;空字符串则是另一种输入。
由客户端版本、配置及批次等运行时状态决定。现代 Java 生产者可以采用 sticky 行为,其他客户端也有自己的策略。因此本工具不给 null 填入固定分区,也不会按旧资料简单地宣称必然轮询。
Kafka 的这套 Murmur2 使用固定种子 0x9747b28c。序列化字节完全相同时,重复运行的哈希应一致。但最终分区还取决于分区总数和实际分区器;改变取模除数或切换算法后,去向仍可能变化。
发现计算或校验问题?