01
辨别输入的含义
编码时可选 UTF-8、十六进制字节对或十进制字节。后者只接受 0–255 的数字,以半角空白分隔;不能粘贴带逗号、方括号的数组,也不能把整个十进制整数当成一个字节。
编码与转义
先确认输入代表文本还是字节,再选择与来源一致的编码变体。
转换仅在当前浏览器内进行,输入不会上传。
输入可选 UTF-8 文本、十六进制字节对或以空白分隔的 0–255 十进制字节。不接受 0x 前缀、逗号或数组括号。
Base32 必须大写;Base58 不校验地址;Z85 必须满足 4 字节/5 字符整组。
总输入最多 65,536 个 UTF-16 单位,批量最多 1,000 个物理行。单项最多 65,536 字节;Base58 为 4,096 字节/5,600 字符。完整报告最多 2,000,000 字符,计算限时 2 秒。
输入文本或载入示例。空输入会转换为空结果。
Base 编码转换常用于排查“另一端能读,这一端却解不出来”的值。问题可能出在字母表,也可能是把十六进制当成了普通文本。例如输入 41,文本模式得到两个字符的字节,十六进制模式则得到字母 A 的一个字节。
这里把 Base32 编码、Base58 解码和 Base85 编码放在同一工作台,同时展示字节。中文、表情符号按 UTF-8 处理;二进制数据可直接使用十六进制字节或十进制列表,不必强行解释成文字。
Base 编码转换分别标出 Bitcoin 与 Flickr 字母表,也区分 Ascii85、Git b85 和 Z85。批量报告记录当前选项,接收结果的人可以按同一规则重现,不需要根据字符外观猜测算法。
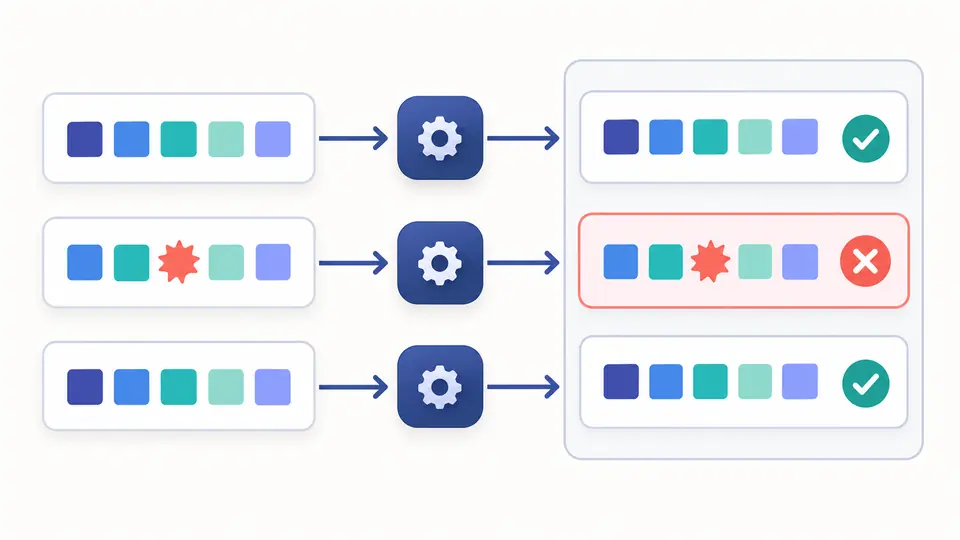
批量中间一行含非法字符时,其余行照常处理。报告保留原行号、错误和已有字节信息;解码结果中的换行被保存在 JSON 字符串内部,不会把一条结果误拆成多条。
编码时可选 UTF-8、十六进制字节对或十进制字节。后者只接受 0–255 的数字,以半角空白分隔;不能粘贴带逗号、方括号的数组,也不能把整个十进制整数当成一个字节。
Base32 的 padding 开关只影响编码。Ascii85 的包裹标记不会用于 Git b85。Z85 输入必须是 4 字节的倍数,工具不会擅自补零;示例按钮会按当前方式生成兼容内容。
字节详情中可对照十六进制与十进制值。关闭自动转换后使用 Ctrl/Cmd + Enter 执行;反向转换先显示替换预览,应用后才切换方向。撤销会同时恢复原输入、参数和结果。
Base16 每字节输出两个大写十六进制字符,解码兼容小写。标准 Base32 使用 A–Z 和 2–7,base32hex 使用 0–9 和 A–V。base32hex 是另一套字母表,不等于把十六进制输入换个标签。
Bitcoin 与 Flickr 的字符集合相同,排列顺序不同。每个前导零字节都保留为一个 1,避免只转换整数大小而丢失原字节长度。这里的 Bitcoin 选项表示字母表,不代表地址校验。
Ascii85 支持零块缩写 z 和可选的完整 Adobe 包裹;Git b85 使用 RFC 1924 字母表及四字节分组;Z85 使用 ZeroMQ 规则,要求整组。相似的字符串可能在不同入口得到不同字节。
字节转换后提供字节数、十六进制和十进制视图。UTF-8 无效时不会悄悄填入替换字符;错误保留在页面,已经得到的原始字节仍可查看。切换结果表示方式后可重新转换并导出。
先检查长度和末尾等号。MY====== 和 MY 都表示 f,MY= 则是残缺 padding。这里接受完整 padding 或完全不带 padding 的形式,还会检查未使用位是否为零。若仍失败,请确认来源不是 base32hex 或 Crockford。
三者的字母表、包裹与末尾分组规则不同。Ascii85 使用 ! 到 u 的字符,Git b85 对应 Python 的 b85encode 风格,Z85 用于 ZeroMQ。不能把 Ascii85 的 z 或 Adobe 标记直接套在另外两种编码上。
每个前导零字节都编码为一个前导 1。例如 00 00 01 得到 112。这里保留字节序列;如果只把整段数据当作整数,前面的零会被丢弃,结果虽然像 Base58,却无法还原原来的长度。
先将字符编码为 UTF-8 字节,再进行 Base32 编码。中文和表情都可以处理,组合字符不被重新规范化。解码时只有来源本来就是 UTF-8 才应选择文本;否则用十六进制或十进制检查原始字节。
无法可靠自动识别。不同字母表重叠较多,同一字符串可能通过多个解码器却得到不同字节。本页要求显式选择变体;应查询产生该值的协议或库,再用已知样例核对字节数和内容。
Base58Check 在字节载荷外增加版本信息和校验和。本页只做原始 Base58 字节编解码,不创建或验证这层结构。成功解码不代表钱包地址、网络或密钥有效。
遇到了未说明的编码边界?