Encodage et échappement

Encodeur Base32et Base16 / 58 / 85

Précisez la représentation des octets et l’alphabet employé par la source.

Encodeur Base32

Entrée

La conversion reste dans ce navigateur ; votre saisie n’est pas envoyée.

Résultat

Options d’encodage

Texte UTF-8, paires hexadécimales ou octets décimaux de 0 à 255 séparés par des espaces. Sans préfixe 0x, virgule ni crochets.

Base32 exige des majuscules. Base58 ne vérifie aucun checksum. Z85 exige des groupes de 4 octets / 5 caractères.

Entrée : 65 536 unités UTF-16 ; 1 000 lignes. Par valeur : 65 536 octets ; Base58 : 4 096 octets / 5 600 caractères. Rapport : 2 000 000 caractères ; durée : 2 secondes.

Saisissez du texte ou chargez un exemple. Une entrée vide donne une sortie vide.

Un Encodeur Base32 aide à comprendre pourquoi deux bibliothèques produisent des valeurs différentes. Avant même l’alphabet, la représentation compte : 41 en texte contient deux octets, tandis que 41 en hexadécimal désigne l’unique octet de A.

Ce décodeur Base32 réunit aussi Base16, encodage Base58 et variantes Base85. Les caractères accentués passent par UTF-8 ; les données binaires peuvent rester en hexadécimal ou en octets décimaux sans devoir devenir du texte lisible.

Pourquoi utiliser cet Encodeur Base32

Conserver le choix de l’alphabet

Cet Encodeur Base32 distingue RFC 4648 de base32hex. Bitcoin et Flickr, puis Ascii85, Git b85 et Z85 ont également leurs propres choix. Le rapport garde ces paramètres afin que la conversion puisse être reproduite sans deviner le format.

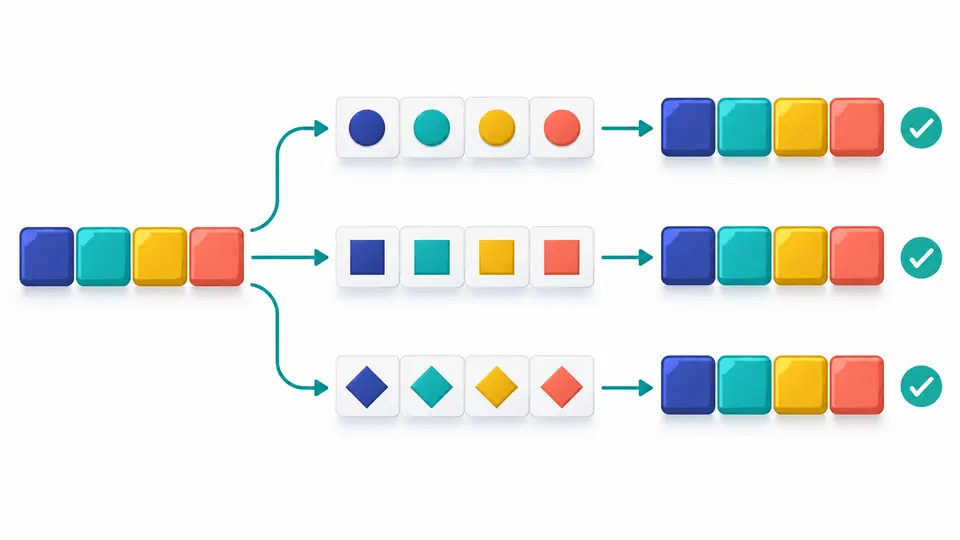
Une suite d’octets traverse plusieurs suites de symboles puis retrouve les mêmes octets.

Retrouver chaque erreur à sa ligne

Un caractère interdit dans une ligne n’efface pas les autres résultats. Chaque élément conserve son numéro de ligne et son erreur. Un saut de ligne décodé reste dans sa chaîne JSON, sans créer artificiellement une ligne de résultat supplémentaire.

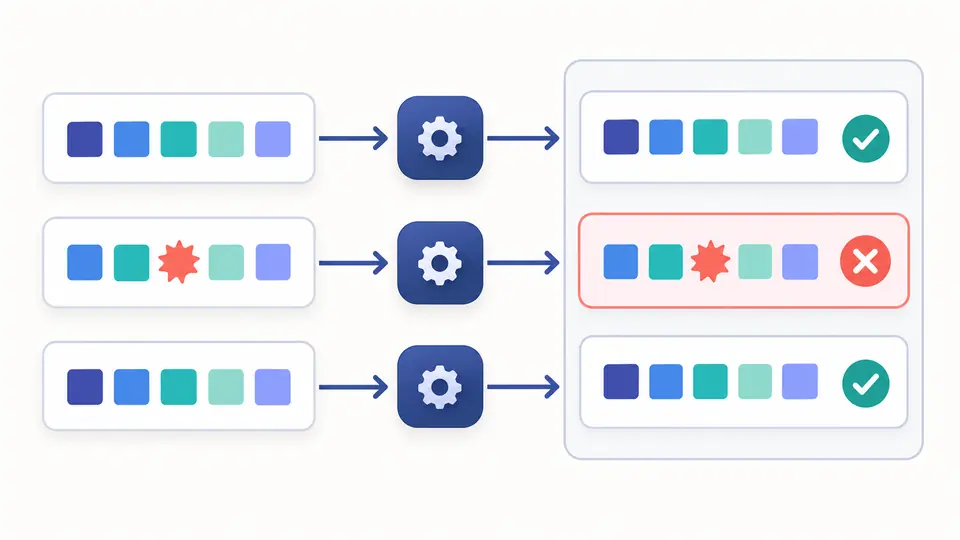
Trois lignes indépendantes donnent deux résultats valides et une erreur visible au centre.

Vérifier les octets avant de changer de sens

01

Distinguer texte et représentation numérique

Le mode hexadécimal attend des paires complètes. Les octets décimaux vont de 0 à 255, séparés par des blancs ASCII. Les virgules, crochets et préfixes 0x ne sont pas supprimés : une liste de code doit être adaptée avant utilisation.

02

Reprendre les conventions de la source

Le remplissage Base32 ne concerne que l’encodage. Les marqueurs Adobe d’Ascii85 ne s’appliquent pas à Git b85. Z85 demande des groupes de quatre octets, sans ajout automatique de zéros. L’exemple respecte le format actuellement choisi.

03

Contrôler la conversion inverse

Ouvrez les détails pour comparer les octets hexadécimaux et décimaux. Sans conversion automatique, Ctrl/Cmd + Entrée lance le calcul. L’inversion propose un aperçu avant de remplacer l’entrée ; l’annulation restaure ensemble les paramètres et les résultats.

Huit variantes, des octets vérifiables

Base16 et deux alphabets Base32

Base16 écrit deux chiffres hexadécimaux majuscules par octet et accepte les minuscules au décodage. Base32 utilise A–Z et 2–7 ; base32hex utilise 0–9 et A–V. Ce dernier est un alphabet différent, pas un synonyme d’entrée hexadécimale.

Deux ordres pour Base58

Bitcoin et Flickr partagent les mêmes caractères dans un ordre différent. Chaque octet nul initial devient un 1 initial. La longueur de la suite d’octets est ainsi conservée, contrairement à une simple conversion de sa valeur entière.

Trois traitements Base85 séparés

Ascii85 accepte z pour un bloc nul complet et des marqueurs Adobe facultatifs. Git b85 utilise l’alphabet du RFC 1924 par blocs de quatre octets. Z85 applique l’alphabet ZeroMQ et impose des groupes complets. La variante détermine donc bien plus que le nom affiché.

Diagnostic binaire sans remplacement silencieux

Le résultat expose le nombre d’octets et les vues hexadécimale et décimale. Un UTF-8 invalide ne devient pas un caractère de remplacement. Les octets obtenus restent consultables, même lorsque la représentation textuelle échoue.

Formes acceptées et limites choisies

Aucune correction implicite
Base32 exige des majuscules, sans correspondance O/0 ou I/1. Le remplissage doit être exact ou absent et les bits inutilisés nuls. Seuls espace ASCII, TAB, CR et LF peuvent être ignorés au décodage. En encodage texte, les blancs restent des données.
Pas de validation d’adresse
Base58Check, préfixes réseau, WIF et adresses de portefeuille ne sont ni créés ni vérifiés. L’alphabet Flickr ne calcule pas les liens courts des identifiants photo. Les alphabets personnalisés, Crockford, Ripple et conversions générales d’entiers sont exclus.
Ne pas mélanger les extensions Base85
Ascii85 accepte les données brutes ou la paire complète <~ ~>, mais pas l’abréviation btoa y ni l’extraction PDF. Git b85 n’est pas l’encodage entier d’une adresse IPv6 du RFC 1924 original. Z85 n’ajoute ni ne retire de zéros ; tout groupe dépassant 32 bits échoue.
Les lots suivent les lignes physiques
CR, LF et CRLF séparent les valeurs. Seules les lignes entièrement vides sont ignorées ; une valeur composée d’espaces demeure. Les erreurs figurent dans le JSON. En mode unique, les retours à la ligne font partie des données ; le rapport de lot ne peut pas être inversé directement.
Budgets de traitement explicites
L’entrée est limitée à 65 536 unités UTF-16 et à 1 000 lignes, vides comprises. Chaque valeur accepte 65 536 octets ; Base58 accepte 4 096 octets ou 5 600 caractères. Au-delà de 2 000 000 caractères de rapport ou deux secondes, le traitement entier échoue.
Texte UTF-8 et aperçu limité
Aucun import de fichier, lecture d’URL, extraction PDF ou détection de charset. Les BOM valides et caractères combinés restent inchangés. L’aperçu affiche 20 000 caractères par valeur et les lots par tranches de 50 ; l’export contient tous les résultats à jour.

Questions sur cet Encodeur Base32

Pourquoi le décodage Base32 renvoie-t-il une erreur de remplissage ?

MY====== et MY représentent tous deux f, mais MY= a un remplissage incomplet. Utilisez le remplissage exact ou omettez-le entièrement. Les bits inutilisés sont également vérifiés. Assurez-vous que la source utilise bien Base32, plutôt que base32hex ou Crockford.

Quelles sont les différences entre Ascii85, Base85 et Z85 ?

L’alphabet, les marqueurs et les groupes finaux diffèrent. Ascii85 utilise ! à u, Git b85 correspond aux blocs de b85encode en Python et Z85 sert à ZeroMQ. Le raccourci z et les marqueurs Adobe ne peuvent pas être transposés aux autres formats.

Comment Base58 conserve-t-il les octets nuls en tête ?

Chaque octet nul initial donne un 1 initial avec les deux alphabets pris en charge. Ainsi, 00 00 01 devient 112. Le convertisseur conserve la suite d’octets, alors qu’une conversion de la seule valeur entière perdrait ces zéros initiaux.

Comment encoder correctement les caractères internationaux et spéciaux en Base32 ?

Les caractères deviennent d’abord des octets UTF-8. Accents, emoji et caractères combinés sont pris en charge sans normalisation. Si les octets originaux ne sont pas du UTF-8, demandez une sortie hexadécimale ou décimale plutôt qu’un texte.

Peut-on reconnaître automatiquement une chaîne Base85 ou Ascii85 ?

Pas de façon fiable. Les alphabets se recouvrent : plusieurs décodeurs peuvent accepter la même chaîne et produire des octets différents. Choisissez le format indiqué par la source, puis vérifiez un exemple connu et le nombre d’octets.

Comment encoder ou décoder une adresse avec Base58Check ?

Base58Check ajoute une version et une somme de contrôle autour des octets. Cette page ne traite que Base58 brut et ne crée ni ne vérifie cette enveloppe. Un décodage réussi ne garantit donc pas la validité d’une adresse ou d’une clé.

Un cas d’encodage à signaler ?

Commencer avec une valeur connue

Utilisez cet Encodeur Base32 sur un exemple court, vérifiez l’alphabet et la représentation des octets, puis passez à plusieurs lignes.