01
バイトの表現を指定する
エンコード時の16進入力は完全な2桁の組で指定します。10進入力は0–255を半角空白で区切ります。0x、配列の括弧、カンマを自動除去しないため、貼り付ける前に表現を確認してください。
エンコードとエスケープ
文字列かバイト列かを確認し、生成元と同じ方式を選びます。
変換はこのブラウザー内で行い、入力は送信しません。
UTF-8テキスト、16進バイト対、空白区切りの0–255の10進バイトに対応。0x、カンマ、配列の括弧は使えません。
Base32は大文字のみ。Base58はチェックサムなし。Z85は4バイト/5文字単位です。
入力65,536 UTF-16単位、最大1,000行。1件65,536バイト、Base58は4,096バイト/5,600文字まで。レポート2,000,000文字、処理2秒まで。
テキストを入力するかサンプルを選んでください。空入力の結果は空文字列です。
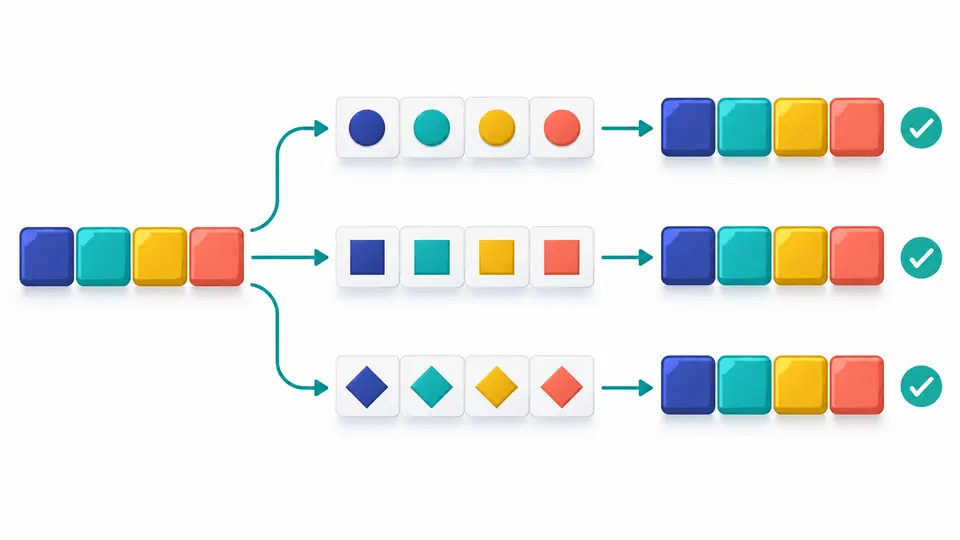
Baseエンコードでは、見た目が同じ入力でも解釈によって結果が変わります。41をテキストとして入力すれば2バイト、16進表現として入力すればAを表す1バイトです。ライブラリ間で結果が合わないときは、この違いから確認できます。
Base32エンコードとBase32デコード、Base58変換、Ascii85などを1ページにまとめています。日本語や絵文字はUTF-8で扱い、文字にならないデータは16進または10進バイトとして入力・確認できます。
BaseエンコードはBitcoinとFlickrを別々に表示し、Ascii85・Git b85・Z85も区別します。バッチレポートには設定が含まれるため、受け取った人が同じ方式で結果を再現できます。
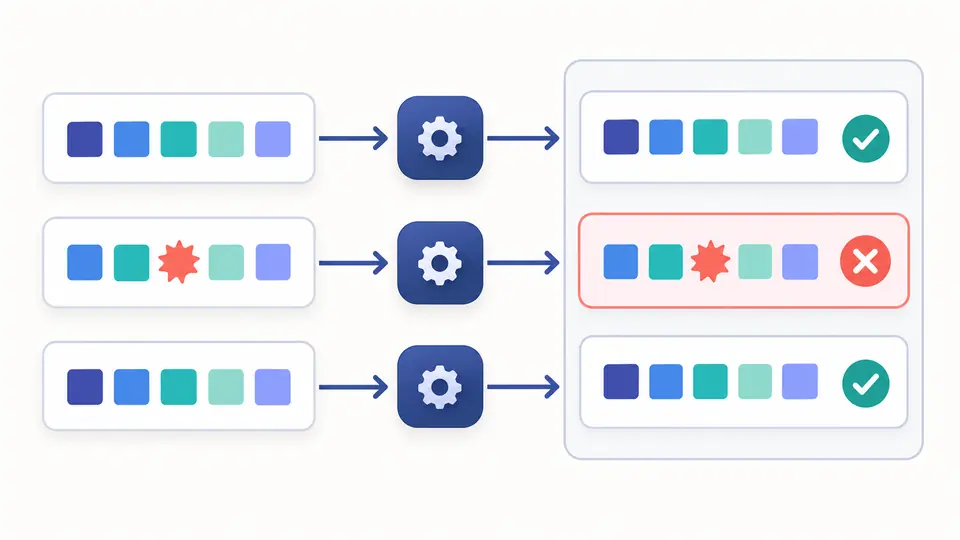
不正な文字がある行も、元の行番号とエラーを残します。ほかの行は変換を続け、デコード結果の改行はJSON文字列内に保持されます。行数だけを見て結果を対応付ける必要がありません。
エンコード時の16進入力は完全な2桁の組で指定します。10進入力は0–255を半角空白で区切ります。0x、配列の括弧、カンマを自動除去しないため、貼り付ける前に表現を確認してください。
Base32のパディング設定はエンコードにだけ影響します。Ascii85の囲みはGit b85には使いません。Z85は4バイト単位で、足りない分を自動的にゼロで埋めることはありません。
バイト詳細で16進と10進を比較できます。自動変換を切るとCtrl/Cmd + Enterで実行できます。逆変換は適用前に入力の置換を表示し、取り消す操作では入力と結果を一緒に戻します。
Base16は1バイトを大文字2桁で出力し、デコードでは小文字も受け付けます。標準Base32はA–Zと2–7、base32hexは0–9とA–Vです。後者は別のアルファベットであり、16進入力の別名ではありません。
BitcoinとFlickrは文字の集合が同じでも並び順が異なります。先頭のゼロバイトごとに1を残します。数値の大きさだけを変換する処理とは異なり、元のバイト数を復元できます。
Ascii85は完全なゼロブロックのz省略と任意のAdobe囲みに対応します。Git b85はRFC 1924の文字表を使う4バイト分割方式です。Z85はZeroMQの文字表と完全なグループを使います。
成功したバイト変換にはバイト数、16進、10進の詳細が付きます。不正なUTF-8を代替文字に置き換えません。エラーがあっても取得できたバイトは残るため、出力表現を変えて内容を確認できます。
MY======とMYはどちらもfを表しますが、MY=は不完全なパディングです。本ツールは正確なパディングか完全な省略を受け付け、末尾の未使用ビットも検査します。生成元がbase32hexやCrockfordでないかも確認してください。
文字表、囲み、短い末尾グループの扱いが異なります。Ascii85は!からuまで、Git b85はPythonのb85encode形式、Z85はZeroMQ用です。Ascii85のzやAdobe囲みをほかの方式へそのまま使うことはできません。
先に文字列をUTF-8バイト列に変換してからBase32にします。日本語や絵文字に対応し、結合文字も正規化しません。元がUTF-8でない場合は、デコード結果をテキストではなく16進か10進で確認してください。
両方のBase58文字表で、先頭のゼロバイト1個につき先頭の1を残します。00 00 01は112になります。整数の大きさだけを変換すると失われる先頭バイトを、このツールでは保持します。
信頼できる自動判別はできません。文字表の重なりが大きく、複数の方式で受理されても復元されるバイトが異なる場合があります。生成元の仕様を確認し、既知の値で選択した方式を検証してください。
Flickrの短縮URLは写真IDを数値としてBase58に変換する処理です。本ページはFlickrの文字表でバイト列を変換します。写真IDをUTF-8テキストとして入力しても同じ計算にはならず、短縮URLも生成しません。
説明のない変換エラーがありましたか?