01
URL向けの記号と=を別々に決める
標準は+と/、URLセーフBase64は-と_を使います。パディングは独立した設定です。デコード時に形式を自動判定しないため、入力側の約束に合わせて文字集合を選びます。
エンコードとエスケープ
文字集合とパディングを指定して、ひとつのテキストを変換します。
変換はこのブラウザー内で行い、入力は送信しません。
UTF-8専用です。デコードでは完全なパディングまたは省略を受け付け、非ゼロの未使用ビットは拒否します。文字集合とUTF-8のバイト列も厳密に検証します。
入力は1,000,000 UTF-16コード単位、出力は4,000,000コード単位まで。空入力も有効です。貼り付け時に改行形式が変わる場合があります。
テキストを入力するかサンプルを選んでください。空入力の結果は空文字列です。
確認後に最新の結果を入力へ移し、方向を切り替えます。結果が入力の上限を超える場合は使えません。
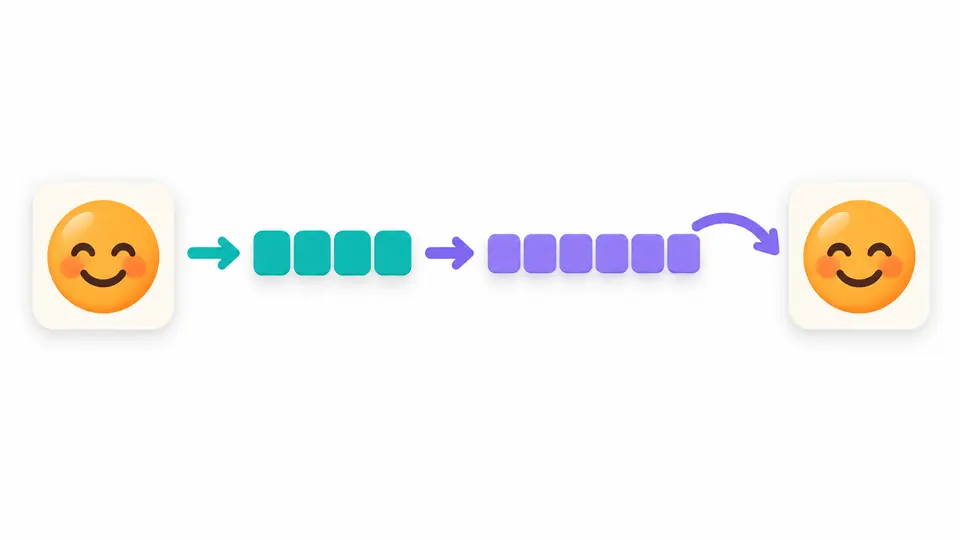
日本語を含む設定値をAPIに渡すときは、見た目の文字数と実際のバイト数を分けて考える必要があります。Base64エンコードでは、まず文章をUTF-8のバイト列にしてからASCII文字で表します。絵文字も同じ手順で扱えます。
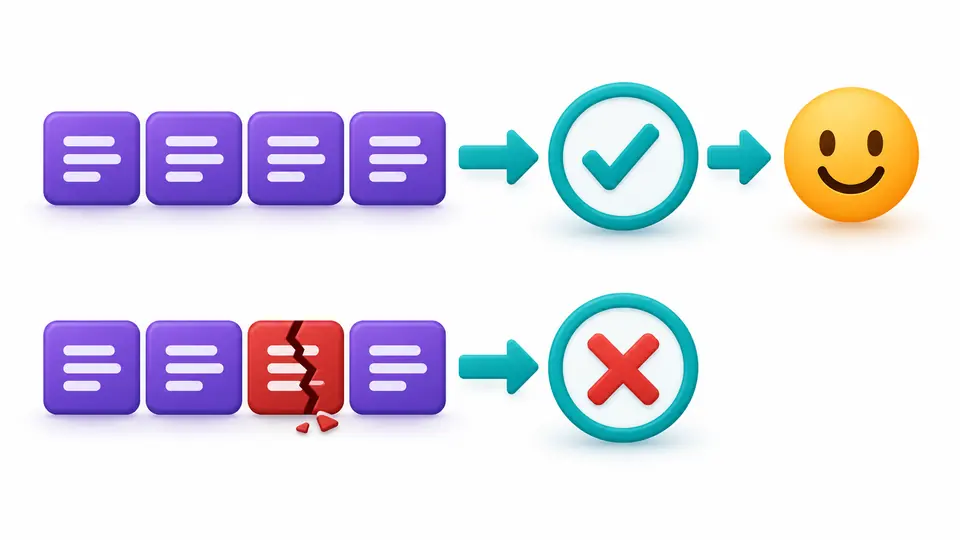
受け取った値を調べる際は、文字列の形が正しいだけでは十分ではありません。このBase64変換ツールは末尾の構造と文字集合を確認したうえでUTF-8を検証し、壊れたバイト列を置換文字でごまかさずにエラーとして返します。
ひらがなや漢字はUTF-8では通常3バイトになります。Base64エンコードはそのバイト列を処理するので、1文字を1バイトとみなす変換とは結果が異なります。逆変換で元の文章まで確かめられます。
コピー中に末尾が欠けたり、別形式の記号が混じったりすると、見た目だけでは判断できません。文字集合・パディング・未使用ビットを検証し、その後でUTF-8として成立するかを確認します。
標準は+と/、URLセーフBase64は-と_を使います。パディングは独立した設定です。デコード時に形式を自動判定しないため、入力側の約束に合わせて文字集合を選びます。
編集を止めてから350ミリ秒後に更新します。自動変換を切ると変換ボタンが表示され、Ctrl/Cmd+Enterでも実行できます。入力や設定を変えた直後は古い結果をコピーできません。
サンプル・クリア・逆変換は、置き換える内容と長さを先に表示します。適用後は一度元に戻せます。結果の表示は先頭20,000コード単位までですが、コピーと保存は全体を対象にします。
結合文字の並びを勝手に変えません。UTF-8を介して日本語や絵文字を変換し、先頭のU+FEFFもデータとして保持します。エンコード時に新しいBOMは追加しません。
Base64URLでは-と_を使い、標準の+と/は拒否します。標準モードでは逆の記号がエラーになります。両形式とも、エンコード時のパディングを独立して選べます。
不正な文字、パディング、単独サロゲートには行番号とUTF-16単位の列を付けます。デコード後のUTF-8エラーには、根拠のない入力位置を表示しません。
Base64デコードで無視できるのはスペース、タブ、CR、LFだけです。取り除いた数を結果に表示します。無視を無効にすると、これらも不正文字として検出できます。
はい。有効なUnicodeテキストなら、ひらがな・漢字・絵文字をUTF-8のバイト列にしてからBase64エンコードできます。文字数ではなくバイト数を変換するため、日本語は同じ文字数の英語より結果が長くなることがあります。
最後の2種類の記号が異なり、標準の+と/が-と_になります。等号を省略するかは別の仕様です。このツールでは2つを独立して設定でき、デコードでは選択した文字集合だけを受け付けます。
エンコード時に末尾の=を付けない設定を選べます。デコードは必要な=がすべてある場合か、すべて省略された場合に対応します。受信側が=を必須としているなら、送信時は残してください。
このページはテキスト専用です。画像やPDFを入力したり、Base64からバイナリファイルを復元したりはできません。文字として貼り付ける方法では元のファイルのバイト列を保証できないため、ファイル専用ツールを使ってください。
Base64は暗号化ではなく、誰でも逆変換できます。変換しただけでは秘密の保持や改ざん検出はできません。値をどこへ渡すかに応じて、別途暗号化や署名など必要な仕組みを選んでください。
説明のない変換エラーがありましたか?