Codificación y escape

Codificador Base64y decodificación UTF-8 estricta

Convierte un valor de texto con un alfabeto y un criterio de relleno explícitos.

Codificador Base64

Entrada

Resultado

La conversión se realiza en este navegador; la entrada no se sube.

Opciones de codificación

Solo UTF-8. Se admite relleno completo o ausente y se rechazan bits de relleno no nulos. El alfabeto elegido se valida estrictamente; los bytes UTF-8 inválidos producen un error.

Entrada: 1 000 000 de unidades UTF-16; salida: 4 000 000. La entrada vacía es válida. Al pegar pueden normalizarse los finales de línea.

Introduce texto o carga un ejemplo. Una entrada vacía genera una salida vacía.

Tras confirmar, el resultado actualizado reemplaza la entrada y cambia la dirección. No está disponible si el resultado supera el límite de entrada.

Pasar Base64 a texto requiere algo más que reconocer letras y números: los bytes resultantes también deben tener sentido en el juego de caracteres elegido. Este Codificador Base64 utiliza UTF-8 en ambas direcciones y rechaza secuencias dañadas sin sustituirlas por símbolos de reemplazo.

Para enviar una cadena a una API, comprueba primero qué alfabeto espera. Puedes codificar Base64 con + y / o con - y _, y decidir aparte si conservas los signos =. La pantalla comienza vacía para que pruebes tu propio valor o cargues el ejemplo.

Qué comprueba este Codificador Base64

Conservar el texto al hacer el recorrido inverso

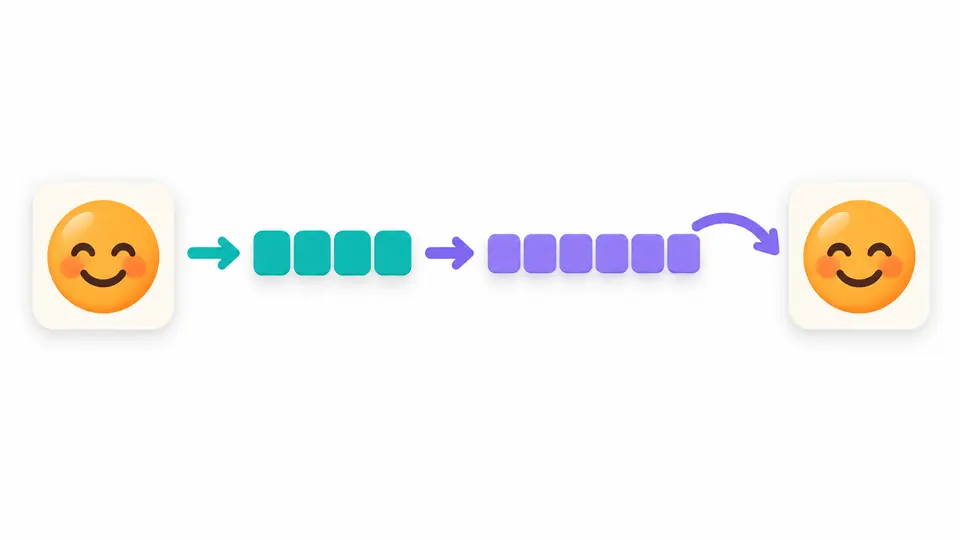
El Codificador Base64 convierte primero los caracteres en bytes UTF-8, incluidos los emoji y las secuencias combinadas. Usa el resultado como entrada en la dirección contraria para revisar lo que vas a transmitir. Un carácter no falla por necesitar varios bytes.

Un emoji pasa a bloques de bytes y a una secuencia codificada; al volver se recupera el mismo emoji.

No confundir una cadena válida con texto válido

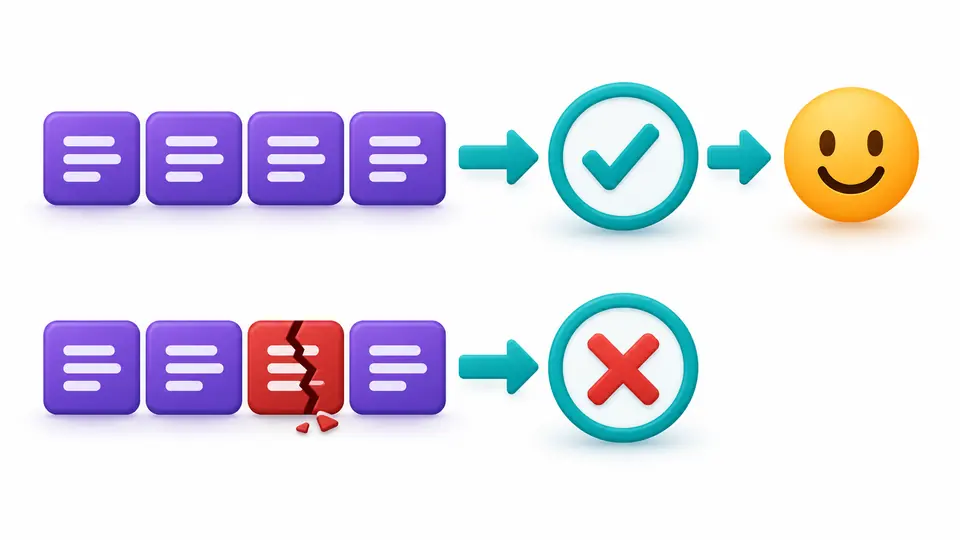
Una cadena puede usar símbolos Base64 correctos y aun así contener bytes que UTF-8 no admite. El decodificador detiene ese caso sin insertar caracteres de reemplazo. Los errores de alfabeto, relleno y bits finales se comprueban antes y se distinguen del error de texto.

Una secuencia válida atraviesa el control y otra dañada se detiene ante un indicador rojo.

Ajusta el formato que necesita el destino

01

Separa alfabeto y relleno

La variante estándar usa + y /; Base64URL usa - y _. Mantener = es una opción independiente al codificar. Al decodificar debes elegir el alfabeto: no se detecta ni se permite mezclarlo. Se admite el relleno exacto o su ausencia total.

02

Controla el momento de convertir

El modo automático espera 350 ms tras cada edición. Desactívalo para usar Convertir o Ctrl/Cmd+Intro. Cambiar dirección u opciones conserva la entrada y deja el resultado desactualizado; no abre una vista previa ni permite exportarlo hasta recalcular.

03

Revisa antes de sustituir el contenido

Ejemplo, Vaciar e Invertir muestran una vista previa antes de Aplicar. Deshacer recupera una instantánea de entrada, opciones y resultado. Solo se muestran 20 000 unidades UTF-16 de los valores largos; las exportaciones conservan el contenido completo.

Opciones con efectos concretos

Texto Unicode sin normalización

Los acentos, caracteres combinados y emoji pasan por UTF-8. Un U+FEFF inicial se conserva como parte del valor y no se añade un BOM nuevo al codificar. No se normalizan las secuencias Unicode.

Dos alfabetos definidos por RFC 4648

Base64URL cambia los dos símbolos de puntuación sin fijar la decisión sobre el relleno. El decodificador estándar rechaza - y _; el decodificador URL-safe rechaza + y /. Una selección equivocada genera un error.

Ubicación de los errores de entrada

Los caracteres prohibidos, el relleno incorrecto y los sustitutos aislados indican línea y columna UTF-16 del original. Los bytes UTF-8 inválidos no reciben una posición inventada: la etapa de decodificación de bytes no expone ese dato.

Tolerancia limitada a cuatro espacios

El decodificador Base64 puede ignorar espacio normal, tabulación, retorno de carro y salto de línea. Si desactivas la opción, también se rechazan. El estado cuenta las unidades retiradas; no se borran otros caracteres para conseguir una conversión.

Límites del texto y la validación

Un valor UTF-8, sin archivos
Este Codificador Base64 convierte texto y su representación inversa. No importa archivos, imágenes, URL ni Data URI, ni descarga binarios. Tampoco detecta juegos de caracteres ni ofrece Latin-1. Los encabezados y envoltorios deben retirarse explícitamente.
Relleno completo o totalmente omitido
Zg== y Zg producen f. Zg= falla, igual que un signo = intermedio, demasiados signos = o una longitud de datos con resto 1 al dividir entre 4. La opción de relleno cambia la codificación; la decodificación sigue siempre este criterio.
Bits finales canónicos
Zh== se rechaza aunque un decodificador permisivo pueda devolver f. Esta herramienta exige que los bits no utilizados sean cero. RFC 4648 permite que los decodificadores apliquen este criterio; no exige que todos rechacen estas variantes.
Los bytes dañados no se reparan
/w== es Base64 válido pero no representa texto UTF-8 válido, por lo que falla. Los sustitutos UTF-16 aislados tampoco se codifican. Se conservan los BOM iniciales decodificados, incluso repetidos; no hay normalización ni salida parcial.
Los espacios del texto son contenido
En Base64 solo pueden ignorarse SP, TAB, CR y LF. NBSP, salto de página, tabulación vertical y un BOM pegado se rechazan. Al codificar, los espacios y finales de línea forman parte del valor. El motor conserva CRLF, aunque pegar en el editor puede normalizar los finales de línea.
Tamaño limitado, exportación completa
La entrada admite 1 000 000 de unidades UTF-16 antes de quitar espacios; la salida, 4 000 000. Un exceso falla entero y no se exporta truncado. El valor vacío es válido. No hay formato MIME, lotes por línea, cifrado, verificación JWT ni almacenamiento de borradores.

Preguntas sobre el Codificador Base64

¿Por qué los caracteres de otros idiomas fallan en algunos conversores?

Suele ocurrir cuando se confunden caracteres con bytes o se usa un juego de caracteres limitado. El Codificador Base64 transforma el texto en UTF-8 antes de codificarlo, de modo que admite acentos, otros alfabetos y emoji. Los sustitutos UTF-16 aislados se rechazan en vez de alterarlos.

¿En qué cambia el alfabeto seguro para URL?

Base64URL sustituye + por - y / por _. Los demás símbolos de datos son los mismos. La presencia de = depende del protocolo destinatario; aquí el alfabeto y el relleno se eligen por separado. No se realiza escape porcentual de URL.

¿Se admiten cadenas sin relleno y con saltos de línea?

Sí, el relleno puede faltar por completo, pero no estar a medias: Zg funciona y Zg= falla. Con la opción de espacios activada se ignoran espacio, tabulación, CR y LF. No se ignoran espacios inseparables ni otros caracteres.

¿Puedo codificar archivos binarios?

Esta página trabaja con texto UTF-8 y no acepta archivos. Para imágenes, PDF u otros binarios necesitas una herramienta que procese sus bytes directamente. Una cadena Base64 de un binario puede superar la validación estructural y fallar al intentar convertir sus bytes a UTF-8.

¿Cómo decodifico una cadena Base64 online?

Selecciona Decodificar Base64, pega la cadena sin encabezados y elige su alfabeto. El modo automático calcula el resultado; si lo desactivas, usa Convertir. Corrige cualquier error antes de copiar o descargar. El procesamiento se realiza en el navegador.

¿Encontraste un caso de codificación especial?

Volver al Codificador Base64

Prueba el Codificador Base64 con un texto breve, confirma el alfabeto y el relleno, e invierte el resultado para comprobar el texto UTF-8 antes de usarlo.