Codificação e escape

Codificador Base64com decodificação UTF-8 estrita

Converta um valor de texto com alfabeto e preenchimento escolhidos de forma explícita.

Codificador Base64

Entrada

Resultado

A conversão acontece neste navegador; a entrada não é enviada.

Opções de codificação

Somente UTF-8. A decodificação aceita preenchimento completo ou ausente e rejeita bits não usados diferentes de zero. O alfabeto escolhido é validado estritamente; bytes UTF-8 inválidos geram erro.

Entrada: 1 000 000 de unidades UTF-16; saída: 4 000 000. Entrada vazia é válida. Colar pode normalizar finais de linha.

Digite texto ou carregue um exemplo. Entrada vazia produz saída vazia.

Após a confirmação, o resultado atualizado substitui a entrada e a direção se inverte. Indisponível quando o resultado ultrapassa o limite de entrada.

Um resultado com letras e números pode esconder bytes que não são texto. Este Codificador Base64 verifica a estrutura da entrada e exige UTF-8 válido na volta, sem trocar sequências inválidas por caracteres de substituição.

Para codificar e decodificar uma configuração de API, confira o alfabeto esperado e a convenção de preenchimento. São escolhas separadas: selecionar Base64URL não remove os sinais = automaticamente. A página abre vazia, com um exemplo disponível para carregar.

Por que usar este Codificador Base64?

Conferir a ida e a volta do Unicode

O Codificador Base64 transforma o texto em bytes UTF-8 antes de representá-los com símbolos ASCII. Acentos e emoji seguem esse mesmo processo. Inverta o resultado atual para reler a mensagem representada antes de levá-la para outro sistema.

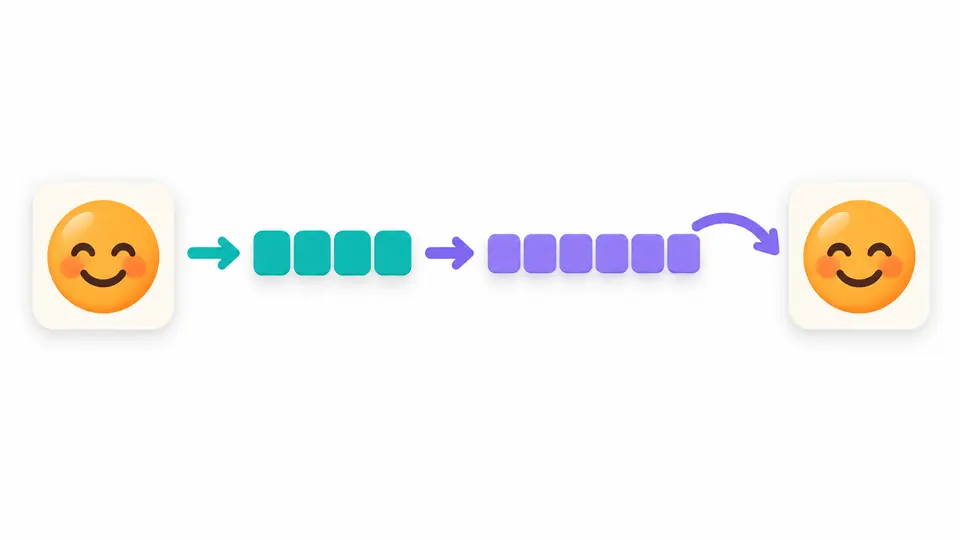
Um emoji passa por blocos de bytes e uma sequência codificada, voltando depois ao mesmo emoji.

Entender onde a conversão falhou

Alfabeto correto não garante texto legível: /w== é Base64 válido, mas seus bytes não são UTF-8 válido. O resultado é um erro, sem caracteres de substituição. Problemas no preenchimento e nos bits finais são detectados separadamente para não esconder a causa.

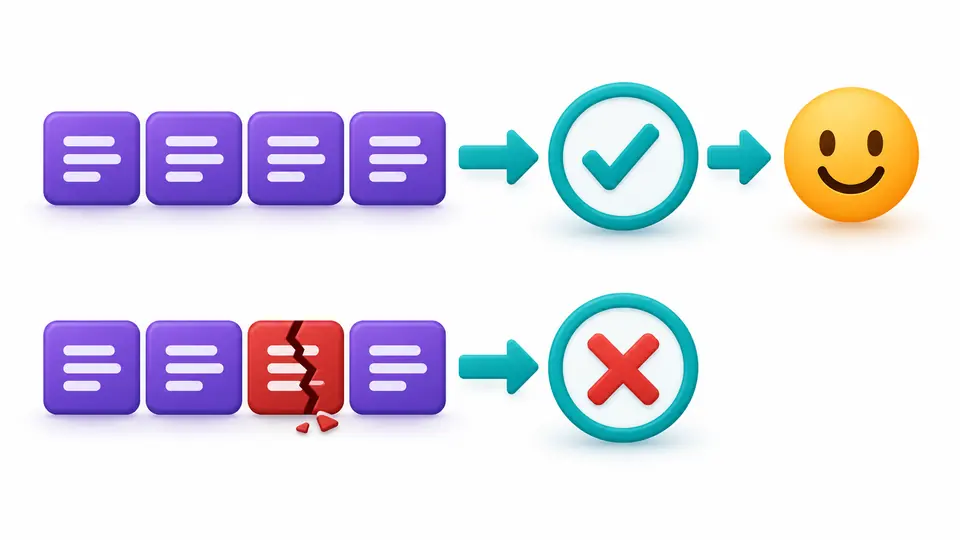
Uma sequência válida passa pela verificação enquanto outra danificada para em um marcador vermelho.

Confira as convenções do destino

01

Escolha o alfabeto e depois o preenchimento

O padrão usa + e /; Base64URL usa - e _. Manter = é uma opção independente ao codificar. Para decodificar, selecione o alfabeto explicitamente. O preenchimento pode estar exato ou totalmente ausente, mas nunca pela metade.

02

Saiba quando o resultado está atualizado

A conversão automática aguarda 350 ms após a edição. Desative-a para usar Converter ou Ctrl/Cmd+Enter. Alterar direção ou opções não substitui a entrada nem exige prévia; apenas deixa o resultado desatualizado e bloqueia a exportação até recalcular.

03

Revise antes de sobrescrever

Exemplo, Limpar e Inverter abrem uma prévia com os tamanhos em UTF-16. Aplicar faz a troca; Desfazer restaura uma versão de entrada, opções e resultado. Valores longos aparecem até 20 000 unidades, mas cópia e download incluem o resultado completo.

Comportamentos que você pode conferir

UTF-8 sem normalização Unicode

Acentos, sequências combinadas e emoji são convertidos em bytes UTF-8. Um U+FEFF inicial continua fazendo parte do valor. A codificação não acrescenta um BOM nem normaliza a composição dos caracteres.

Alfabetos RFC 4648 separados

Base64URL muda dois sinais de pontuação e não determina o preenchimento. O decodificador padrão rejeita - e _; a variante URL-safe rejeita + e /. Misturar os alfabetos gera erro em vez de uma correção automática.

Localização quando ela existe

Caracteres proibidos, preenchimento incorreto e substitutos isolados indicam linha e coluna UTF-16 na entrada original. Para UTF-8 decodificado inválido, não é inventada uma posição: essa etapa não fornece a localização do byte problemático.

Quatro espaços opcionais

O decodificador Base64 pode ignorar somente espaço comum, tabulação, retorno de carro e quebra de linha. Desative a opção para rejeitá-los também. O status informa quantas unidades foram removidas; outros caracteres não são descartados silenciosamente.

Escopo e critérios de validação

Texto, sem importação de arquivos
Este Codificador Base64 trabalha com um valor de texto UTF-8. Não importa arquivo, imagem, URL ou Data URI, nem oferece download binário. Não detecta charset e não tem modo Latin-1. Cabeçalhos e outros invólucros precisam ser removidos por você.
Preenchimento inteiro ou nenhum
Zg== e Zg produzem f. Zg= falha, assim como um = no meio, sinais = em excesso ou tamanho de dados com resto 1 na divisão por 4. A opção de preenchimento afeta a codificação; a decodificação sempre usa esse critério.
Bits finais em forma canônica
Zh== é rejeitado mesmo que um decodificador permissivo devolva f. A ferramenta exige bits não usados iguais a zero. A RFC 4648 permite que decodificadores adotem essa política; não obriga todos a rejeitar esses valores.
Bytes inválidos não são corrigidos
/w== passa pela estrutura Base64, mas falha como texto UTF-8. Substitutos UTF-16 isolados também falham na codificação. BOMs iniciais decodificados são preservados, inclusive repetidos, sem normalização nem retorno de texto parcial.
Espaço no texto é conteúdo
Somente SP, TAB, CR e LF podem ser ignorados na entrada codificada. NBSP, avanço de página, tabulação vertical e BOM colado são rejeitados. Ao codificar texto, espaços e finais de linha são conteúdo. O motor preserva CRLF, mas a colagem no editor pode normalizar finais de linha.
Limites sem exportação cortada
A entrada admite 1 000 000 de unidades UTF-16 antes da remoção de espaços; a saída, 4 000 000. Valores maiores falham por inteiro. Texto vazio é válido. Não há formatação MIME, lotes por linha, criptografia, verificação JWT ou armazenamento de rascunhos.

Dúvidas sobre o Codificador Base64

A codificação lida com caracteres não ASCII?

Sim. O Codificador Base64 converte o texto em UTF-8 antes de codificá-lo, incluindo acentos, outros alfabetos e emoji. Não trata cada caractere como um único byte. Um substituto UTF-16 isolado é rejeitado para evitar que seja trocado silenciosamente por outro caractere.

Qual a diferença entre b64encode e urlsafe_b64encode?

Na biblioteca base64 do Python, b64encode usa o alfabeto padrão; urlsafe_b64encode troca + e / por - e _. Essa escolha, por si só, não significa remover =. Aqui você faz as mesmas escolhas de alfabeto e controla o preenchimento separadamente.

Por que aparece “Incorrect padding”?

Em geral, o valor não atende ao preenchimento esperado pelo decodificador usado. Aqui, Zg== e Zg são aceitos, mas Zg= não: mantenha o preenchimento correto ou remova-o inteiro. Um = no meio, excesso de = ou comprimento impossível também provoca erro; não acrescente sinais sem verificar a origem da cadeia.

Posso codificar arquivos binários?

Esta página recebe texto UTF-8, sem importação de arquivos. PDF e imagens exigem um conversor que processe bytes de arquivo diretamente. Colar o Base64 de um binário pode resultar em erro de UTF-8, mesmo que a cadeia Base64 esteja correta.

Base64 é a mesma coisa que criptografia?

Não. Qualquer pessoa pode reverter Base64 sem uma chave secreta. A codificação não protege a confidencialidade nem comprova que o conteúdo não foi alterado. Use o mecanismo de segurança adequado ao protocolo quando essas garantias forem necessárias.

Encontrou um caso de codificação inesperado?

Voltar ao Codificador Base64

Use o Codificador Base64 com uma amostra curta, confira o alfabeto e o preenchimento e inverta o resultado para revisar o texto UTF-8 antes de usá-lo.