01
Alphabet und Padding getrennt festlegen
Standard verwendet + und /, die URL-sichere Variante dagegen - und _. Ob = am Ende stehen soll, bestimmen Sie unabhängig davon. Der Decoder errät das Alphabet nicht und akzeptiert nur das ausgewählte.
Kodierung und Maskierung
Ein Textwert, ein gewähltes Alphabet und eine ausdrückliche Padding-Regel.
Die Umwandlung bleibt in diesem Browser; die Eingabe wird nicht hochgeladen.
Nur UTF-8. Beim Dekodieren muss Padding vollständig sein oder ganz fehlen. Ungenutzte Bits ungleich null werden abgelehnt. Das gewählte Alphabet und die UTF-8-Bytes werden streng geprüft.
Eingabe: 1.000.000 UTF-16-Codeeinheiten; Ausgabe: 4.000.000. Leere Eingaben sind gültig. Einfügen kann Zeilenenden vereinheitlichen.
Text eingeben oder ein Beispiel laden. Leere Eingabe ergibt leere Ausgabe.
Nach Bestätigung wird das aktuelle Ergebnis zur Eingabe und die Richtung wechselt. Bei Überschreitung des Eingabelimits ist das nicht möglich.
Sie möchten einen Konfigurationswert mit Umlauten in Base64 kodieren? Entscheidend sind seine UTF-8-Bytes, nicht die Anzahl der sichtbaren Zeichen. Ein ä belegt mehr als ein Byte; auch Eurozeichen und Emojis lassen sich auf diesem Weg darstellen.
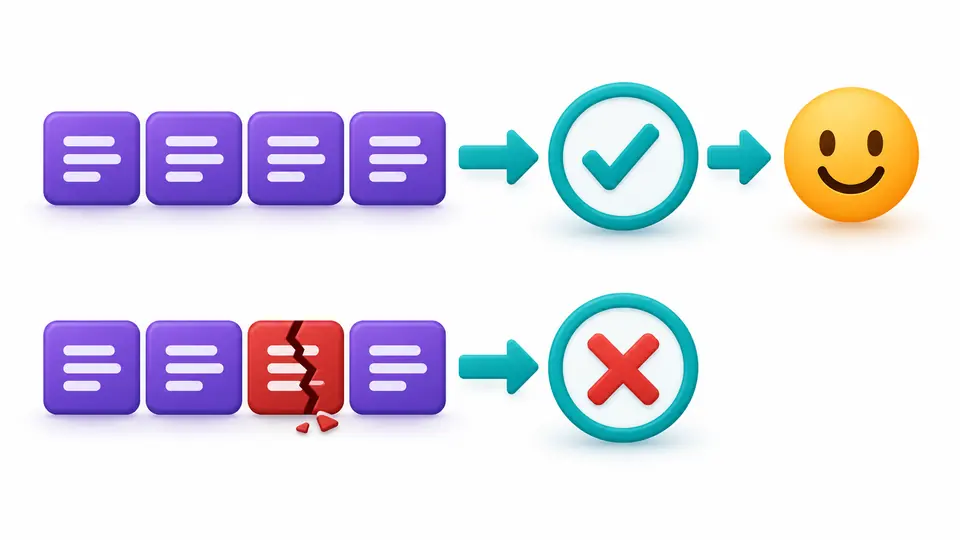
Beim Prüfen einer empfangenen Zeichenfolge reicht es nicht, dass irgendein lesbarer Text erscheint. Der Decoder prüft zuerst Alphabet, Padding und ungenutzte Bits. Danach müssen die Bytes gültiges UTF-8 ergeben. Beschädigte Daten werden nicht durch Ersatzzeichen kaschiert.
Wer Grüße in Base64 kodieren möchte, muss zuerst die UTF-8-Darstellung verwenden. Das Werkzeug übernimmt diesen Schritt auch für Emojis. Sie können das frische Ergebnis anschließend zurückwandeln und den Text prüfen, bevor er in einer Konfiguration landet.
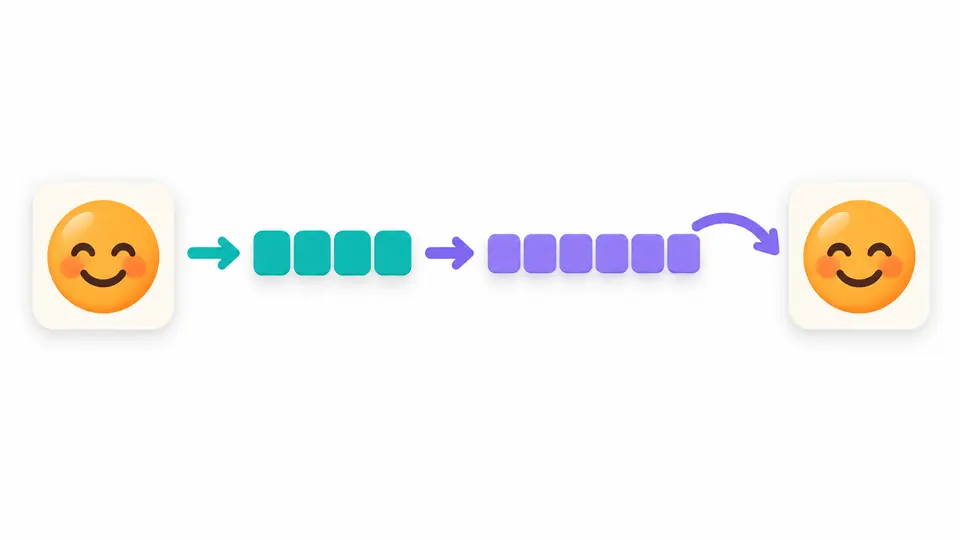
Ein korrektes Alphabet garantiert noch keine gültigen UTF-8-Bytes. Der Decoder unterscheidet Fehler am kodierten Wert von Fehlern bei der Textinterpretation. So liefert er keine scheinbar brauchbare Ausgabe, deren Inhalt bereits durch Ersatzzeichen verändert wurde.
Standard verwendet + und /, die URL-sichere Variante dagegen - und _. Ob = am Ende stehen soll, bestimmen Sie unabhängig davon. Der Decoder errät das Alphabet nicht und akzeptiert nur das ausgewählte.
Automatisch wird 350 ms nach der letzten Änderung umgewandelt. Bei ausgeschalteter Automatik erscheint die Schaltfläche; Ctrl/Cmd+Enter funktioniert ebenfalls. Änderungen an Text, Richtung oder Optionen sperren den Export des alten Ergebnisses sofort.
Beispiel, Leeren und Zurückwandeln zeigen vorab den neuen Inhalt und seine Länge. Erst Übernehmen ersetzt die Eingabe. Rückgängig stellt einen Zustand wieder her. Die Ausgabevorschau endet bei 20.000 Codeeinheiten; Kopie und Download bleiben vollständig.
Akzente, kombinierende Zeichen und Emojis werden über ihre Bytes verarbeitet. Zeichenfolgen werden nicht normalisiert. Ein vorhandenes U+FEFF bleibt Teil des Textes; beim Kodieren wird kein zusätzlicher BOM eingefügt.
Der Base64URL-Modus akzeptiert beim Dekodieren - und _, aber keine + oder /. Im Standardmodus gilt das Umgekehrte. Beide erlauben eine unabhängige Padding-Einstellung für die Kodierung.
Falsche Zeichen, fehlerhaftes Padding und einzelne Surrogate erhalten eine Zeile und eine UTF-16-Spalte in der ursprünglichen Eingabe. Für ungültige UTF-8-Bytes wird keine nicht ermittelbare Textposition erfunden.
Der Base64 Decoder kann ausschließlich Leerzeichen, Tabulator, CR und LF ignorieren. Das Ergebnis nennt die entfernte Anzahl. Schalten Sie die Option aus, um zu prüfen, ob ein Wert tatsächlich ohne solche Unterbrechungen vorliegt.
Sie behandeln JavaScript-Zeichen oft direkt als einzelne Bytes. Für UTF-8 müssen Umlaute und viele weitere Zeichen zunächst in mehrere Bytes umgewandelt werden. Wenn Sie hier Text in Base64 kodieren, übernimmt das Werkzeug diesen Schritt; auch Emojis sind möglich.
Wenn das empfangende Format Base64URL verlangt, etwa für einen Wert innerhalb eines Webprotokolls. Es verwendet - und _ anstelle von + und /. Ob Padding entfallen soll, folgt aus der jeweiligen Spezifikation und wird hier separat eingestellt.
Sie vervollständigen die letzte Vierergruppe, wenn die Bytezahl nicht durch drei teilbar ist. Manche Protokolle lassen sie weg. Dieses Werkzeug dekodiert exakt gepaddete sowie vollständig ungepaddete Werte; nur teilweise vorhandenes Padding wird abgelehnt.
Nein. Jeder kann den Wert ohne Schlüssel zurückwandeln. Die Kodierung bietet weder Vertraulichkeit noch Schutz vor unbemerkten Änderungen. Dafür brauchen Sie das Verschlüsselungs- oder Signaturverfahren, das zu Ihrem Anwendungsfall gehört.
Drei Bytes werden zu vier Zeichen, zuzüglich gegebenenfalls notwendigem Padding. Der Vergleich bezieht sich auf Bytes: Umlaute können in UTF-8 mehrere Bytes belegen. Die sichtbare Zeichenanzahl des Originals ist deshalb keine verlässliche Grundlage für die Größe der Ausgabe.
Fehlt eine Erklärung zu Ihrem Kodierungsfehler?
Zuerst einen kurzen Wert in Base64 kodieren, Alphabet und Padding mit den Vorgaben abgleichen und dann durch Zurückwandeln den UTF-8-Text kontrollieren.