ZEICHEN UND IHRE BYTES

Text in Binär

Text und Bytes in beide Richtungen umwandeln. Die Zeichenkodierung bleibt ausdrücklich wählbar; das Beispiel enthält vier Codepoints und zehn Bytes.

Text in Binär

Text oder Bytes eingeben

Ergebnis

Die Umwandlung erfolgt im Browser. Eingaben werden weder hochgeladen noch als Verlauf gespeichert.

Optionen für die Bytes

Pro Byte: 8 Binärziffern oder 2 Hex-Ziffern. Ganze Bytefolgen dürfen ohne Trennung oder mit Leerzeichen, Tabulatoren, Zeilenumbrüchen und Kommas stehen.

Die gewählte Kodierung gilt unverändert. U+FEFF bleibt erhalten; eine BOM wird weder ergänzt noch entfernt oder zur Erkennung der Bytefolge verwendet.

Text: 65.536 UTF-16-Einheiten. Byteeingabe: 2.097.152 Zeichen. Daten: 196.608 Bytes. Ausgabe: 2.097.152 Zeichen.

10 Bytes · 4 Unicode-Codepoints · 5 UTF-16-Einheiten

TXT speichert die sichtbare Darstellung als UTF-8. BIN speichert die tatsächlich kodierten oder eingelesenen Bytes.

Wer Text in Binär umwandeln möchte, muss zuerst wissen, welche Zeichenkodierung die Bytes erzeugt. Ein Umlaut ist in UTF-8 länger als ein ASCII-Buchstabe. Hier lassen sich die Bytes aus einem Protokoll mit dem erwarteten Text vergleichen. Eine fehlerfreie Dekodierung beweist allerdings noch nicht, dass die gewählte Kodierung zur Quelle passt.

Text in Binär mit nachvollziehbaren Bytes

Umlaute und Emoji vollständig abbilden

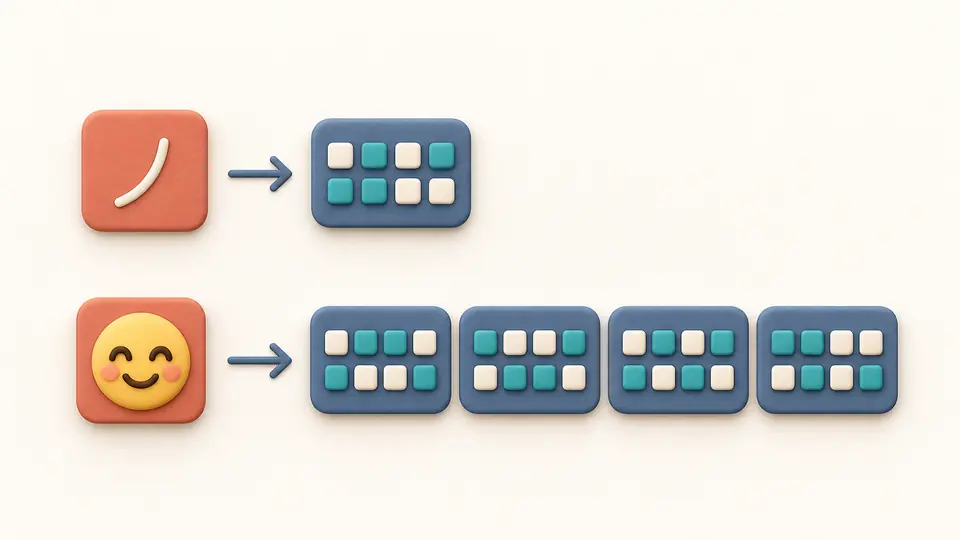
Text in Binär umzuwandeln bedeutet hier, zuerst Unicode zu kodieren. A benötigt in UTF-8 ein Byte, é zwei, 中 drei und 😀 vier. Bei UTF-16 LE und BE ändern die beiden Bytes jeder 16-Bit-Einheit ihre Reihenfolge. Ein Emoji außerhalb der Basisebene benötigt weiterhin ein Surrogatpaar.

Ein einfaches Symbol wird einem Bytefeld zugeordnet, ein komplexes Symbol mehreren gleich großen Bytefeldern.

Beschädigte Daten bleiben erkennbar

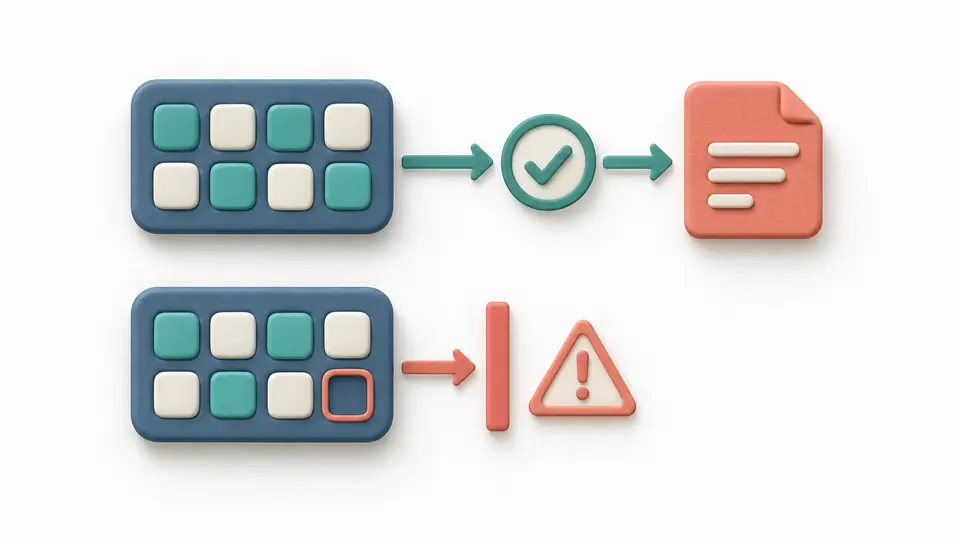
Sieben Bits werden nicht stillschweigend mit einer Null ergänzt. Ungültige UTF-Sequenzen stoppen die ganze Umwandlung. Die Eingabe bleibt sichtbar, und Zeile sowie Spalte führen zur Fehlerstelle. Dadurch entsteht kein scheinbar fertiger Text, in dem problematische Zeichen fehlen.

Vollständige Bytegruppen passieren eine Prüfung; eine unvollständige Gruppe wird angehalten und hervorgehoben.

Kodierung, Aktualisierung und Export abstimmen

01

Die Quelle bestimmt die Kodierung

Für Binärcode in Text zuerst Binär als Byteformat wählen, für einen Hex-Dump Hex. UTF-16 benötigt eine eindeutige LE- oder BE-Auswahl. Ein Richtungswechsel verschiebt keine Daten. Ergebnis umkehren zeigt zuerst die Vorschau des Inhalts, der die Eingabe ersetzen würde.

02

Automatische Aktualisierung bei Bedarf stoppen

Die Umwandlung startet 350 ms nach der letzten Änderung. Ohne Automatik stehen Umwandeln und Strg/Cmd + Enter bereit. Jede Eingabe- oder Optionsänderung sperrt alte Exporte sofort. Trennzeichen und Großbuchstaben betreffen ausschließlich die Ausgabe von Text zu Bytes.

03

Darstellung oder Rohbytes speichern

TXT enthält die angezeigte Darstellung in UTF-8, BIN die echten Bytes. Beispiel, Leeren und Umkehren zeigen vorher den Umfang der Ersetzung. Nach Übernehmen lässt sich einmal der vorherige Zustand mit Eingabe, Optionen und Ergebnis wiederherstellen.

Was beim Darstellungswechsel erhalten bleibt

Unicode ohne Normalisierung

Kombinierende Akzente bleiben in ihrer eingegebenen Form. Die Anwendung führt keine NFC-Normalisierung aus und überspringt weder Umlaute noch Emoji. Codepoints sind keine sichtbaren Schriftzeichen: Ein einzelnes zusammengesetztes Emoji kann aus mehreren Codepoints bestehen.

Feste Breite und führende Nullen

Jedes Byte hat acht Binärziffern oder zwei Hex-Ziffern. Leerzeichen, keine Trennung, Zeilenumbruch und Komma verändern nur die Darstellung. Beim Einlesen gelten beide Hex-Schreibweisen sowie ASCII-Leerzeichen, Tabulator, CR, LF und Komma zwischen vollständigen Bytes.

Strenge Prüfung mit Originalposition

Falsche Ziffern, halbe Bytes, ungültige UTF-8-Fortsetzungsbytes und defekte UTF-16-Surrogatpaare werden abgewiesen. Die Byteposition wird auf die ursprüngliche Eingabe zurückgeführt. Ein tatsächlich kodiertes U+FFFD bleibt erhalten; als Fehlerersatz wird es nicht erzeugt.

Schrittweise Vorschau, vollständiger Export

Die Vorschau beginnt mit 100 Bytes beim Kodieren oder 100 Codepoints beim Dekodieren. Weitere 100 lassen sich jeweils einblenden, ohne Bytes oder Surrogatpaare zu teilen. Kopieren und beide Downloads enthalten immer das gesamte aktuelle Ergebnis.

Grenzen und Eingabeformat

Nur ganze Bytes
0100 0001 wird nicht zu einem Byte zusammengefügt. Präfixe wie 0x und 0b, Backslash-Escapes, Klammern, Adressen und Textspalten eines Dumps müssen vorher entfernt werden. Unbekannte Zeichen werden nicht automatisch herausgefiltert.
Drei Kodierungen zur Auswahl
Unterstützt sind UTF-8, UTF-16LE und UTF-16BE. Es gibt keine automatische Erkennung, unspezifisches UTF-16, ASCII-Sondermodus, GBK, Shift_JIS oder EUC-KR. Eine falsche Kodierung kann trotzdem gültigen, aber unpassenden Text erzeugen.
Inhalte unverändert lassen
Leerraum im Text, NUL, Zeilenenden, kombinierende Zeichen und U+FEFF bleiben erhalten. Eine BOM wird weder entfernt noch eingefügt; sie überschreibt auch nicht die gewählte Bytereihenfolge. Bereits vor dem Einfügen durch das Betriebssystem veränderte Zeilenenden lassen sich nicht rekonstruieren.
Begrenzte Datenmenge
Text und dekodiertes Ergebnis dürfen höchstens 65.536 UTF-16-Einheiten umfassen. Bytenotation: 2.097.152 Zeichen und 196.608 Bytes; Ausgabe: 2.097.152 Zeichen. Bei Überschreitung folgt ein Fehler statt einer Kürzung. Dateiimport, URL-Abruf und Stapelverarbeitung sind nicht enthalten.
TXT ist immer UTF-8
Auch bei gewähltem UTF-16 speichert TXT die sichtbare Ausgabe in UTF-8. Für die tatsächlichen UTF-16-Bytes BIN verwenden. Das Werkzeug analysiert keine Bilder, Archive oder Programme und überschreibt keine Quelldateien.
Keine Zahlenrechnung oder Verschlüsselung
42 wird als Zeichenfolge aus 4 und 2 kodiert. Die Umrechnung der ganzen Zahl 42, Zweierkomplement, Gleitkomma, Dezimal- und Oktalausgabe, Base64 sowie Codepoint-Escapes sind andere Aufgaben. Binär- und Hex-Schreibweise bieten keinen Geheimnisschutz.

Fragen zu Text in Binär

Welche Kodierung wird verwendet?

Standardmäßig UTF-8. Alternativ können Sie UTF-16 LE oder UTF-16 BE ausdrücklich auswählen. Es gibt keine automatische Erkennung anhand einer BOM. Die Einstellung bestimmt die tatsächlichen Bytes und muss beim Rückweg zur ursprünglichen Kodierung passen.

Werden Umlaute korrekt umgewandelt?

Ja. ä wird in UTF-8 als C3 A4 kodiert, ö als C3 B6 und ü als C3 BC. Auch kombinierende Zeichen bleiben erhalten. Ihre Darstellung wird nicht automatisch vereinheitlicht, sodass optisch ähnliche Texte unterschiedliche Bytefolgen haben können.

Wie kann ich Binärcode wieder zurückwandeln?

Bytes → Text und das passende Byteformat wählen. Anschließend die ursprüngliche Zeichenkodierung einstellen. Um den gerade erzeugten Code zurückzuführen, Ergebnis umkehren verwenden und die Vorschau übernehmen. Ein bloßer Richtungswechsel ersetzt die Eingabe nicht.

Wie müssen die Bits eingegeben werden?

Eine Gruppe muss aus einem Vielfachen von acht Bits bestehen. Vollständige Bytes können direkt aneinanderstehen oder durch unterstützten Leerraum beziehungsweise Kommas getrennt werden. 0100000101000010 ist zulässig; 0100 0001 ist es nicht.

Was passiert bei ungültigen Eingaben?

Die gesamte Umwandlung wird abgebrochen. Zeile und Spalte zeigen die problematische Stelle; bei ungültiger Kodierung kommt die Bytenummer hinzu. Die Eingabe bleibt erhalten und alte Ergebnisse können nicht exportiert werden. Fehlende Bits oder unlesbare Zeichen werden nicht still repariert.

Noch eine Frage?

Eine Bytefolge untersuchen

Text in Binär umwandeln und dieselbe Zeichenfolge anschließend mit beiden UTF-16-Bytefolgen vergleichen: Prüfen Sie die Byteanzahl und wählen Sie den passenden Export für den nächsten Schritt.

Ein Byte hat acht Bits. Ein Zeichen kann mehrere Bytes benötigen.