01
按来源选择编码与方向
二进制转文本需要先选二进制格式;十六进制转字符串则先选 Hex。UTF-16 要明确选择小端 LE 或大端 BE。方向选择只修改解释方式;要把当前结果移入输入框,使用“反向使用结果”并核对预览。
查看文字背后的字节
在文本与二进制或十六进制字节之间转换,明确指定字符编码。示例包含 4 个 Unicode 码点、10 个字节。
转换在当前浏览器中完成,输入不会上传或保存为历史记录。
每个字节为 8 位二进制或 2 位 Hex;连续字节串可用空格、制表符、换行或逗号分组,分隔符只能出现在完整字节之间。
严格使用所选编码,保留 U+FEFF,不添加或移除 BOM,也不根据 BOM 猜测字节序。
文本上限为 65,536 个 UTF-16 单元;字节输入为 2,097,152 个字符;最多 196,608 个字节;结果最多 2,097,152 个字符。
10 字节 · 4 个 Unicode 码点 · 5 个 UTF-16 单元
TXT 以 UTF-8 保存结果文字;BIN 保存实际编码或解析得到的字节。
核对接口报文或十六进制日志时,看到的字符相同,不代表底层字节相同。文本转二进制把编码选择和字节结果放在一起,方便检查中文、重音字母和 emoji 如何存储。应先确认数据来源使用的编码;解码成功只能说明字节有效,不能证明还原出的文字就是原文。
文本转二进制先对完整 Unicode 文本编码,再展示每个字节。字母 A 占 1 个 UTF-8 字节,é 占 2 个,汉字“中”占 3 个,😀 占 4 个。切换到 UTF-16 LE 或 BE 后,可看到每个编码单元的两个字节如何交换次序。
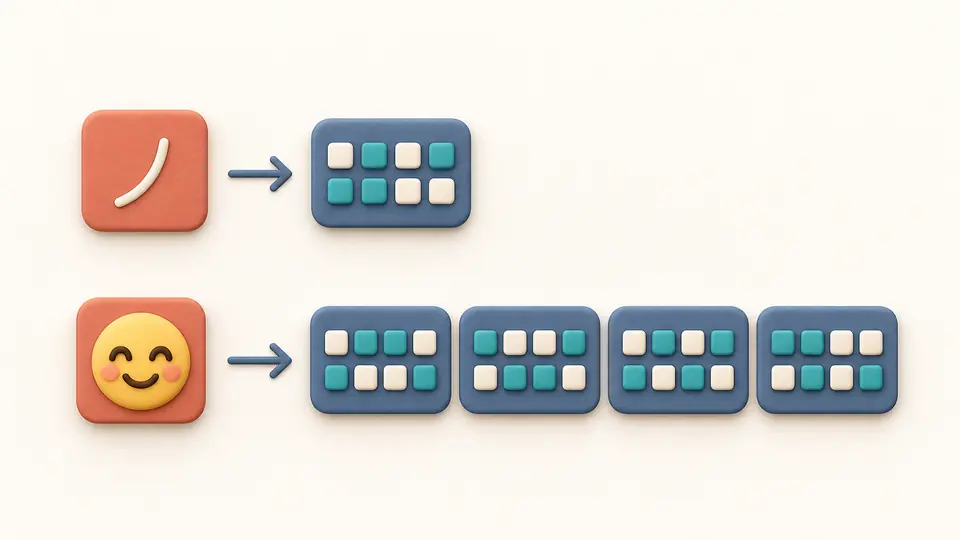
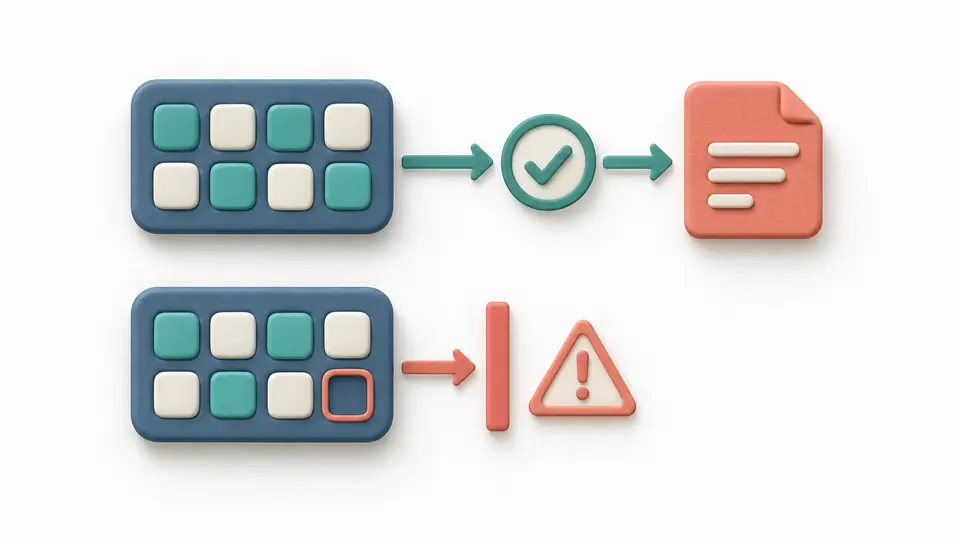
只有 7 位的二进制组不会自动补零,无效的 UTF 字节也不会被替换字符掩盖。转换会整体失败,原始输入保留,并指出字节所在的行列,避免复制出一份悄悄少了字符的结果。
二进制转文本需要先选二进制格式;十六进制转字符串则先选 Hex。UTF-16 要明确选择小端 LE 或大端 BE。方向选择只修改解释方式;要把当前结果移入输入框,使用“反向使用结果”并核对预览。
文本中的空格是内容,会变成字节;输出分隔符只是排版。自动转换会等待 350 毫秒,关闭后可点“转换”或按 Ctrl/Cmd + Enter。输入或参数改变后,旧结果立即过期,不能复制或下载。
核对字节数与码点数后再导出。TXT 保存显示的文字,BIN 保存真实字节。反向回填、加载示例和清空都会先显示替换数量;应用后可撤销一次,同时恢复输入、参数和原结果。
文本转十六进制不会把中文或 emoji 当作超出单字节范围的内容跳过。UTF-8 编码先处理整段文字,再把每个字节写成两位十六进制。组合重音按输入保留,不做 NFC 规范化;码点数也不等于肉眼看到的字形数量。
二进制始终为每字节 8 位,Hex 始终为每字节 2 位,零字节不会消失。空格、无分隔、换行和逗号只影响编码输出。解码同时接受十六进制大小写,不需要把输出分隔符选项调成输入的样子。
非法数字、半个字节、错误的 UTF-8 延续字节,以及未配对的 UTF-16 代理项都会报错。字节编号映射回粘贴内容的原始行列。若输入本来就包含合法编码的 U+FFFD,则会保留这个字符,不会误报为解码失败。
编码结果先展示 100 个字节,解码结果先展示 100 个 Unicode 码点,每次可再展开 100 项。预览边界不会截断字节或 emoji 的代理对。复制和两类下载都使用完整的有效结果,不受当前展开数量影响。
固定为八位的是字节,不是字符。ASCII 范围内的字符在 UTF-8 中通常占一个字节,中文与 emoji 会占多个字节;UTF-16 的一个编码单元是两个字节,补充平面字符需要两个编码单元。
它只控制文本编码后的字节如何排列,例如用空格或逗号隔开,或输出连续串。原文中的空格仍然编码为内容。解码时会识别完整字节之间支持的空白和逗号,输出分隔符选项不参与解码。
可以。选择“字节 → 文本”和二进制格式,再选择产生这些字节时使用的编码。无分隔的连续字节也能解析。用当前结果往返时,可通过“反向使用结果”预览后应用,原文和结果可一起撤销恢复。
如果输入是未配对的 UTF-16 代理项,或者字节在所选编码下无效,工具会拒绝转换。正常的中文和 emoji 都支持,不会因为超过 ASCII 范围就被跳过。请先检查字节是否完整,再核对来源编码。
每两位十六进制表示一个字节,一个字符可能需要多个字节。例如 UTF-8 中 é 是 C3 A9,😀 是 F0 9F 98 80。字符的 Unicode 码点编号与编码后的字节不是同一个值。
还有疑问?