DU CARACTÈRE À SES OCTETS

Texte en binaire

Convertissez le texte en octets ou retrouvez le texte avec un encodage explicite. L’exemple contient quatre points de code et dix octets.

Texte en binaire

Texte ou octets en entrée

Résultat

La conversion reste dans ce navigateur ; aucune entrée n’est envoyée ni conservée dans un historique.

Options de conversion

Un octet comporte 8 chiffres binaires ou 2 chiffres Hex. Les groupes complets peuvent être accolés ou séparés par espaces, tabulations, retours à la ligne et virgules.

L’encodage sélectionné s’applique tel quel. U+FEFF est conservé ; aucun BOM n’est ajouté, retiré ou utilisé pour deviner l’ordre des octets.

Texte : 65 536 unités UTF-16. Entrée en octets : 2 097 152 caractères. Données : 196 608 octets. Sortie : 2 097 152 caractères.

10 octets · 4 points de code Unicode · 5 unités UTF-16

TXT enregistre la représentation affichée en UTF-8. BIN enregistre les octets réellement encodés ou lus.

Texte en binaire permet de vérifier ce que contient réellement une trace réseau ou une donnée de test. Un caractère accentué ne correspond pas forcément à un seul octet. En comparant le texte aux octets UTF-8 ou UTF-16, vous pouvez contrôler le format attendu par le destinataire. Un décodage valide ne garantit toutefois pas que l’encodage choisi soit celui de la source.

Pourquoi utiliser Texte en binaire

Voir la taille réelle des caractères

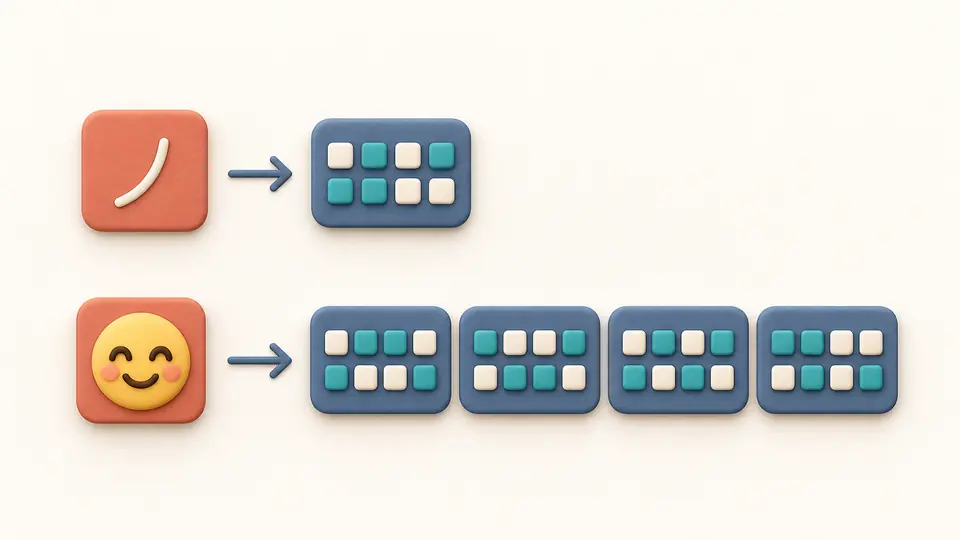
Texte en binaire encode la chaîne Unicode avant de représenter ses octets. En UTF-8, A occupe un octet, é deux, 中 trois et 😀 quatre. UTF-16 LE et BE inversent l’ordre des deux octets de chaque unité de 16 bits. Un emoji hors du plan de base nécessite deux unités.

Un symbole simple correspond à une case d’octet ; un symbole complexe se déploie sur plusieurs cases identiques.

Repérer une séquence incomplète

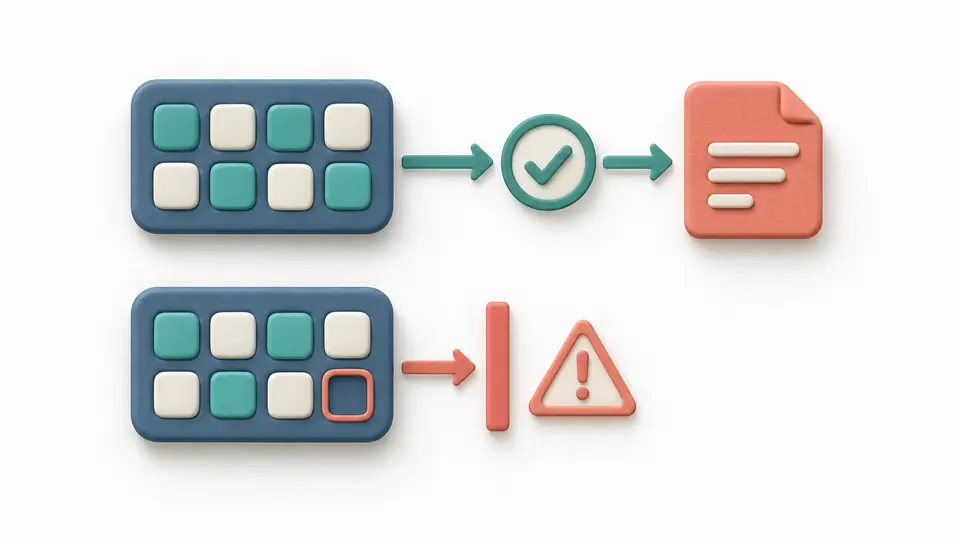
Un groupe de sept bits n’est pas complété par un zéro. Les séquences UTF invalides arrêtent aussi la conversion entière. L’entrée reste visible et le diagnostic indique sa ligne et sa colonne, afin qu’aucun caractère manquant ne passe inaperçu dans le résultat copié.

Des groupes complets franchissent une vérification ; un groupe incomplet est arrêté et mis en évidence.

Choisir l’interprétation avant de sauvegarder

01

Retrouver l’encodage de la source

Pour passer du binaire en texte, sélectionnez le format Binaire ; pour un relevé hexadécimal, choisissez Hex. Précisez ensuite UTF-8 ou l’ordre LE/BE de UTF-16. Le changement de sens laisse l’entrée intacte. Inverser le résultat propose son remplacement dans un aperçu.

02

Maîtriser le rafraîchissement

La conversion automatique attend 350 ms après une modification. Désactivez-la pour utiliser Convertir ou Ctrl/Cmd + Entrée. Toute modification rend immédiatement les anciens exports indisponibles. Séparateur et majuscules concernent uniquement la sortie du mode texte vers octets.

03

Distinguer texte et données binaires

Le fichier TXT contient la représentation affichée en UTF-8 ; BIN contient les octets. Exemple, Effacer et Inverser présentent les quantités remplacées avant application. Un retour à l’état précédent restaure ensemble l’entrée, les réglages et le résultat.

Les détails conservés pendant la conversion

Unicode sans normalisation

Ce traducteur binaire conserve les accents combinés tels qu’ils sont saisis. Il ne normalise pas en NFC et n’ignore aucun caractère hors ASCII. Le nombre de points de code n’est pas celui des glyphes : une séquence d’emoji peut réunir plusieurs points de code visibles comme un seul symbole.

Largeur fixe et zéros initiaux

Un octet fait huit chiffres binaires ou deux chiffres Hex. Espace, aucune séparation, retour à la ligne et virgule ne changent que la présentation. Le décodage accepte les deux casses Hex et les espaces ASCII, tabulations, CR, LF et virgules entre octets complets.

Erreurs à leur emplacement d’origine

Chiffres incorrects, octets incomplets, continuations UTF-8 invalides et paires de substituts UTF-16 cassées sont refusés. Le numéro d’octet renvoie à la position dans la saisie. U+FFFD correctement encodé reste un caractère valide ; il n’est jamais inséré pour masquer une erreur.

Aperçu progressif sans perte à l’export

L’encodage affiche d’abord 100 octets, le décodage 100 points de code. Chaque extension ajoute 100 éléments sans couper un octet ni une paire UTF-16. La copie et les téléchargements utilisent toujours le résultat complet, y compris sa partie non affichée.

Formats acceptés et limites

Des octets entiers uniquement
0100 0001 n’est pas rassemblé en un octet. Retirez vous-même les préfixes 0x ou 0b, échappements avec barre oblique inverse, crochets, adresses et colonnes textuelles de dump. L’outil ne filtre pas les caractères inconnus.
Trois encodages explicites
UTF-8, UTF-16LE et UTF-16BE sont proposés. Pas de détection automatique, de UTF-16 sans ordre précisé, de mode ASCII strict, de GBK, Shift_JIS ou EUC-KR. Des octets valides dans un encodage peuvent tout de même produire un texte différent de l’original.
Le contenu n’est pas nettoyé
Espaces du texte, NUL, fins de ligne, marques combinées et U+FEFF sont conservés. Aucun BOM n’est ajouté ou retiré et aucun ne remplace votre choix d’ordre des octets. Les transformations du presse-papiers ou du système antérieures à la saisie ne peuvent pas être annulées ici.
Un dépassement bloque la conversion
Texte et résultat décodé : 65 536 unités UTF-16. Notation des octets : 2 097 152 caractères et 196 608 octets maximum ; sortie : 2 097 152 caractères. Un excès produit une erreur sans troncature. Aucun import de fichier, chargement d’URL ou traitement par lots.
Un TXT reste en UTF-8
Même avec UTF-16 sélectionné, TXT sauvegarde la représentation en UTF-8. Pour récupérer les vrais octets UTF-16, utilisez BIN. Ces octets ne sont pas analysés comme une image, une archive ou un programme. Aucun fichier source n’est écrasé.
Pas de calcul numérique ni de chiffrement
42 désigne ici les caractères 4 et 2. La conversion de l’entier 42, le complément à deux, les flottants, le décimal, l’octal, Base64 et les échappements de points de code relèvent d’autres outils. Une représentation binaire n’assure aucune confidentialité.

Questions sur Texte en binaire

Comment convertir du binaire en texte ?

Choisissez Octets → texte et le format Binaire, puis l’encodage utilisé à l’origine. La commande Inverser le résultat permet aussi de reprendre la sortie actuelle après vérification de l’aperçu. Chaque groupe doit former des octets complets et une séquence UTF valide.

Pourquoi 42 ne donne-t-il pas 101010 ici ?

Parce que 42 est ici une chaîne de deux caractères. En UTF-8, elle donne les octets 34 32 en Hex, soit 00110100 00110010 en binaire. 101010 représente la valeur entière 42 ; cette opération nécessite un convertisseur de bases numériques.

Le binaire est-il un chiffrement ?

Non. Le binaire et l’hexadécimal sont des représentations réversibles, sans clé secrète. Toute personne connaissant l’encodage peut retrouver le message. Ils ne remplacent pas le chiffrement pour protéger des informations.

Pourquoi un accent produit-il plusieurs octets ?

UTF-8 utilise un nombre variable d’octets. é donne C3 A9, tandis que e suivi d’un accent combiné donne une autre séquence. La conversion conserve ces deux formes sans les normaliser, même si elles paraissent identiques à l’écran.

Des espaces entre les octets sont-ils acceptés ?

Oui, entre des octets complets. Tabulations, retours à la ligne et virgules sont également acceptés, ainsi qu’une suite sans séparateur. Une coupure au milieu de huit bits, par exemple 0100 0001, est en revanche une erreur.

Une autre question ?

Examiner une suite d’octets

Texte en binaire permet de comparer une même chaîne en UTF-8 et dans les deux ordres UTF-16. Vérifiez le nombre d’octets, puis sauvegardez la représentation attendue pour la suite.

Un octet contient toujours huit bits ; un caractère peut occuper plusieurs octets.