01
바이트 표기와 인코딩을 각각 선택
이진수 텍스트 변환에는 이진수 형식을, Hex 로그에는 16진수 형식을 선택하세요. 이후 원본 인코딩을 지정합니다. UTF-16은 LE 또는 BE를 명시해야 합니다. 방향만 바꾸면 입력은 그대로이며, 결과를 입력으로 옮기려면 역변환 미리 보기를 적용해야 합니다.
문자를 저장하는 실제 바이트
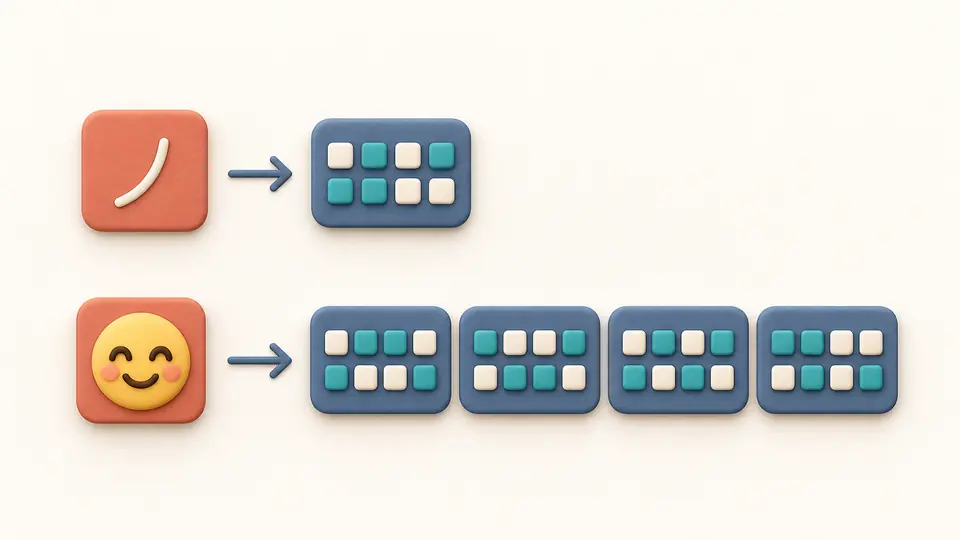
문자 인코딩을 지정해 텍스트와 이진수·16진수를 양방향으로 변환합니다. 예제는 코드 포인트 4개, 바이트 10개입니다.
변환은 현재 브라우저에서 처리하며 입력을 전송하거나 기록으로 저장하지 않습니다.
바이트마다 이진수 8자리 또는 Hex 2자리가 필요합니다. 완전한 바이트 사이의 공백, 탭, 줄바꿈, 쉼표와 연속 바이트열을 허용합니다.
선택한 인코딩을 그대로 사용합니다. U+FEFF를 유지하며 BOM 추가·제거 및 바이트 순서 추측을 하지 않습니다.
텍스트: UTF-16 단위 65,536개. 바이트 입력: 2,097,152자. 실제 바이트: 196,608개. 결과: 2,097,152자.
10바이트 · Unicode 코드 포인트 4개 · UTF-16 단위 5개
TXT는 표시된 결과를 UTF-8로 저장합니다. BIN은 실제 인코딩하거나 해석한 바이트를 저장합니다.
한글 이진수 데이터를 복원할 때 바이트를 문자 번호로 읽으면 엉뚱한 결과가 나올 수 있습니다. 텍스트 이진수 변환기는 인코딩과 바이트 표기를 구분해 로그나 테스트 데이터를 확인하도록 돕습니다. 오류 없이 디코딩된 문자열이라도 원래 인코딩과 다를 수 있으므로 데이터가 만들어진 환경을 먼저 확인하세요.
텍스트 이진수 변환기는 모든 문자를 한 바이트로 취급하지 않습니다. UTF-8에서 영문 A는 1바이트, é는 2바이트, 中은 3바이트, 😀는 4바이트입니다. 한글 음절도 보통 3바이트를 사용합니다. UTF-16 LE와 BE를 비교하면 각 16비트 단위 안에서 바이트 순서가 바뀌는 것을 볼 수 있습니다.
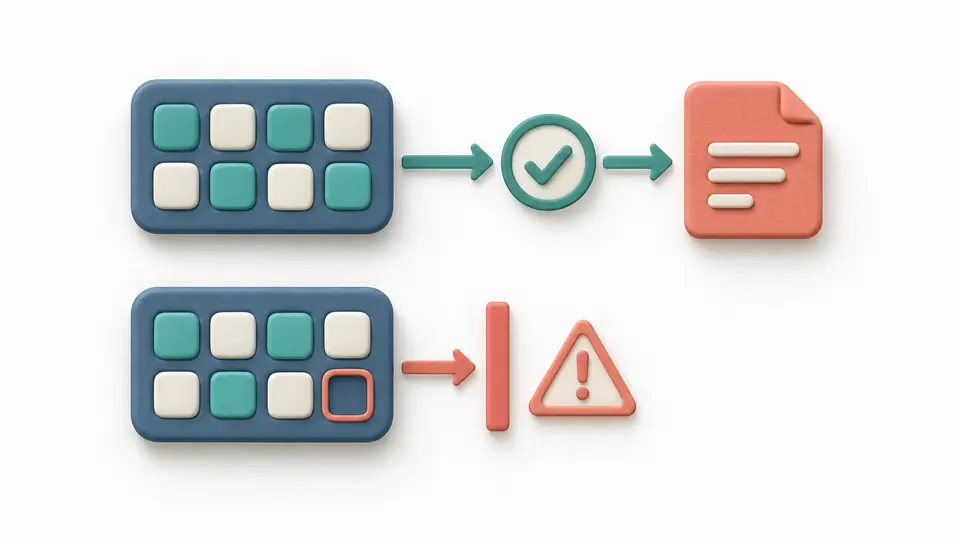
7자리 이진수에 0을 채우거나 변환할 수 없는 내용을 건너뛰지 않습니다. 잘못된 바이트나 UTF 시퀀스가 있으면 전체 변환을 중단하고 원본 입력을 남깁니다. 오류가 있는 행과 열을 확인한 뒤 수정할 수 있어 일부 문자가 사라진 결과를 복사하는 실수를 줄입니다.
이진수 텍스트 변환에는 이진수 형식을, Hex 로그에는 16진수 형식을 선택하세요. 이후 원본 인코딩을 지정합니다. UTF-16은 LE 또는 BE를 명시해야 합니다. 방향만 바꾸면 입력은 그대로이며, 결과를 입력으로 옮기려면 역변환 미리 보기를 적용해야 합니다.
입력 후 350ms가 지나면 자동으로 실행합니다. 끄면 변환 버튼과 Ctrl/Cmd + Enter를 사용할 수 있습니다. 입력이나 옵션이 바뀌는 즉시 기존 결과의 내보내기가 비활성화됩니다. 출력 구분자와 대문자 옵션은 텍스트를 바이트로 만들 때만 적용됩니다.
TXT는 화면의 결과를 UTF-8로 저장하고 BIN은 실제 바이트를 저장합니다. 예제, 비우기, 결과 역변환은 바뀌는 단위 수를 먼저 보여 줍니다. 적용 후 한 번 실행 취소하면 입력, 결과와 옵션을 함께 복원합니다.
한글과 이모지는 선택한 UTF 규칙에 따라 여러 바이트로 바뀝니다. 결합 악센트는 입력한 형태로 유지하며 NFC 정규화를 하지 않습니다. 표시되는 코드 포인트 수는 눈에 보이는 글자 수와 다릅니다. 여러 코드 포인트로 구성된 이모지도 각각 계산합니다.
이진수는 8자리, 16진수는 2자리가 한 바이트입니다. 공백, 구분 없음, 줄바꿈, 쉼표 중 어떤 출력을 선택해도 바이트 값은 같습니다. 디코딩은 Hex 대소문자를 모두 허용하며 완전한 바이트 사이의 ASCII 공백, 탭, CR, LF와 쉼표를 처리합니다.
잘못된 숫자, 불완전한 바이트, UTF-8 연속 바이트 오류와 UTF-16 서로게이트 쌍 오류를 구분합니다. 바이트 번호를 원본 입력의 행과 열에 연결합니다. 원래부터 올바르게 인코딩된 U+FFFD는 유지하며, 오류를 숨기기 위해 새 대체 문자를 넣지는 않습니다.
인코딩 결과는 100바이트, 디코딩 결과는 100개 코드 포인트부터 보여 줍니다. 100개씩 더 볼 수 있고 바이트나 서로게이트 쌍 중간에서 끊지 않습니다. 복사와 두 다운로드 방식에는 펼치지 않은 부분까지 포함한 전체 유효 결과를 사용합니다.
네. UTF-8에서 한글 음절은 보통 3바이트이고 😀는 F0 9F 98 80의 4바이트입니다. UTF-16의 이모지는 서로게이트 쌍으로 인코딩됩니다. 짝이 없는 서로게이트는 거부하지만 유효한 한글과 이모지는 빠짐없이 변환합니다.
완전한 바이트 사이의 공백은 허용합니다. 탭, 줄바꿈, 쉼표도 가능하며 구분 없는 연속 바이트도 처리합니다. 다만 0100 0001처럼 한 바이트를 중간에서 나눈 그룹은 오류입니다. 출력 구분자 설정을 입력과 맞출 필요는 없습니다.
이진수가 8자리 단위로 완성되지 않았거나 0·1 외의 문자가 들어갔을 수 있습니다. 바이트가 완전해도 원래 인코딩과 다른 UTF를 선택했거나 시퀀스가 손상되면 실패합니다. 화면에 표시되는 원본 행과 열, 바이트 번호를 확인하세요.
텍스트와 디코딩 결과는 UTF-16 단위 65,536개까지입니다. 바이트 표기는 2,097,152자, 실제 데이터는 196,608바이트까지 허용합니다. 이모지는 한 코드 포인트가 UTF-16 단위 두 개를 사용할 수 있으므로 단순한 글자 수와는 다릅니다.
EUC-KR은 지원하지 않습니다. 이 페이지는 UTF-8과 UTF-16 LE·BE를 명시적으로 선택하는 도구입니다. EUC-KR 데이터를 UTF-8로 해석해 생긴 오류를 문자를 버리거나 대체하는 방식으로 숨기지 않습니다. 원래 인코딩을 지원하는 변환기를 사용하세요.
더 궁금한 점이 있나요?