OS BYTES POR TRÁS DOS CARACTERES

Texto para binário

Converta texto em bytes ou recupere o texto escolhendo a codificação. O exemplo tem quatro pontos de código e dez bytes.

Texto para binário

Entrada de texto ou bytes

Resultado

A conversão acontece neste navegador. A entrada não é enviada nem salva em um histórico.

Opções de conversão

Cada byte tem 8 dígitos binários ou 2 dígitos Hex. Grupos completos podem ficar juntos ou separados por espaços, tabulações, quebras de linha e vírgulas.

A codificação escolhida é usada diretamente. U+FEFF é mantido; nenhum BOM é inserido, removido ou usado para adivinhar a ordem dos bytes.

Texto: 65.536 unidades UTF-16. Entrada de bytes: 2.097.152 caracteres. Dados: 196.608 bytes. Saída: 2.097.152 caracteres.

10 bytes · 4 pontos de código Unicode · 5 unidades UTF-16

TXT salva a representação exibida em UTF-8. BIN salva os bytes realmente codificados ou interpretados.

Texto para binário ajuda a conferir uma mensagem em um log ou preparar os bytes de um teste. Um acento, um espaço e um emoji têm papéis diferentes na sequência codificada. Escolha a codificação usada na origem antes de interpretar os dados: um resultado aceito pelas regras de UTF ainda pode representar outro texto se a escolha estiver errada.

Por que usar Texto para binário

Enxergar cada caractere em bytes

Texto para binário codifica a cadeia Unicode inteira antes de formatar os bytes. Em UTF-8, A ocupa um byte, é dois, 中 três e 😀 quatro. UTF-16 LE e BE trocam a ordem dos dois bytes de cada unidade de 16 bits. Um emoji fora do plano básico continua exigindo um par de substitutos.

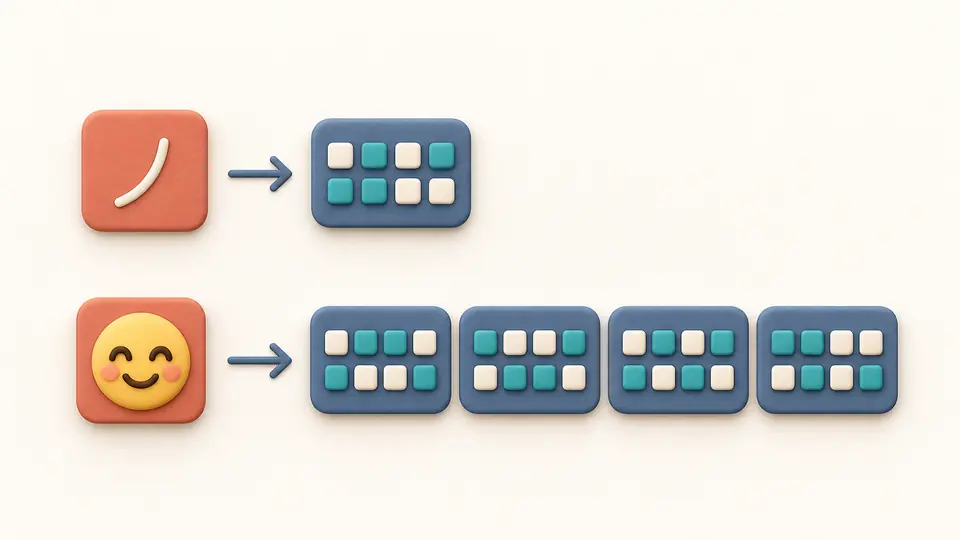
Um símbolo simples se conecta a um bloco de byte e um símbolo complexo se abre em vários blocos iguais.

Não deixar bytes incompletos passarem

Um grupo de sete bits não recebe um zero automaticamente. Sequências UTF inválidas também interrompem a conversão inteira. A entrada é mantida e o erro aponta para sua linha e coluna, evitando uma saída aparentemente pronta que tenha perdido caracteres.

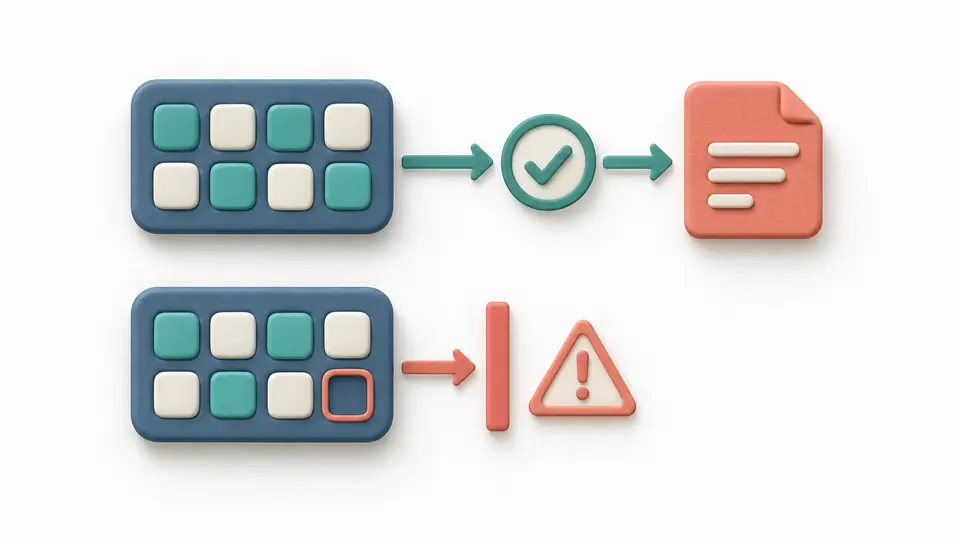
Grupos completos passam pela verificação enquanto um grupo incompleto fica bloqueado e destacado.

Confira a origem e o tipo de saída

01

Escolha formato e codificação separadamente

Para binário para texto, use o formato Binário; para um log hexadecimal, use Hex. Depois indique a codificação original, incluindo LE ou BE no caso de UTF-16. Alterar a direção não move os dados. Inverter resultado apresenta uma prévia antes de substituir a entrada.

02

Controle a atualização automática

O conversor espera 350 ms após a edição. Desligue o modo automático para usar Converter ou Ctrl/Cmd + Enter. Mudanças no texto ou nas opções desativam a exportação antiga imediatamente. Separador e maiúsculas afetam somente a saída do modo texto para bytes.

03

Salve texto ou bytes conforme a necessidade

TXT contém a representação visível em UTF-8 e BIN contém os bytes reais. Exemplo, Limpar e Inverter mostram a quantidade que será substituída. Depois de aplicar, Desfazer restaura uma vez a entrada, as opções e o resultado anteriores.

O que permanece igual durante a conversão

Unicode sem normalização automática

Este conversor de texto para binário mantém acentos combinados como foram digitados, sem normalizar para NFC. Caracteres fora do código ASCII não são descartados. A contagem de pontos de código não equivale à quantidade de símbolos visíveis; um emoji composto pode reunir vários pontos.

Largura fixa e zeros à esquerda

Cada byte ocupa oito dígitos binários ou dois hexadecimais. Espaço, nenhum separador, quebra de linha e vírgula mudam apenas a apresentação. A leitura aceita Hex nas duas caixas e espaços ASCII, tabulações, CR, LF e vírgulas entre bytes completos.

Diagnóstico na entrada original

Dígitos inválidos, bytes pela metade, continuações UTF-8 incorretas e pares UTF-16 quebrados são recusados. A posição do byte é relacionada ao texto colado. Um U+FFFD que já esteja corretamente codificado é mantido; ele nunca é inserido para disfarçar um erro.

Prévia gradual e resultado inteiro

A codificação mostra inicialmente 100 bytes e a decodificação 100 pontos de código. Cada expansão adiciona 100 itens sem dividir bytes nem pares de substitutos. Copiar e baixar usam o resultado atual completo, mesmo que a maior parte ainda não esteja visível.

Entrada aceita e limites do trabalho

Somente bytes completos
0100 0001 não é unido como um byte. Remova antes prefixos 0x e 0b, escapes com barra invertida, colchetes, endereços e colunas de texto de dumps. O programa não filtra caracteres desconhecidos nem completa grupos curtos.
Três codificações explícitas
Há UTF-8, UTF-16LE e UTF-16BE. Não há detecção automática, UTF-16 sem ordem definida, modo exclusivo ASCII, GBK, Shift_JIS ou EUC-KR. Uma codificação incorreta pode gerar texto válido, mas diferente do conteúdo original.
Espaços e BOM são conteúdo
Espaços no texto, NUL, quebras de linha, marcas combinadas e U+FEFF são preservados. Não se insere nem remove BOM e sua presença não altera a ordem escolhida. Mudanças feitas pelo sistema ou pela área de transferência antes da entrada não podem ser recuperadas.
Excesso de dados causa erro
Texto e resultado decodificado: até 65.536 unidades UTF-16. Notação dos bytes: até 2.097.152 caracteres e 196.608 bytes; saída: até 2.097.152 caracteres. Exceder o limite interrompe a conversão, sem cortar o resultado. Importação de arquivos, busca por URL e lotes não estão incluídos.
TXT sempre é salvo em UTF-8
Mesmo escolhendo UTF-16, TXT salva a representação em UTF-8. Para obter os bytes UTF-16 exatos, use BIN. A ferramenta não analisa estruturas de imagens, arquivos compactados ou executáveis e não sobrescreve arquivos de origem.
Sem cálculo de inteiros ou criptografia
42 é tratado como os caracteres 4 e 2. Converter o inteiro 42, complemento de dois, ponto flutuante, decimal, octal, Base64 e escapes de pontos de código são outras tarefas. A escrita em binário ou hexadecimal não protege uma mensagem.

Perguntas sobre Texto para binário

Espaços também viram números?

Sim. Um espaço do texto é conteúdo e vira o byte 20 em Hex ou 00100000 em binário UTF-8. Isso é diferente dos espaços colocados entre os grupos para facilitar a leitura. Alterar o separador da saída não remove os espaços da mensagem.

Binário protege ou oculta uma mensagem?

Não. É uma representação reversível, sem senha ou chave. Quem conhece a codificação pode recuperar o texto. Use criptografia apropriada quando a intenção for proteger o conteúdo; converter para zeros e uns não oferece sigilo.

Por que um emoji gera vários grupos?

Cada grupo representa um byte, não um caractere. Por exemplo, 😀 ocupa os quatro bytes UTF-8 F0 9F 98 80. Em UTF-16 também usa quatro bytes, organizados em um par de unidades. Emojis compostos podem conter vários pontos de código e ocupar ainda mais bytes.

A entrada binária precisa de espaços entre os bytes?

Não. Uma sequência como 0100000101000010 forma dois bytes completos e volta a AB em UTF-8. Também aceitamos espaços, tabulações, quebras de linha e vírgulas entre bytes completos. O separador da saída não precisa corresponder ao da entrada.

O que fazer com um byte binário incompleto?

Confira a fonte e complete corretamente o byte antes de converter. A ferramenta informa o erro na posição original e não adiciona zeros nem descarta o restante. Por exemplo, 1000001 tem sete bits; para a letra A em UTF-8, o byte completo é 01000001.

Ficou alguma dúvida?

Confira uma sequência real

Texto para binário permite comparar a mesma cadeia em UTF-8 e nas duas ordens de UTF-16. Confira a contagem de bytes e escolha o arquivo que a próxima etapa espera receber.

Um byte sempre tem oito bits; um caractere pode precisar de vários bytes.