01
表記と文字コードを別々に選ぶ
バイナリから文字列へ戻すときは2進数、16進ログならHEXを選びます。そのうえで元の文字コードを指定します。UTF-16はLEかBEを明示してください。方向の変更だけでは入力を移しません。結果を使うには逆変換のプレビューを適用します。
文字とバイトの違いを確認
文字列を2進数・HEXへ変換するか、指定した文字コードでバイト列を復号します。サンプルは4コードポイント、10バイトです。
変換はこのブラウザー内で行います。入力の送信や履歴保存はしません。
1バイトは2進数8桁またはHEX2桁。連続した完全なバイトの間では、空白、タブ、改行、カンマを区切りに使えます。
選択した文字コードをそのまま使用します。U+FEFFを保持し、BOMの追加・除去やバイト順の推測は行いません。
テキストは65,536 UTF-16単位まで。バイト入力は2,097,152文字、解析結果は196,608バイト、出力は2,097,152文字まで。
10バイト · 4 Unicodeコードポイント · 5 UTF-16単位
TXTは表示結果をUTF-8で保存します。BINは実際に符号化・解析したバイトを保存します。
通信ログに並んだ数字を読んでも、そのままでは元の日本語を確認できません。テキストバイナリ変換では文字コードを指定して、文字と保存されたバイトの対応を調べられます。復号に成功しても元と同じ文字コードとは限らないため、送信側の設定も確認してください。
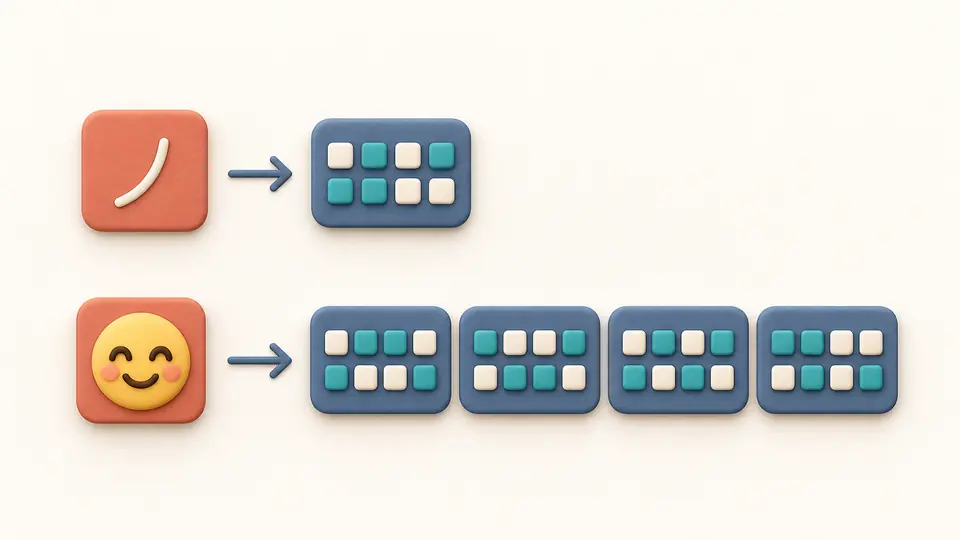
テキストバイナリ変換は、文字を一律に1バイトとみなさず、Unicode文字列を先に符号化します。UTF-8ではAが1バイト、éが2バイト、中が3バイト、😀が4バイトです。UTF-16ではLEとBEで各16ビット単位のバイト順が変わります。
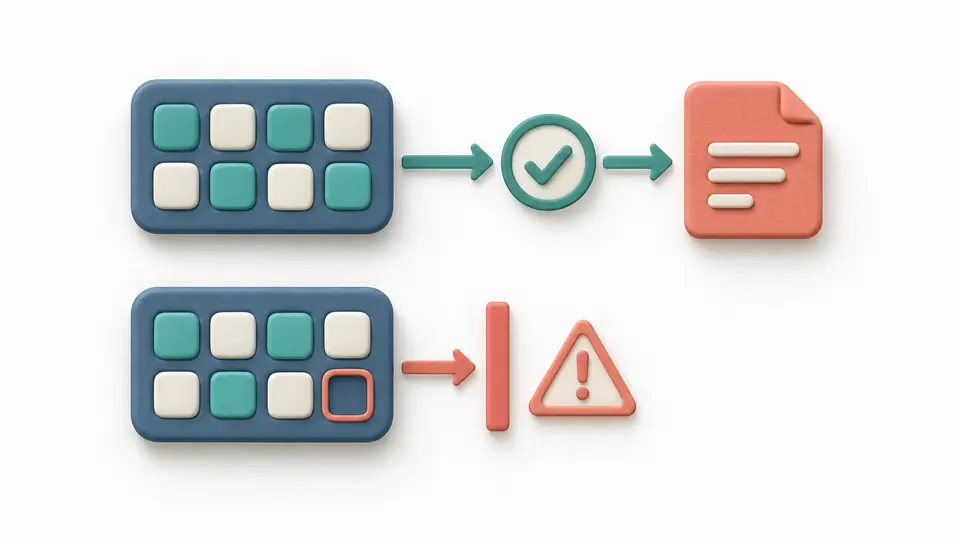
7桁しかない2進数にゼロを補ったり、読めないバイトを削除したりしません。変換を停止して元の入力を残し、問題の行と列を示します。見た目だけ成功した、文字の欠けた結果が出力されるのを防ぎます。
バイナリから文字列へ戻すときは2進数、16進ログならHEXを選びます。そのうえで元の文字コードを指定します。UTF-16はLEかBEを明示してください。方向の変更だけでは入力を移しません。結果を使うには逆変換のプレビューを適用します。
編集後350msで自動変換します。オフにすると変換ボタンが現れ、Ctrl/Cmd + Enterも使えます。入力や設定を変えた時点で古い結果のコピーと保存は無効になります。区切りと大文字の設定は符号化出力にだけ作用します。
TXTは表示された結果をUTF-8の文字列として保存し、BINは元のバイトを保存します。逆変換、サンプル、クリアには置き換え件数のプレビューがあります。適用後は一度だけ入力と結果をまとめて元に戻せます。
2進数変換の前に文字列全体を符号化するため、日本語や絵文字が途中で省略されません。結合文字は結合文字のまま残し、NFC正規化はしません。コードポイント数は見た目の文字数とは異なり、絵文字の連結列も複数として数えます。
2進数は8桁、HEXは2桁が1バイトです。出力の区切りはスペース、なし、改行、カンマから選べます。復号ではHEXの大文字と小文字の両方を受け付け、ASCII空白、タブ、CR、LF、カンマをバイト間の区切りとして扱います。
不正な数字、不完全なバイト、UTF-8の不正な継続バイト、UTF-16のサロゲート対の破損を報告します。バイト番号に加えて元の入力中の行列を示します。正しく符号化されたU+FFFD自体は正当な文字として保持します。
符号化では先頭100バイト、復号では先頭100コードポイントから表示します。100件ずつ追加でき、絵文字のサロゲート対やバイトは途中で分割しません。コピーとダウンロードには、表示していない部分も含む全結果を使います。
はい。バイト→テキストを選び、表記を2進数にして元の文字コードを指定してください。現在の結果なら「結果を逆変換」で入力への置き換えを確認できます。全バイトが完全で、選択したUTFの規則に従っている必要があります。
符号化したバイトの見せ方だけを変えます。元の文字列にあるスペースは内容なのでバイトに変換されます。復号時は完全なバイト間の空白やカンマを受け付けるため、出力の区切り設定を入力と一致させる必要はありません。
まず元の文字コードとバイト順を確認してください。異なる文字コードでもエラーにならず、別の文字に復号される場合があります。NULやU+FEFFなどの見えない文字も保持するため、空白に見える結果ではバイト数も確認してください。
対応する空白やカンマ以外はエラーになります。0b接頭辞、文字列、括弧などを自動で取り除きません。7桁のグループにもゼロを足さず、元の入力位置を示して変換全体を停止します。
グループは文字ではなくバイトを表すためです。例えば😀のUTF-8表記はF0 9F 98 80という4バイトです。UTF-16でもサロゲート対により4バイトを使います。見た目が1つでも複数コードポイントからなる絵文字もあります。
解決しませんでしたか?