01
方向と対象を選ぶ
URLエンコードは空の入力とコンポーネントのエンコードから始まります。単一の値を貼り付けるか、構造を残す場合はURI全体を選択します。フォームではa=1&b=2も1つの値であり、フィールドへ分割しません。
エンコードとエスケープ
コンポーネント・URI・フォーム値に対応
変換はブラウザー内で完了します。入力は送信せず、URLにもアクセスしません。
encodeURIComponentの文字規則を使用。空白は%20、+は%2Bになります。デコード時の元の+はそのままです。
UTF-8のみ、デコードは1回です。デコードでは不正な%表記とUTF-8を拒否し、両方向で孤立UTF-16サロゲートを拒否します。フォームも厳密に検証し、URLSearchParamsの寛容な解析とは異なります。
入力上限は1,048,576 UTF-16単位、出力は4,194,304単位です。空入力は有効です。貼り付け時に改行が正規化される場合があります。
文字列を入力するか例を読み込んでください。空入力の結果は空文字列です。
確認後に最新の結果を入力へ移し、方向を切り替えます。結果が入力の上限を超える場合は使えません。
URLエンコードは、クエリー値を作るときや、コピーした日本語URL、フォーム値を確認するときに使えます。最初に変換対象を選んでください。同じ &、/、+ でも、データか区切り文字かで扱いが変わります。
URLデコードはUTF-8のパーセントエンコーディングを一度だけ戻します。結果は常にプレーンテキストです。アドレスやスクリプトのような内容も、アクセスや実行をせずに確認できます。
URLエンコードではコンポーネント、URI全体、フォームの単一値を選べます。コンポーネントは区切り文字を変換し、URIは構造を保持、フォームは空白を+にします。値の&が別のパラメーターを作ることを避けられます。
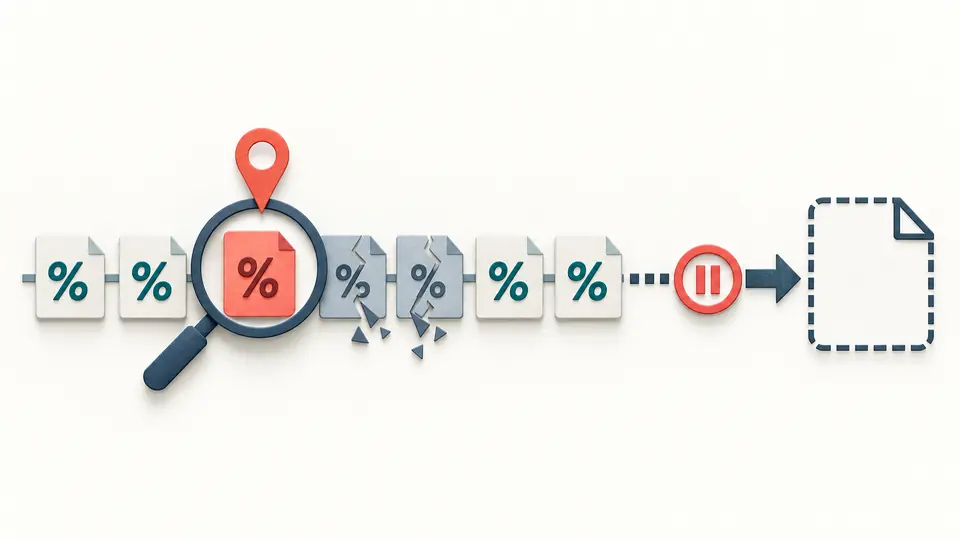
不完全な%表記や不正なUTF-8は、元の入力の行と列を表示し、該当行を強調します。URLエンコードは置換文字で問題を隠さず、途中までのデコード結果も書き出しません。
URLエンコードは空の入力とコンポーネントのエンコードから始まります。単一の値を貼り付けるか、構造を残す場合はURI全体を選択します。フォームではa=1&b=2も1つの値であり、フィールドへ分割しません。
自動変換は編集から350ミリ秒待って実行します。オフにすると変換ボタンが現れ、Ctrl/Cmd+Enterでも実行できます。入力や設定を変えると、新しい結果が成功するまで書き出しは無効です。空入力も有効です。
例、クリア、逆方向変換は適用前にプレビューします。逆方向変換は結果を入力にして方向も切り替えます。取り消しで入力・設定・結果をまとめて復元します。コピーとTXT保存は全文を使用します。
encodeURIComponentに従い、ASCII英数字と-_.!~*'()を保持します。空白は%20、&は%26、/は%2Fになります。既存の%も%25へ再エンコードします。
URI全体ではさらに;/?:@&=+$,#を保持します。デコードでもこれらのエスケープと元の大小文字を残すため、%2fは%2fのままです。アドレスの解析、検証、修復は行いません。
フォームの単一値ではASCII英数字と*-._のみを保持します。空白は+、文字としての+は%2Bになります。%2Bをデコードして得た+を、さらに空白へ変更することはありません。
日本語、アクセント付き文字、絵文字をUTF-8のバイト表記にします。行と列は1から数え、列はUTF-16コード単位です。不正なマルチバイト列は先頭の%を示します。
encodeURIComponentは単一のクエリー値やパス要素に向き、&や/も変換します。encodeURIはURIの構造文字を保持します。値の中の&か区切りかは自動判定できないため、値ごとに変換してから組み立ててください。
はい。日本語をUTF-8のバイト列へ変換し、各バイトを%と2桁の16進数で表します。例えば「中」は%E4%B8%ADです。有効なUnicode文字や絵文字も扱えます。
フォームの単一値では+が空白を表します。コンポーネントとURIのデコードでは元の+をそのまま保持します。文字としての+をフォーム値へ入れる場合は%2Bになり、デコード後もプラスのままです。
%の後に16進数2桁がないか、バイト列が有効なUTF-8ではない可能性があります。表示された元の行と列を修正してください。本ツールは孤立UTF-16サロゲートも拒否し、部分結果を出力しません。
%も%25に変わるため、%20を再エンコードすると%2520になります。1回のデコードは1層だけ戻します。必要な層数を確認してから、意図的に次のデコードを行ってください。
パーセント変換の問題が見つかりましたか?