01
既定の保持範囲を知る
印字可能なASCIIとTAB、CR、LFは既定で保持します。ただし&、<、>、一重引用符、二重引用符、バッククォートは必ず変換し、非ASCII文字も変換します。保持をオフにすると全ての文字が対象です。
エンコードとエスケープ
文字参照を一層ずつ確認
最大20,000 UTF-16単位を文字として表示し、マークアップは実行しません。
変換はこのブラウザー内で行い、入力は送信しません。
U+0020–U+007EとTAB、CR、LFを保持しますが、&、<、>、両引用符、バッククォートは除きます。保持をオフにすると全てを変換。デコードはHTML5のテキストまたは属性規則で一層だけ処理し、未知の参照は残します。不正な数値参照とC1にはHTMLの置換を適用します。
入力上限は1,048,576 UTF-16単位、出力は4,194,304単位です。空入力は有効です。貼り付け時に改行が正規化される場合があります。
テキストを入力するかサンプルを選んでください。空入力の結果は空文字列です。
確認後に最新の結果を入力へ移し、方向を切り替えます。結果が入力の上限を超える場合は使えません。
記事に載せるタグを文字として見せたいとき、HTMLエンティティ変換で山括弧や引用符の表現を確認できます。HTMLエンコードでは名前付き参照を優先し、必要なら数値文字参照へ切り替えられます。
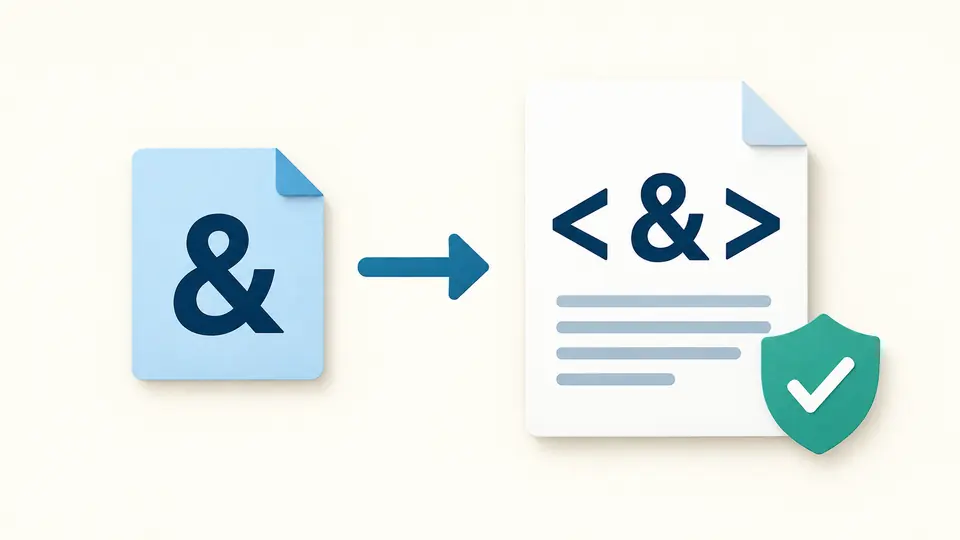
HTMLデコードは文書の描画とは別の処理です。CMSから取り出した文字列を読める形に戻しても、その結果をページとして解析したり実行したりはしません。
HTMLエンティティ変換なら、同じ文字を名前付き・10進数・16進数で表せます。対応する名前がない場合は大文字の16進数へフォールバックするため、名前の有無を調べる手間を省けます。
デコードで現れた山括弧も、結果欄では文字のままです。サンプルコードや二重に変換された文章を調べても、タグが画面の要素として動作することはありません。
印字可能なASCIIとTAB、CR、LFは既定で保持します。ただし&、<、>、一重引用符、二重引用符、バッククォートは必ず変換し、非ASCII文字も変換します。保持をオフにすると全ての文字が対象です。
自動変換は編集から350ms後に動作します。オフにすると変換ボタンが現れ、Ctrl/Cmd+Enterでも実行できます。入力や設定が変わると、更新完了までコピーと保存は無効になります。
サンプル、クリア、結果から逆変換は適用前にプレビューを表示します。元に戻すと入力・設定・結果をまとめて復元します。表示は最大20,000 UTF-16単位で代理対を分断せず、書き出しは全文です。
&や<だけでなく、HTML5の完全な名前付き参照表を使います。デコードでは10進数と16進数の参照を同じ入力に混在させられます。 HTML5の名前付き参照は二つのコードポイントをまとめて表す場合があり、全文のエンコードではfjがfjになることがあります。
既定はテキスト文脈です。属性文脈では、セミコロンを省略した一部の旧形式について、後続のASCII英数字や等号によって認識が変わります。
&lt;をデコードすると<になります。未知の参照はそのまま残すため、必要な場合だけ出力を確認して追加の変換を行えます。
生のNULと孤立したUTF-16サロゲートは行・列付きのエラーになります。一方、不正な数値参照はHTMLの置換規則に従います。
HTMLエンティティ変換は、説明文中の<article>などを文字参照で表したいときに使えます。実際の出力先では、挿入する文脈に合ったエスケープ処理も確認してください。
CMSやAPIから得た<や&を読みやすい文字に戻したい場合です。出力は文字列として確認でき、HTML文書として実行されません。
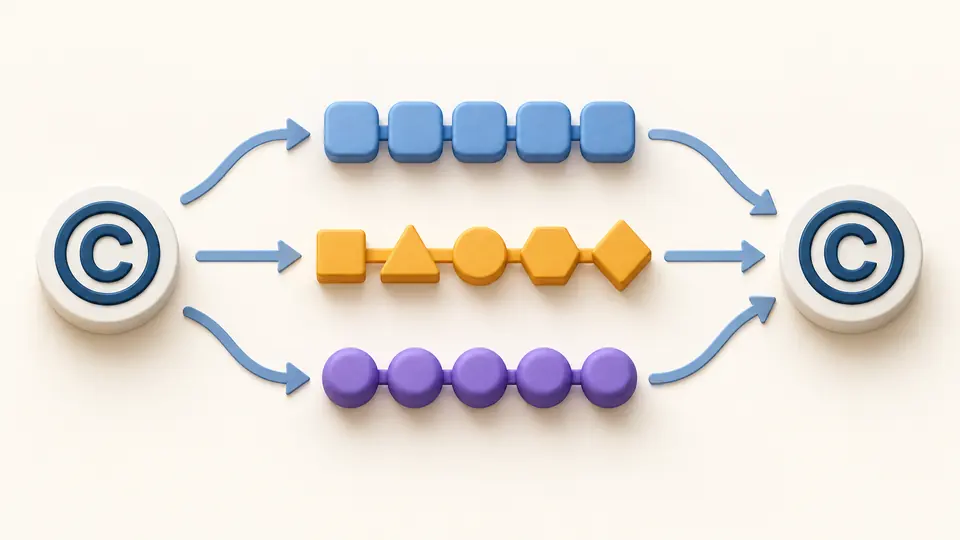
©は名前から文字を参照し、©と©はコードポイントで同じ文字を指定します。名前付き形式でも名前のない文字には16進数参照を使います。
異なります。文字参照はHTMLの文字表現で、URLのパーセントエンコードとは規則も目的も違います。このページはURL変換を行いません。
しません。結果とプレビューはプレーンテキストです。ただし、コピーした文字列を別のアプリでHTMLとして挿入する場合の安全性まで保証するものではありません。
説明のない変換エラーがありましたか?