01
Identifica el destino del texto
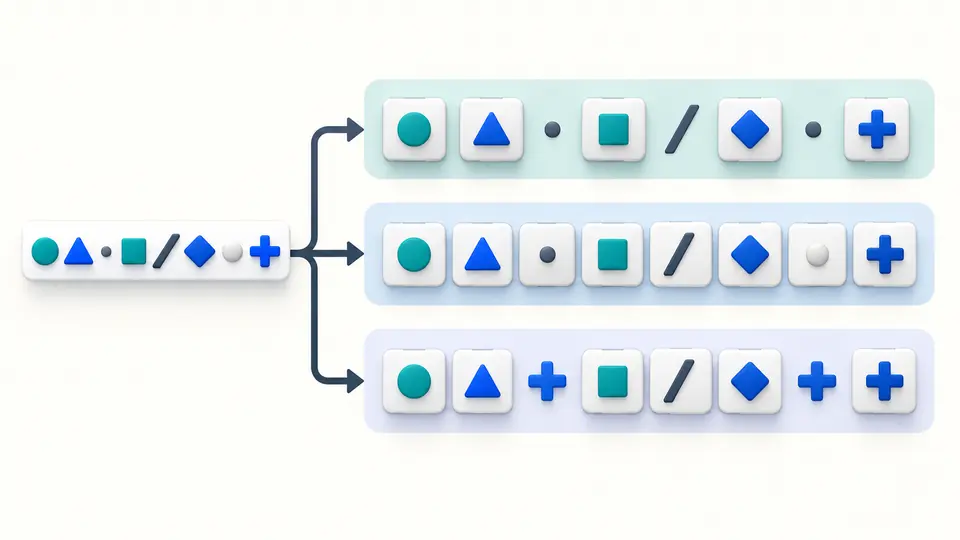
Para un término de búsqueda o una URL dentro de un parámetro, usa Componente. URI completa conserva caracteres como / y ?.
Codificación y escape
con el contexto correcto
La conversión se realiza en este navegador; la entrada no se sube.
Como encodeURIComponent: escapa separadores dentro de un valor. Al decodificar, + sigue siendo un signo más.
Cada decodificación procesa una sola capa. Las secuencias porcentuales, bytes UTF-8 o sustitutos UTF-16 aislados no válidos producen un error. No analiza consultas ni repara automáticamente.
Entrada: 1.048.576 unidades UTF-16; salida: 4.194.304; vista previa: 20.000. Pegar puede normalizar los saltos de línea.
Introduce texto o carga un ejemplo. La conversión manual acepta una entrada vacía y genera una salida vacía.
Tras confirmar, el resultado actualizado reemplaza la entrada y cambia la dirección. No está disponible si el resultado supera el límite de entrada.
Codificar URL resulta útil cuando una búsqueda contiene & o una dirección de retorno debe entrar dentro de otro enlace. Elegir el contexto evita que esos datos se conviertan en separadores.
También puedes decodificar URL para leer valores de registros. Este codificador URL usa codificación porcentual sobre bytes UTF-8: una ñ ocupa más de una secuencia.
Codificar URL en modo Componente convierte un & del valor en %26. URI completa conserva los separadores porque supone que la dirección ya está montada.
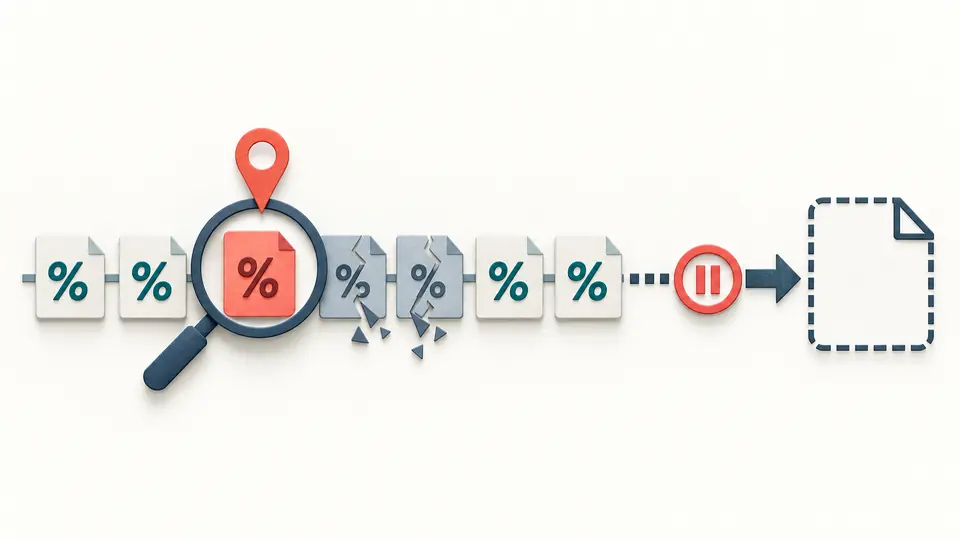
Un % incompleto o bytes UTF-8 inválidos detienen la conversión. La posición del error permite revisar el origen sin aceptar un resultado inventado.
Para un término de búsqueda o una URL dentro de un parámetro, usa Componente. URI completa conserva caracteres como / y ?.
El modo automático espera 350 ms después de un cambio. Desactívalo para mostrar Convertir, o usa Ctrl/Cmd+Enter. Cambiar la entrada o las opciones deja obsoleto el resultado anterior y bloquea copiar y descargar hasta completar otra conversión.
Ejemplo, Limpiar e Invertir muestran una vista previa antes de Aplicar. Deshacer restaura juntos entrada, opciones y resultado. Invertir usa el resultado actual como entrada y cambia la dirección: no ejecuta una segunda decodificación. La vista previa muestra hasta 20.000 unidades UTF-16.
encodeURIComponent escapa los signos estructurales que pertenecen al valor.
Conserva los separadores al codificar. Al decodificar, mantiene los escapes reservados con su escritura original.
Convierte un único valor con la convención de espacios y signos +.
Rechaza secuencias inválidas y sustitutos UTF-16 aislados indicando su posición.
Codificar cambia los caracteres por secuencias aptas para el contexto elegido. Decodificar recupera una capa del texto representado por esas secuencias.
20 es el valor hexadecimal del byte del espacio. El modo Formulario usa + por la convención de los formularios HTML.
Un % suelto, dígitos no hexadecimales o bytes que no formen UTF-8 válido. Revisa la línea y columna indicadas antes de repetir.
Puedes elegir ambos contextos. Codificar URL como Componente también escapa /, ? y &, por lo que debes reservarlo para un valor individual.
Para preparar un valor application/x-www-form-urlencoded. Al decodificarlo, el mismo modo convierte + en espacio y %2B en un signo más literal.
¿Encontraste una secuencia inesperada?
Codificar URL con el contexto elegido te permite revisar cada valor antes de incorporarlo a una solicitud.