LOS BYTES DETRÁS DEL TEXTO

Texto a binario

Convierte texto en bytes o recupera texto con una codificación explícita. El ejemplo contiene cuatro puntos de código y diez bytes.

Texto a binario

Entrada de texto o bytes

Resultado

La conversión se realiza en este navegador; la entrada no se envía ni se guarda en un historial.

Opciones de conversión

Cada byte requiere 8 cifras binarias o 2 Hex. Los grupos completos pueden ser continuos o separarse con espacios, tabulaciones, saltos de línea y comas.

Se aplica la codificación elegida. U+FEFF se conserva; no se añade ni elimina un BOM, ni se usa para adivinar el orden de los bytes.

Texto: 65.536 unidades UTF-16. Entrada de bytes: 2.097.152 caracteres. Datos: 196.608 bytes. Salida: 2.097.152 caracteres.

10 bytes · 4 puntos de código Unicode · 5 unidades UTF-16

TXT guarda la representación visible en UTF-8. BIN guarda los bytes realmente codificados o interpretados.

Texto a binario ayuda a revisar mensajes de protocolo y datos de prueba cuando una tilde ocupa más espacio del esperado. La representación del byte y la codificación del carácter son decisiones distintas. Compara los bytes UTF-8 o UTF-16 con la fuente original; que una secuencia se decodifique sin errores no demuestra que hayas elegido su codificación correcta.

Por qué usar Texto a binario

Seguir cada carácter hasta sus bytes

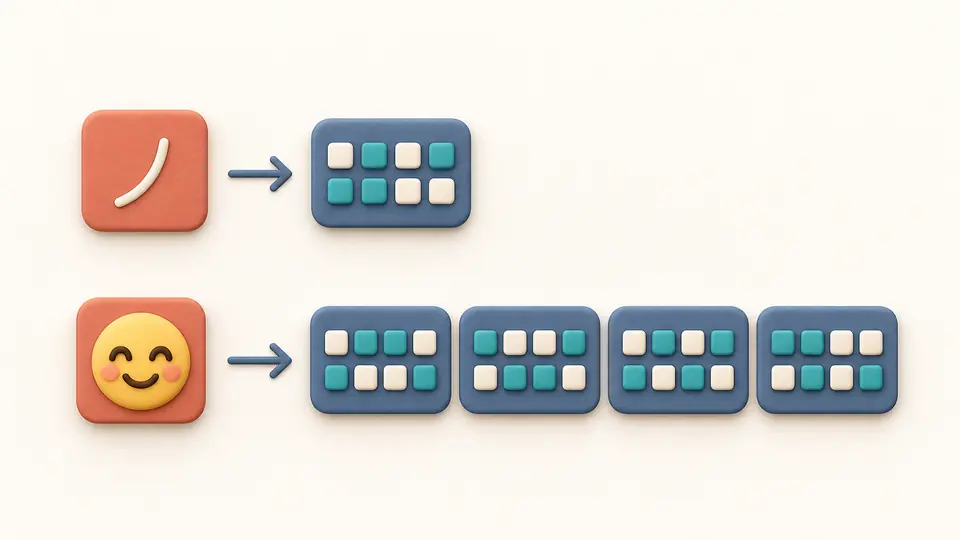
Texto a binario codifica primero la cadena Unicode completa. En UTF-8, A ocupa un byte, é dos, 中 tres y 😀 cuatro. UTF-16 LE y BE intercambian los dos bytes de cada unidad de 16 bits; un emoji fuera del plano básico sigue necesitando un par de sustitutos.

Un símbolo sencillo corresponde a una casilla de byte y uno complejo se despliega en varias casillas iguales.

Detectar un grupo incompleto

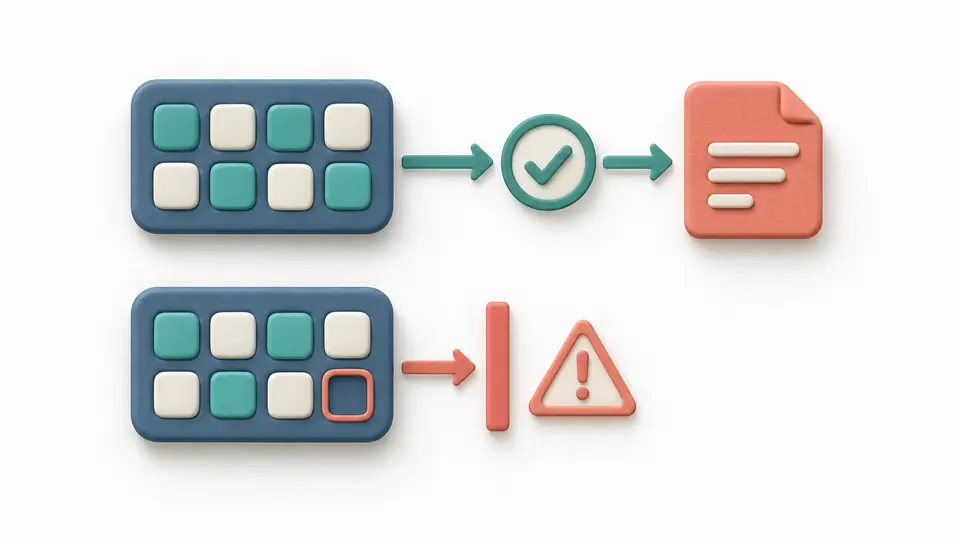
Un grupo de siete bits no se rellena con ceros. Una secuencia UTF inválida también detiene toda la conversión. La entrada permanece visible y el error apunta a su línea y columna, para evitar un resultado aparentemente correcto al que le falten caracteres.

Los grupos completos pasan una comprobación y un grupo incompleto queda detenido y resaltado.

Comprobar la interpretación antes de guardar

01

Elegir formato y codificación por separado

Para pasar de binario a texto, selecciona Binario; para un registro hexadecimal, Hex. Indica después UTF-8 o el orden LE/BE de UTF-16. Cambiar la dirección conserva la entrada. Invertir resultado muestra una vista previa antes de sustituirla por la salida actual.

02

Decidir cuándo actualizar

La conversión automática espera 350 ms tras editar. Desactívala para usar Convertir o Ctrl/Cmd + Intro. Cualquier cambio de entrada u opciones bloquea inmediatamente la exportación antigua. El separador y las mayúsculas solo afectan a la salida de texto a bytes.

03

Guardar la representación adecuada

TXT contiene el resultado visible en UTF-8 y BIN contiene los bytes reales. Ejemplo, Vaciar e Invertir indican cuántas unidades reemplazarán antes de aplicar. Deshacer restaura una vez la entrada, las opciones y el resultado anteriores.

Qué conserva cada conversión

Unicode sin normalización

Las tildes combinadas conservan su forma original; no se aplica NFC ni se descartan caracteres fuera de ASCII. Los puntos de código no equivalen a letras visibles: un emoji compuesto puede contener varios. La ñ precompuesta y una n con tilde combinada pueden verse iguales y tener bytes distintos.

Anchura fija y ceros iniciales

Cada byte ocupa ocho cifras binarias o dos hexadecimales. Espacio, ningún separador, salto de línea y coma cambian solo la presentación. Al decodificar se aceptan ambas cajas Hex y espacios ASCII, tabulaciones, CR, LF y comas entre bytes completos.

Errores con la ubicación original

Se rechazan cifras inválidas, bytes incompletos, continuaciones UTF-8 incorrectas y pares UTF-16 rotos. La posición del byte se relaciona con la entrada pegada. Un U+FFFD correctamente codificado se conserva; nunca se añade ese carácter para ocultar un fallo.

Vista parcial con exportación completa

La vista empieza por 100 bytes al codificar o 100 puntos de código al decodificar. Puedes añadir 100 elementos cada vez sin partir bytes ni pares de sustitutos. La copia y ambas descargas siempre incluyen el resultado actual completo, aunque una parte no esté visible.

Formato de entrada y límites reales

Solo bytes enteros
0100 0001 no se une como un byte. Retira antes los prefijos 0x y 0b, escapes con barra inversa, corchetes, direcciones y columnas de texto del volcado. El analizador no filtra caracteres desconocidos ni rellena grupos cortos.
Tres codificaciones explícitas
Se admiten UTF-8, UTF-16LE y UTF-16BE. No hay detección automática, UTF-16 sin orden indicado, modo ASCII exclusivo, GBK, Shift_JIS o EUC-KR. Una codificación incorrecta puede producir texto válido que no sea el original.
El contenido no se limpia
Se conservan espacios del texto, NUL, saltos de línea, marcas combinadas y U+FEFF. No se añade ni elimina un BOM, ni se cambia el orden elegido por su firma. Los cambios hechos por el sistema o el portapapeles antes de pegar no se pueden recuperar.
Los excesos generan errores
Texto y salida decodificada: 65.536 unidades UTF-16. Notación de bytes: 2.097.152 caracteres y hasta 196.608 bytes; salida: 2.097.152 caracteres. Superar el límite detiene la conversión sin truncarla. No se importan archivos ni URL y no hay procesamiento por lotes.
TXT siempre usa UTF-8
Aunque elijas UTF-16, TXT guarda la representación visible en UTF-8. Usa BIN para los bytes UTF-16 exactos. La herramienta no interpreta la estructura de imágenes, archivos comprimidos o ejecutables, ni sobrescribe archivos originales.
No calcula enteros ni cifra mensajes
42 se interpreta como los caracteres 4 y 2. La conversión del entero 42, complementos de negativos, coma flotante, decimal, octal, Base64 y escapes de puntos de código son tareas distintas. El código binario no ofrece protección criptográfica.

Preguntas sobre Texto a binario

¿Cómo decodifico código binario a texto?

Selecciona Bytes → texto y Binario, e indica la codificación de origen. También puedes invertir el resultado actual tras revisar su vista previa. El flujo debe contener bytes completos y ser válido según la codificación UTF seleccionada.

¿Qué formato de binario acepta el decodificador?

Grupos de 0 y 1 cuya longitud sea múltiplo de ocho. Pueden ir seguidos o separados mediante espacios ASCII, tabulaciones, saltos de línea y comas. No se aceptan prefijos ni texto adicional. El separador configurado para la salida no limita los separadores de entrada.

¿Funcionan las tildes y los emojis?

Sí. En UTF-8, é se representa como C3 A9 y 😀 como F0 9F 98 80. Las marcas combinadas se conservan sin normalizar. Un sustituto UTF-16 aislado se rechaza en lugar de sustituirse silenciosamente por otro carácter.

¿Qué ocurre si faltan bits para completar un byte?

Se informa de un error en el grupo original y se detiene la conversión entera. No se añaden ceros ni se descartan bits. Por ejemplo, 1000001 tiene siete bits y debes introducir 01000001 si el byte deseado es el de la letra A en UTF-8.

¿Por qué 42 no es 101010 aquí?

Porque se codifica el texto 42, no su valor numérico. Los caracteres producen los bytes UTF-8 34 32 en Hex, o 00110100 00110010 en binario. El entero 42 sí es 101010 en base dos y debe tratarse con un convertidor de bases numéricas.

¿Te queda alguna duda?

Revisar una secuencia real

Texto a binario permite comparar la misma cadena en UTF-8 y en ambos órdenes UTF-16. Confirma la cantidad de bytes y elige el tipo de archivo que necesita tu siguiente paso.

Un byte siempre tiene ocho bits; un carácter puede necesitar varios bytes.