КАКИЕ БАЙТЫ СТОЯТ ЗА СИМВОЛОМ

Текст в двоичный код

Преобразуйте текст в байты или восстановите текст, явно указав кодировку. В примере четыре кодовые точки и десять байтов.

Текст в двоичный код

Текст или байты на входе

Результат

Преобразование выполняется в браузере. Входные данные не отправляются и не сохраняются в истории.

Параметры преобразования

В каждом байте 8 двоичных или 2 шестнадцатеричных цифры. Целые группы можно соединять либо разделять пробелами, табуляцией, переносами строк и запятыми.

Используется выбранная кодировка. U+FEFF сохраняется; BOM не добавляется, не удаляется и не определяет порядок байтов автоматически.

Текст: 65 536 единиц UTF-16. Запись байтов: 2 097 152 символа. Данные: 196 608 байтов. Вывод: 2 097 152 символа.

Байты: 10 · Кодовые точки Unicode: 4 · Единицы UTF-16: 5

TXT сохраняет отображаемый результат в UTF-8. BIN сохраняет фактически закодированные или прочитанные байты.

Текст в двоичный код помогает сопоставить строку с данными из журнала или сетевого сообщения. Кириллица, акценты и эмодзи могут занимать несколько байтов, поэтому номер символа нельзя подставлять вместо его кодированной последовательности. Выберите кодировку источника: успешное декодирование подтверждает допустимость байтов, но не доказывает, что получен исходный текст.

Текст в двоичный код с проверкой байтов

Увидеть реальный размер символа

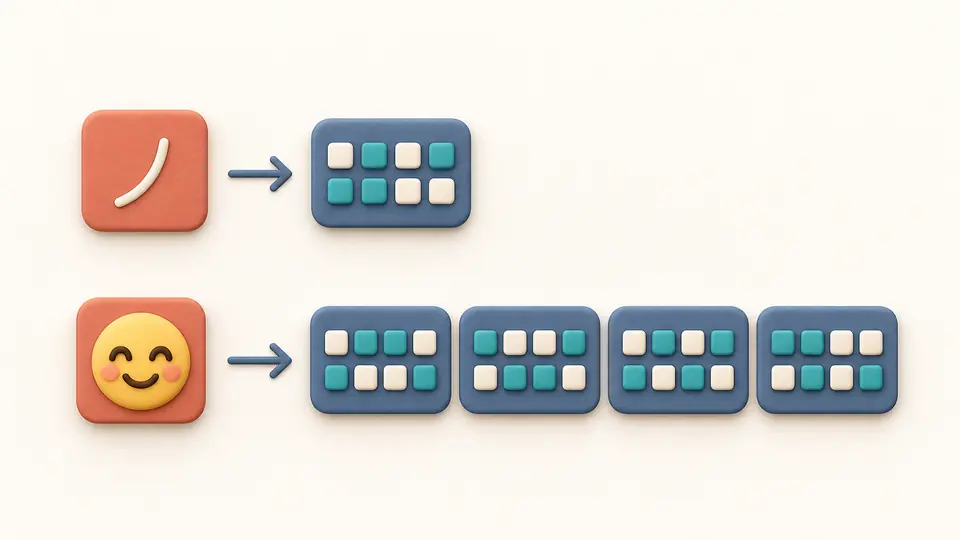
Текст в двоичный код сначала кодирует полную строку Unicode, а затем показывает каждый байт. В UTF-8 буква A занимает один байт, é — два, 中 — три, 😀 — четыре. В UTF-16 LE и BE два байта каждой 16-битной единицы меняются местами; эмодзи вне основного плана по-прежнему нужна суррогатная пара из двух единиц.

Простой символ связан с одной ячейкой байта, а сложный разворачивается в несколько одинаковых ячеек.

Остановиться на повреждённой группе

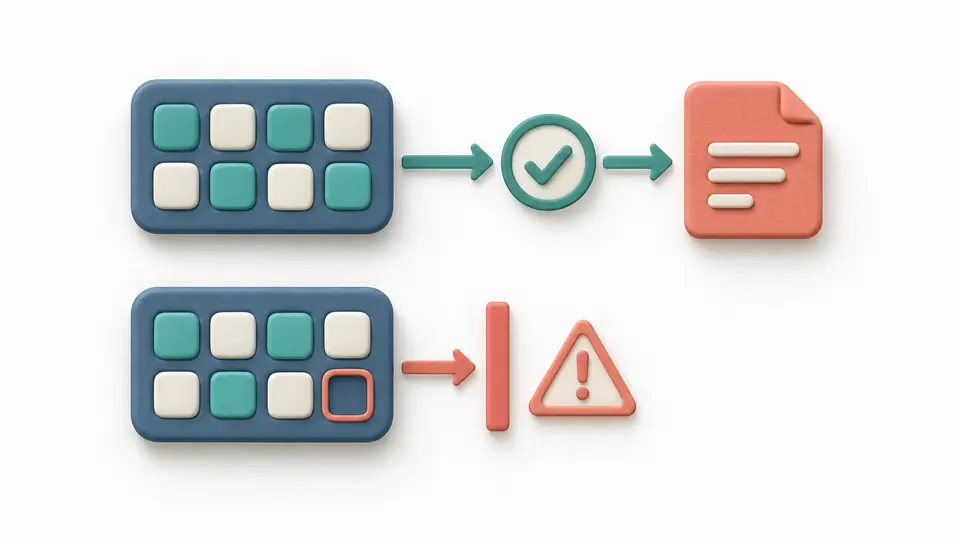
Группа из семи битов не дополняется нулём. Недопустимая последовательность UTF тоже останавливает всё преобразование. Ввод остаётся на месте, а сообщение указывает строку и столбец. Так в скопированный результат не попадает текст, из которого незаметно исчезли символы.

Полные группы проходят проверку, а неполная группа останавливается и выделяется.

Проверить интерпретацию перед сохранением

01

Выбрать формат отдельно от кодировки

Чтобы перевести двоичный код в текст, выберите двоичный формат; для записи Hex — шестнадцатеричный. Затем укажите кодировку источника и явно выберите LE или BE для UTF-16. Переключение направления не переносит данные. Обратить результат предлагает замену ввода через предпросмотр.

02

Управлять моментом пересчёта

Автоматическое преобразование ждёт 350 мс после изменения. Отключите его для кнопки преобразования или Ctrl/Cmd + Enter. Любая правка ввода или параметров сразу запрещает экспорт старого результата. Разделитель и регистр Hex действуют только при выводе байтов из текста.

03

Сохранить нужное содержимое

TXT содержит отображаемую запись в UTF-8, BIN — реальные байты. Пример, очистка и обращение показывают объём замены до применения. Затем можно один раз вернуть прежнее состояние вместе с вводом, параметрами и результатом.

Что сохраняется при смене представления

Unicode без нормализации

Комбинируемые акценты остаются в исходной форме: нормализация NFC не выполняется. Кириллица и эмодзи не пропускаются как символы вне ASCII. Число кодовых точек не равно числу видимых знаков: составной эмодзи может содержать несколько точек и множество байтов.

Фиксированная ширина и ведущие нули

Каждый байт занимает восемь двоичных или две шестнадцатеричные цифры. Пробел, отсутствие разделителя, перенос строки и запятая меняют только запись. Декодирование принимает оба регистра Hex и пробелы ASCII, табуляцию, CR, LF и запятые между целыми байтами.

Диагностика по исходному вводу

Ошибочные цифры, неполные байты, неверные байты продолжения UTF-8 и повреждённые пары UTF-16 отклоняются. Номер байта связан с позицией в исходной строке. Правильно закодированный U+FFFD сохраняется; для сокрытия ошибок этот символ никогда не вставляется.

Постепенный просмотр полного результата

При кодировании сначала показываются 100 байтов, при декодировании — 100 кодовых точек. Можно добавлять по 100 элементов, не разрывая байты или суррогатные пары. Копирование и оба вида загрузки всегда используют весь актуальный результат, включая скрытую часть.

Допустимый ввод и границы задачи

Только целые байты
0100 0001 не объединяется в один байт. Префиксы 0x и 0b, обратные слеши с escape-последовательностями, скобки, адреса и текстовые столбцы дампа нужно убрать заранее. Неизвестные символы не фильтруются автоматически, короткие группы не дополняются.
Три явные кодировки
Поддерживаются UTF-8, UTF-16LE и UTF-16BE. Нет автоопределения, UTF-16 без выбранного порядка, отдельного режима ASCII, GBK, Shift_JIS или EUC-KR. При неверной кодировке иногда получается допустимый, но другой текст; проверяйте настройки источника.
Содержимое не очищается
Пробелы текста, NUL, переводы строк, комбинируемые знаки и U+FEFF сохраняются. BOM не добавляется и не удаляется, а его наличие не меняет выбранный порядок байтов. Изменения, сделанные системой или буфером обмена до вставки, здесь восстановить нельзя.
Превышение лимита вызывает ошибку
Текст и декодированный результат ограничены 65 536 единицами UTF-16. Запись байтов — 2 097 152 символами и 196 608 байтами; вывод — 2 097 152 символами. Превышение останавливает операцию без усечения. Импорт файлов, загрузка URL и пакетная обработка не предусмотрены.
Файл TXT всегда использует UTF-8
Даже при выбранном UTF-16 файл TXT сохраняет видимое представление в UTF-8. Для точных байтов UTF-16 нужен BIN. Инструмент не разбирает формат изображений, архивов или исполняемых файлов и не перезаписывает исходные файлы.
Не вычисление целых чисел и не шифрование
42 означает символы 4 и 2. Перевод целого числа 42, дополнительный код отрицательных чисел, плавающая точка, десятичный и восьмеричный вывод, Base64 и escape-записи кодовых точек относятся к другим задачам. Двоичная запись не обеспечивает секретность сообщения.

Текст в двоичный код: частые вопросы

Как текст превращается в двоичные байты?

Сначала строка кодируется в выбранном UTF, затем каждый полученный байт записывается восемью битами. Например, A в UTF-8 даёт 01000001, а кириллица обычно требует больше одного байта. Это последовательность байтов, а не двоичная запись номера кодовой точки.

Откуда у одного эмодзи несколько групп битов?

Одна группа показывает один байт, не один видимый знак. 😀 в UTF-8 состоит из F0 9F 98 80, то есть четырёх байтов. В UTF-16 он тоже занимает четыре байта в паре единиц. Составные эмодзи могут включать несколько кодовых точек и быть ещё длиннее.

Можно ли восстановить текст из двоичного кода и HEX?

Да. Выберите Байты → текст и нужный двоичный либо Hex-формат, затем исходную кодировку. Для текущего результата можно применить обращение после просмотра замены. Поток должен состоять из целых байтов и быть допустимым в выбранном UTF.

Обязательны ли пробелы между байтами?

Нет. Непрерывная строка 0100000101000010 образует два байта и декодируется как AB в UTF-8. Допускаются также пробелы, табуляция, переносы строк и запятые между байтами. Разделять одну восьмибитную группу на две части нельзя.

Почему неполная группа битов вызывает ошибку?

Байт всегда содержит восемь битов. Семь битов не определяют, где именно пропущен восьмой, поэтому автоматическое дополнение могло бы изменить данные. Инструмент показывает ошибку в исходном месте и не добавляет нули, не удаляет остаток и не выдаёт частичный результат.

Остался вопрос?

Проверить настоящую последовательность байтов

Текст в двоичный код позволяет сравнить одну строку в UTF-8 и обоих порядках UTF-16. Проверьте число байтов и выберите представление, которое требуется следующему инструменту.

В байте всегда восемь битов; для символа может потребоваться несколько байтов.