Кодирование и экранирование

Base64 декодери кодирование текста UTF-8

Преобразуйте одно текстовое значение, явно выбрав алфавит и заполнение.

Base64 декодер

Входные данные

Результат

Преобразование выполняется в браузере; введённые данные не отправляются.

Параметры кодирования

Только UTF-8. Заполнение должно быть полным либо отсутствовать; ненулевые неиспользуемые биты запрещены. Алфавит проверяется строго. Недопустимые байты UTF-8 вызывают ошибку.

Вход: 1 000 000 единиц UTF-16; выход: 4 000 000. Пустой ввод допустим. При вставке окончания строк могут нормализоваться.

Введите текст или загрузите пример. Пустой ввод преобразуется в пустой результат.

После подтверждения актуальный результат заменит ввод, а направление изменится. Действие недоступно, если результат превышает лимит входных данных.

Base64 декодер помогает прочитать значение из настройки или ответа API, проверяя не только символы кодировки, но и полученные байты UTF-8. Повреждённые данные вызывают ошибку: вместо них не появятся символы замены или обрывок текста.

Здесь можно также кодировать Base64 онлайн: текст сначала превращается в байты UTF-8, затем в символы выбранного алфавита. Направление, алфавит и заполнение задаются отдельно. При открытии поля пусты; пример загружается по кнопке.

Что проверяет Base64 декодер

Верните текст из его представления

Base64 декодер обрабатывает байты UTF-8, поэтому кириллица и эмодзи не требуют отдельного однобайтового режима. Закодируйте короткий текст и обратите результат, чтобы прочитать исходное значение перед передачей в другой сервис.

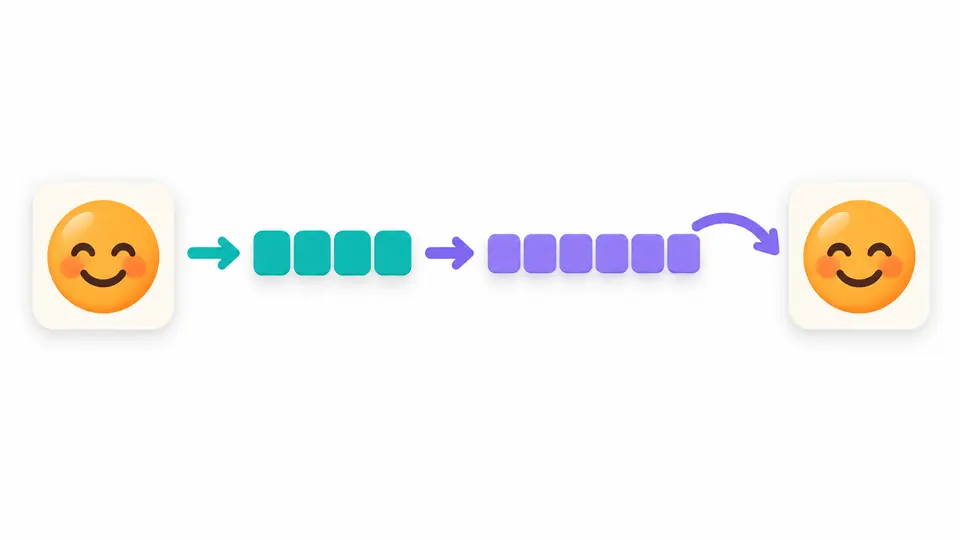
Эмодзи превращается в блоки байтов и закодированную последовательность, затем возвращается в исходный вид.

Отделите правильные символы от правильных байтов

Строка может соответствовать алфавиту Base64, но содержать недопустимый UTF-8. Такой результат отклоняется без подстановки символов замены. Проверки заполнения и неиспользуемых битов выполняются отдельно, чтобы причина ошибки оставалась понятной.

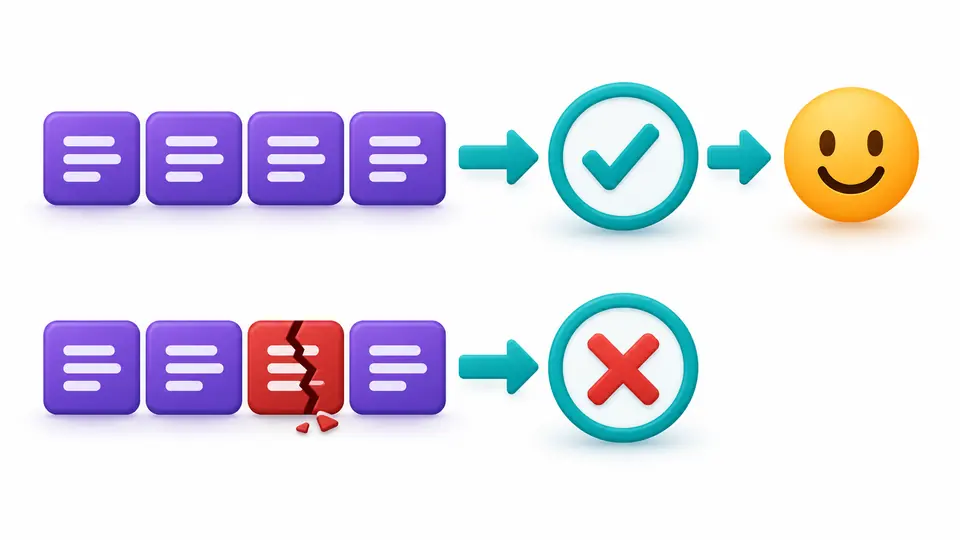
Правильная последовательность проходит проверку, а повреждённая останавливается у красной отметки отказа.

Уточните формат перед преобразованием

01

Выберите алфавит и заполнение отдельно

Стандартный алфавит использует + и /, Base64URL — - и _. Сохранение = при кодировании задаётся отдельным переключателем. При декодировании алфавит не угадывается; заполнение должно быть точным или полностью отсутствовать.

02

Следите за актуальностью результата

Автоматический режим ждёт 350 мс после изменения. Отключите его для запуска кнопкой или Ctrl/Cmd+Enter. Изменение направления или параметров сохраняет ввод без предпросмотра, но делает результат устаревшим и отключает экспорт до пересчёта.

03

Проверьте замену перед применением

Пример, Очистить и Обратить результат показывают предпросмотр и длины в UTF-16. Применить заменяет ввод; Вернуть восстанавливает одну версию данных, параметров и результата. Длинные значения видны до 20 000 единиц, а экспорт включает их полностью.

Явные правила в обоих направлениях

Unicode без нормализации

Кириллица, диакритика, комбинируемые символы и эмодзи кодируются через UTF-8. Начальный U+FEFF остаётся частью значения; новый BOM при кодировании не добавляется. Состав Unicode-последовательностей не нормализуется.

Два алфавита RFC 4648

Base64URL меняет два знака пунктуации, не навязывая выбор заполнения. Стандартный режим отклоняет - и _, а URL-safe отклоняет + и /. Смешанные алфавиты не исправляются автоматически.

Положение ошибки, когда оно известно

Для запрещённых символов, неверного заполнения и одиночных суррогатов указываются строка и столбец UTF-16 исходного ввода. Ошибка полученного UTF-8 не снабжается выдуманной позицией: этап декодирования байтов её не предоставляет.

Только четыре вида пробелов

Можно разрешить пропуск обычного пробела, табуляции, возврата каретки и перевода строки. При отключённой настройке они тоже запрещены. Статус показывает число удалённых единиц; прочие посторонние символы не вычищаются.

Границы текстового преобразования

Одно значение UTF-8 без импорта файлов
Base64 декодер преобразует Base64 в текст, а в обратном направлении принимает текст UTF-8. Импорта файлов, изображений, URL и Data URI, а также скачивания бинарных данных нет. Кодировка не определяется автоматически; Latin-1 не поддерживается. Заголовки нужно удалять самостоятельно.
Заполнение целиком или без него
Zg== и Zg дают f. Zg= вызывает ошибку, как и = посередине, лишние = или длина данных с остатком 1 при делении на 4. Переключатель заполнения влияет на кодирование; декодирование всегда следует этому правилу.
Канонические завершающие биты
Zh== отклоняется, хотя более терпимый декодер может вернуть f. Этот инструмент требует нулевых неиспользуемых битов. RFC 4648 разрешает декодерам выбирать такую политику, но не обязывает все реализации отклонять подобные варианты.
Без исправления повреждённых данных
/w== корректен как Base64, но не как текст UTF-8, поэтому декодирование завершается ошибкой. Одиночные суррогаты UTF-16 также не кодируются. Начальные BOM после декодирования сохраняются, в том числе повторные. Нормализации и частичного текста нет.
Пробелы в тексте являются содержимым
В закодированной строке можно игнорировать только SP, TAB, CR и LF. NBSP, вертикальная табуляция, перевод страницы и вставленный BOM запрещены. При кодировании пробелы и окончания строк входят в текст. Движок сохраняет CRLF, но вставка в редактор может нормализовать окончания строк.
Лимиты без обрезанного экспорта
Вход ограничен 1 000 000 единиц UTF-16 до удаления пробелов, выход — 4 000 000. При превышении всё преобразование завершается ошибкой. Пустое значение допустимо. Нет MIME-обёрток, построчных пакетов, шифрования, проверки JWT и сохранения черновиков.

Base64 декодер: вопросы и ответы

Как декодировать строку Base64 онлайн?

Выберите декодирование, вставьте строку без заголовков и задайте её алфавит. Base64 декодер обработает значение автоматически; в ручном режиме нажмите Преобразовать. Исправьте ошибки перед копированием или скачиванием TXT. Данные обрабатываются в браузере.

Какие варианты Base64 поддерживает декодер?

Стандартный алфавит с + и / и Base64URL с - и _. Выбирайте вариант явно: символы другого алфавита вызывают ошибку. Наличие заполнения = — отдельное условие, не определяемое одним лишь выбором URL-safe.

Можно ли декодировать Base64 без заполнения?

Да, если заполнение отсутствует целиком и данные имеют допустимую длину и завершающие биты. Zg и Zg== дают одинаковое f, но Zg= отклоняется как частично заполненное значение. При необходимости разрешите пропуск только пробела, TAB, CR и LF.

Можно ли кодировать PDF и изображения?

Эта страница принимает текст UTF-8, а не файлы. Для PDF и изображений нужен инструмент, работающий с исходными байтами и бинарным результатом. Base64 от такого файла может пройти проверку алфавита, но не проверку текста UTF-8.

Поддерживаются ли кириллица и эмодзи?

Да: текст сначала представляется байтами UTF-8, поэтому кириллица и дополнительные символы Unicode поддерживаются. При обратном преобразовании байты должны быть допустимым UTF-8. Одиночные суррогаты UTF-16 не подменяются другим символом, а вызывают ошибку кодирования.

Нашли особый случай кодирования?

Base64 декодер готов к проверке

Используйте Base64 декодер с коротким примером, уточните алфавит и заполнение, затем выполните обратное преобразование и проверьте текст UTF-8.