Encodage et échappement

Encodeur Base64et décodage UTF-8 strict

Convertissez une valeur texte en choisissant explicitement alphabet et remplissage.

Encodeur Base64

Entrée

Résultat

La conversion reste dans ce navigateur ; votre saisie n’est pas envoyée.

Options d’encodage

UTF-8 uniquement. Le décodage accepte un remplissage complet ou absent et refuse les bits inutilisés non nuls. L’alphabet choisi est strictement vérifié ; les octets UTF-8 invalides provoquent une erreur.

Entrée : 1 000 000 d’unités UTF-16 ; sortie : 4 000 000. Une entrée vide est valide. Le collage peut normaliser les fins de ligne.

Saisissez du texte ou chargez un exemple. Une entrée vide donne une sortie vide.

Après validation, le résultat à jour remplace la saisie et le sens s’inverse. Cette action est indisponible si le résultat dépasse la limite d’entrée.

Un accent abîmé après conversion signale souvent une confusion entre caractères et octets. Cet Encodeur Base64 transforme d’abord votre texte en octets UTF-8 : les accents, les écritures non latines et les emoji suivent ainsi le même parcours.

Pour lire une valeur de configuration, utilisez le décodeur Base64 et choisissez son alphabet. Il contrôle la structure avant de vérifier les octets UTF-8 ; un résultat illisible ne devient pas silencieusement un texte rempli de caractères de remplacement.

Pourquoi choisir cet Encodeur Base64 ?

Vérifier le parcours des accents et emoji

L’Encodeur Base64 passe par UTF-8 avant de produire les symboles ASCII. Pour contrôler une valeur avant de la transmettre, inversez le résultat courant : vous pourrez relire le texte qu’il représente. Aucun caractère supplémentaire ne devient une erreur simplement parce qu’il occupe plusieurs octets.

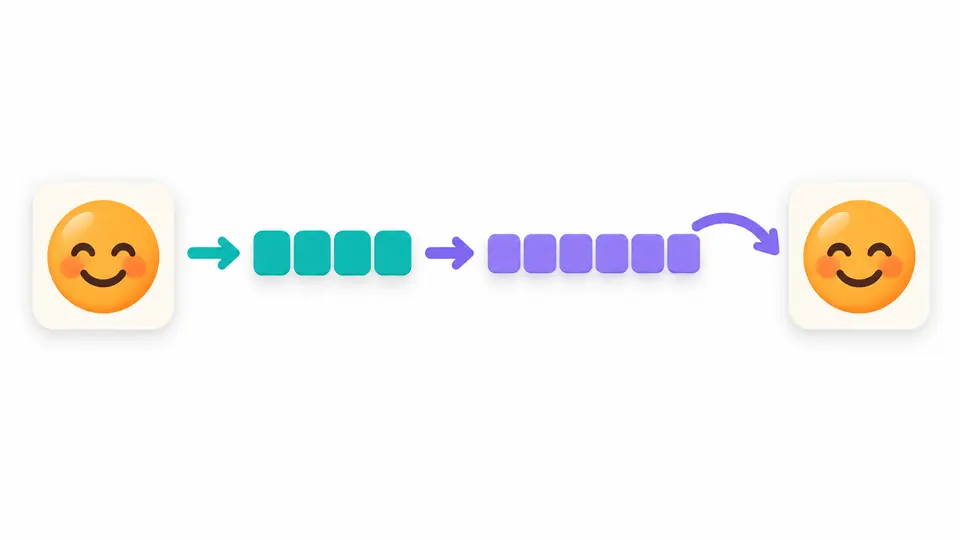
Un emoji devient des blocs d’octets puis une séquence encodée, avant de retrouver sa forme initiale.

Distinguer un alphabet correct d’un texte valide

Une suite peut respecter l’alphabet Base64 tout en contenant des octets incompatibles avec UTF-8. Le décodage s’arrête alors sans produire de texte partiel. Le remplissage et les bits inutilisés sont contrôlés séparément, ce qui permet de comprendre à quelle étape la valeur a été refusée.

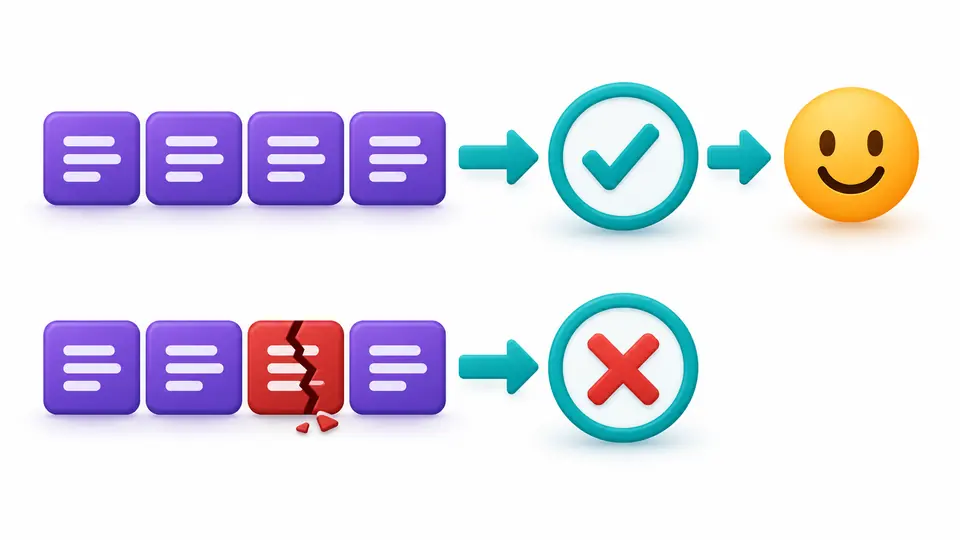
Une séquence valide franchit le contrôle, tandis qu’une séquence endommagée est arrêtée par un repère rouge.

Préparer la valeur pour son destinataire

01

Choisir deux réglages indépendants

Base64 standard emploie + et / ; Base64 URL-safe emploie - et _. Le remplissage = reste un choix distinct pour l’encodage. Le décodeur ne devine pas l’alphabet ; il accepte un remplissage exact ou entièrement omis.

02

Savoir quand le résultat est à jour

La conversion automatique attend 350 ms après modification. Désactivez-la pour utiliser Convertir ou Ctrl/Cmd+Entrée. Changer le sens ou une option ne remplace pas le texte : cela périme le résultat et désactive l’export jusqu’au prochain calcul.

03

Relire avant de remplacer la saisie

Exemple, Effacer et Inverser affichent un aperçu avant application. Rétablir restaure une version des données, options et résultat. L’aperçu des longues valeurs s’arrête à 20 000 unités UTF-16 ; copie et téléchargement conservent le résultat complet.

Des conventions visibles dans les deux sens

Unicode sans normalisation

Vous pouvez encoder en Base64 des accents, caractères combinés et emoji. Le texte passe par UTF-8 sans normalisation Unicode. Un U+FEFF initial reste dans la valeur ; l’encodage n’ajoute pas de nouveau BOM.

Deux alphabets RFC 4648

Le choix Base64URL modifie les deux signes de ponctuation, sans imposer la présence ou l’absence de remplissage. Chaque décodeur refuse les signes réservés à l’autre alphabet : mélanger les deux variantes ne passe pas inaperçu.

Une position quand elle est connue

Un caractère interdit, un remplissage incorrect ou un substitut isolé peut être signalé par ligne et colonne UTF-16 dans la saisie originale. Une erreur sur les octets UTF-8 décodés n’affiche pas de position inventée : cette étape ne fournit pas cet emplacement.

Quatre blancs autorisés sur demande

Le décodage peut ignorer seulement espace, tabulation, retour chariot et saut de ligne. Désactivez cette option pour les refuser aussi. Le statut indique combien d’unités de blanc ont été retirées ; les autres caractères ne sont pas nettoyés.

Ce que le traitement accepte

Une valeur texte, sans import de fichier
Cet Encodeur Base64 travaille sur du texte UTF-8. Il n’importe ni PDF, image, fichier, URL ni Data URI et ne propose pas de téléchargement binaire. Il ne détecte pas les jeux de caractères et ne prend pas en charge Latin-1. Les en-têtes doivent être retirés explicitement.
Remplissage exact ou absent
Zg== et Zg donnent tous deux f. Zg= échoue, tout comme un = au milieu, un excès de = ou une longueur de données congrue à 1 modulo 4. Le réglage de remplissage concerne l’encodage ; le décodage suit toujours cette règle.
Bits finaux canoniques
Zh== est refusé même si un décodeur permissif peut renvoyer f. Cet outil exige des bits inutilisés nuls. La RFC 4648 autorise les décodeurs à adopter ce contrôle ; elle ne leur impose pas à tous de rejeter ces variantes.
Aucune réparation silencieuse
/w== est une séquence Base64 valide, mais ses octets ne forment pas du texte UTF-8. Elle échoue donc au décodage. Les substituts UTF-16 isolés échouent à l’encodage. Les BOM initiaux décodés sont conservés, même répétés, sans normalisation.
Blancs et fins de ligne ne sont pas interchangeables
Seuls SP, TAB, CR et LF peuvent être ignorés dans le Base64. Espace insécable, tabulation verticale, saut de page et BOM collé sont refusés. À l’encodage, les espaces et fins de ligne font partie du texte. Le moteur conserve CRLF, mais le collage dans l’éditeur peut normaliser ces fins de ligne.
Des limites sans résultat tronqué
Maximum : 1 000 000 d’unités UTF-16 en entrée, avant retrait des blancs, et 4 000 000 en sortie. Une valeur trop grande échoue entièrement ; le texte vide est valide. Pas d’habillage MIME, de lots par ligne, de chiffrement, de vérification JWT ni de stockage de brouillon.

Questions sur l’Encodeur Base64

Pourquoi certains encodeurs Base64 cassent-ils les accents ?

Certains traitent directement les caractères comme des octets ou utilisent un autre jeu de caractères. L’Encodeur Base64 convertit d’abord le texte en UTF-8. Au retour, il exige du UTF-8 valide au lieu de remplacer silencieusement les octets incorrects.

Quelles variantes de Base64 ce décodeur prend-il en charge ?

Les alphabets standard et Base64URL sont proposés. Choisissez celui de votre valeur : + et / pour le standard, - et _ pour la variante URL-safe. Le décodeur refuse les signes de l’autre alphabet et ne détecte pas automatiquement le format.

Base64 avec ou sans caractères de remplissage : quelle différence ?

Les = complètent le dernier groupe de quatre symboles lorsque nécessaire. Leur présence dépend du protocole destinataire et ne change pas les octets représentés lorsqu’ils sont corrects. Ici, vous pouvez les omettre à l’encodage ; au décodage, le remplissage doit être complet ou entièrement absent.

Peut-on convertir un PDF ou une image ?

Pas sur cette page, consacrée à un texte UTF-8. Les fichiers binaires nécessitent un outil acceptant leurs octets et un export binaire. Coller leur Base64 ici peut échouer si les octets décodés ne constituent pas un texte UTF-8 valide.

Le texte saisi quitte-t-il mon appareil ?

La conversion s’effectue dans ce navigateur et la saisie n’est pas envoyée pour être traitée. La copie utilise votre presse-papiers ; le téléchargement crée un fichier texte local. Aucun brouillon n’est enregistré par cet outil.

Un cas d’encodage à signaler ?

Revenir à l’Encodeur Base64

Essayez l’Encodeur Base64 sur un court texte accentué, vérifiez les conventions du destinataire, puis inversez le résultat pour contrôler le texte UTF-8.