01
字母表与填充分开选择
标准格式使用 + 和 /,Base64URL 使用 - 和 _。选择后再决定是否保留 =,两项互不绑定。解码不会猜测字母表;同一输入必须符合当前选择。
编码与转义
选择方向、字母表与填充规则,转换一个 UTF-8 文本值。
转换仅在当前浏览器内进行,输入不会上传。
仅处理 UTF-8。解码允许完整填充或全部省略,拒绝非零填充位;严格检查所选字母表,无效 UTF-8 字节会报错。
输入上限为 1,000,000 个 UTF-16 码元,输出上限为 4,000,000 个。空输入有效;粘贴可能改变换行形式。
输入文本或载入示例。空输入会转换为空结果。
确认后,将最新结果作为输入并切换方向。结果超过输入上限时,此操作不可用。
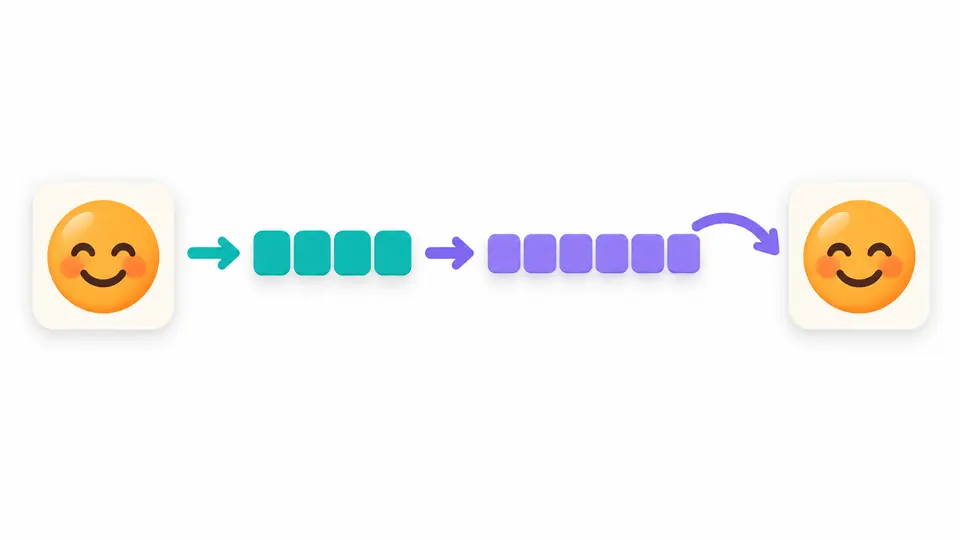
接口要求一段 ASCII 字符,但原文含有中文或表情符号时,可以使用 Base64 编码。这里先把文本转换为 UTF-8 字节,再用选定字母表表示这些字节;汉字与英文长度不同,不应拿字数估算编码后的大小。
检查配置里的编码值时,能看到文字并不等于输入正确。这个 Base64 在线转换工作台先检查字符与末尾结构,再检查字节能否构成 UTF-8;不会把损坏的数据悄悄替换为问号或替代字符。
粘贴“你好”与表情符号时,Base64 编码会先处理多字节文本。得到结果后可预览反向替换,再检查还原的内容,避免直接把面向单字节字符的做法套在中文上。
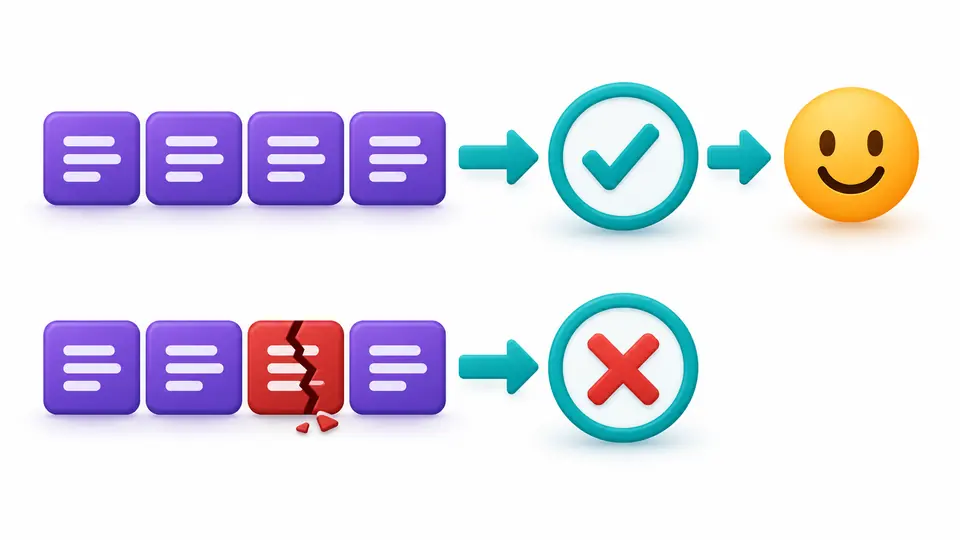
某段内容可能每个字符都在字母表里,却不能还原成 UTF-8 文本。本工具区分这两类问题:前者检查填充与字符,后者拒绝无效字节,帮助判断该修正编码文本还是另找原始字符集。
标准格式使用 + 和 /,Base64URL 使用 - 和 _。选择后再决定是否保留 =,两项互不绑定。解码不会猜测字母表;同一输入必须符合当前选择。
自动转换默认在停止修改约 350 毫秒后执行。关闭开关会显示转换按钮,也可按 Ctrl/Cmd+Enter。输入或选项一变,旧结果立即禁止导出,避免复制到上一版内容。
示例、清空和反向转换都会先显示预览及码元数量。应用才改写输入,撤销可恢复一次输入、选项和结果。长结果只预览前 20,000 个码元,复制与下载仍包含全量。
UTF-8 支持中文、重音字母和表情符号,也保留组合字符的原有顺序。编码不做 Unicode 规范化,不新增 BOM;已有的 U+FEFF 属于输入内容。
标准解码拒绝 - 和 _,URL 安全解码拒绝 + 和 /。两种格式都能独立控制编码填充,便于遵循接口要求,而不是看到 URL-safe 就自动删除等号。
非法字符、填充问题及孤立代理码元会标明原始输入的行和 UTF-16 列。无效 UTF-8 字节只说明错误类型,不编造一个无法确认的文本位置。
Base64 解码可忽略普通空格、制表符、回车与换行;结果会报告实际忽略的数量。关闭后,这些字符也必须删除才能解码,便于检查要求连续字符串的协议。
支持有效的 Unicode 文本。Base64 编码通过 UTF-8 字节处理中文和表情符号,因此不局限于单字节字符。孤立的 UTF-16 代理码元属于损坏文本,会被拒绝,不会静默替换。
也称 Base64URL,它把标准字母表中的 + 和 / 换成 - 和 _。是否需要末尾等号取决于接收协议,本工具将两项设置分开;选择 URL 安全模式不会自动取消填充。
原始字节数不是 3 的倍数时,标准输出用一个或两个 = 补齐最后一组。部分协议允许省略;这里能编码成两种形式,也能解码完整填充或全无填充的值,但不接受只删掉一部分等号。
本页只处理文本,不能把二进制文件拖进来转换。文件内容即便已经是合法 Base64,也未必是 UTF-8;这种输入会报字节错误,应使用专门处理文件与二进制数据的工具。
先确认数据确实是 UTF-8,再检查所选字母表、等号与夹杂字符。其他字符集、压缩包或加密字节无法直接还原为这里的文本。本工具会报错,不会用替代字符生成一份看似成功的结果。
遇到了未说明的编码边界?