Кодирование и экранирование

Кодировщик Base32и Base16 / 58 / 85

Укажите представление байтов и алфавит, который использует источник данных.

Кодировщик Base32

Входные данные

Преобразование выполняется в браузере; введённые данные не отправляются.

Результат

Параметры кодирования

Текст UTF-8, пары hex или десятичные байты 0–255 через пробелы. Без префикса 0x, запятых и скобок массива.

Base32 требует верхний регистр. Base58 не проверяет контрольную сумму. Z85 требует группы по 4 байта / 5 символов.

Ввод: 65 536 единиц UTF-16; 1 000 физических строк. На значение: 65 536 байт; Base58: 4 096 байт / 5 600 символов. Отчёт: 2 000 000 символов; время: 2 секунды.

Введите текст или загрузите пример. Пустой ввод преобразуется в пустой результат.

Кодировщик Base32 помогает выяснить, почему значение не совпадает между библиотеками. Сначала проверьте смысл ввода: 41 как текст содержит два байта, а 41 как hex — один байт буквы A. Только затем выбирается алфавит, представляющий эти байты символами.

Здесь доступны кодирование Base32 и декодирование Base32, а также Base16, Base58 и три варианта Base85. Кириллица и эмодзи обрабатываются через UTF-8. Двоичные данные можно вводить и проверять в hex или десятичном виде, не превращая их в текст.

Кодировщик Base32 с явным выбором формата

Алфавит сохраняется вместе с результатом

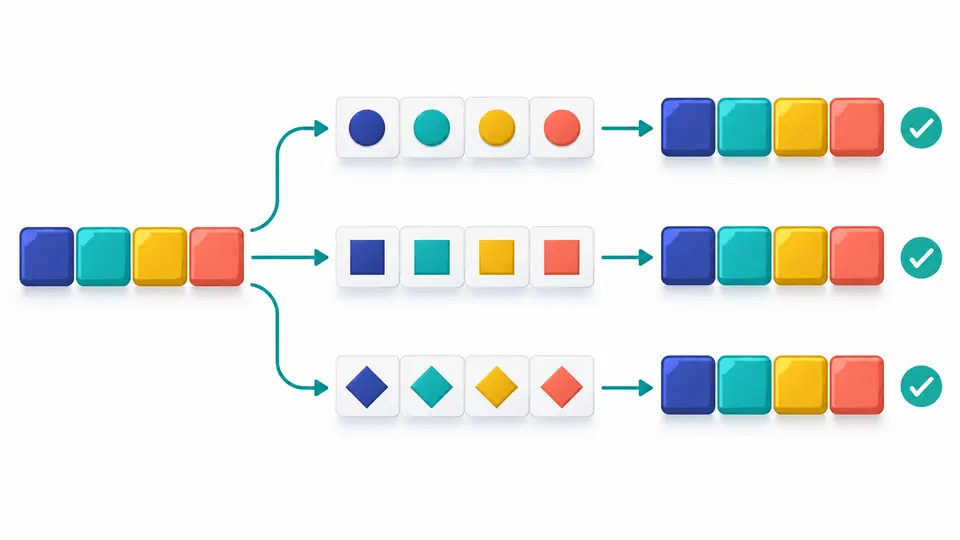
Кодировщик Base32 разделяет RFC 4648 и base32hex. Bitcoin и Flickr, а также Ascii85, Git b85 и Z85 имеют отдельные варианты. Отчёт включает настройки, чтобы получатель мог повторить преобразование без догадок о происхождении строки.

Одинаковые байты проходят через разные последовательности символов и восстанавливаются без изменений.

Ошибка не теряется среди строк

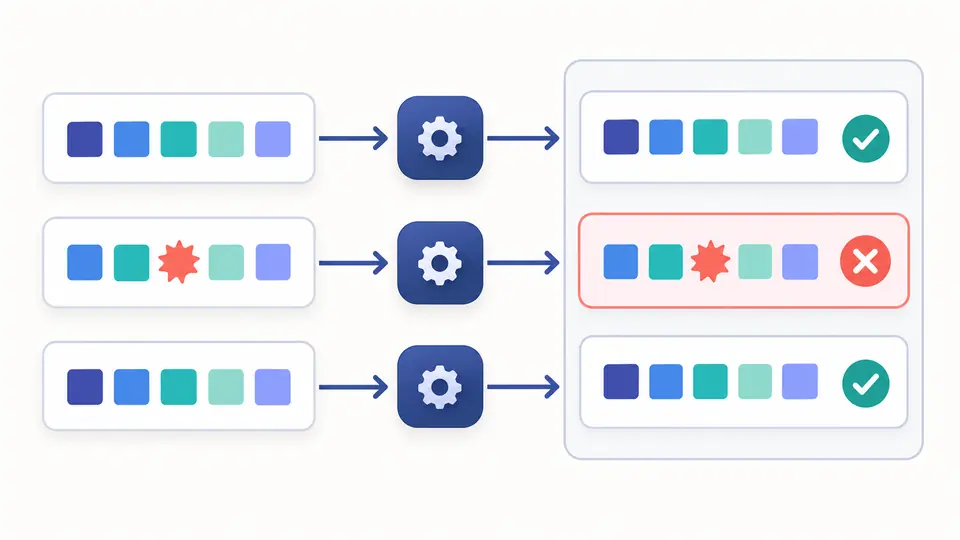
Недопустимый символ в одной строке не удаляет остальные результаты. Каждая запись сохраняет исходный номер строки и ошибку. Переносы внутри декодированного значения остаются в строке JSON и не превращаются в дополнительные записи отчёта.

Три независимые строки дают два успешных результата и видимую ошибку в средней строке.

Проверьте представление и размер групп

01

Отличайте число в тексте от байтов

Для hex нужны полные пары цифр. Десятичные байты — значения 0–255, разделённые ASCII-пробелами. Запятые, скобки массива и префиксы 0x не удаляются автоматически. Одно большое целое не является списком байтов.

02

Повторите правила источника

Дополнение Base32 влияет только на кодирование. Маркеры Adobe для Ascii85 не относятся к Git b85. Z85 требует групп по четыре байта и не дополняет их нулями. Пример подбирается под текущий формат и направление.

03

Сверьте байты перед обратным действием

Откройте сведения, чтобы сравнить hex и десятичные значения. Без автоматического режима работает Ctrl/Cmd + Enter. Обратное действие сначала показывает замену ввода; отмена восстанавливает и параметры, и прежний результат.

Восемь вариантов с проверкой байтов

Base16 и два алфавита Base32

Base16 выводит две заглавные шестнадцатеричные цифры на байт и принимает нижний регистр при декодировании. Base32 использует A–Z и 2–7, base32hex — 0–9 и A–V. Это разные алфавиты, а не два названия шестнадцатеричного ввода.

Base58 сохраняет начальные нули

Bitcoin и Flickr используют одинаковый набор символов в разном порядке. Каждый начальный нулевой байт сохраняется как начальная 1. Простое преобразование числовой величины потеряло бы эти байты; здесь сохраняется исходная последовательность.

Три самостоятельных формата Base85

Ascii85 поддерживает z для полного нулевого блока и необязательные маркеры Adobe. Git b85 применяет алфавит RFC 1924 к четырёхбайтовым блокам. Z85 использует алфавит ZeroMQ и полные группы. Сходство символов ещё не означает одинаковый результат.

Строгий UTF-8 и двоичная диагностика

После преобразования доступны число байтов, hex и десятичные значения. Некорректный UTF-8 не заменяется молча специальным символом. Уже полученные байты остаются доступными, даже если вывести их как текст нельзя.

Допустимые формы и границы обработки

Нет автоматического исправления
Base32 принимает только верхний регистр и не заменяет O/0 или I/1. Дополнение должно быть точным либо отсутствовать, неиспользуемые биты — нулевыми. При декодировании можно игнорировать только ASCII-пробел, TAB, CR и LF; при кодировании текста они являются данными.
Нет проверки адресов и коротких ссылок
Base58Check, сетевые префиксы, WIF и адреса кошельков не создаются и не проверяются. Алфавит Flickr не вычисляет короткую ссылку по ID фотографии. Пользовательские алфавиты, Crockford, Ripple и произвольные системы счисления не поддерживаются.
Расширения Base85 не смешиваются
Ascii85 принимает сырые данные или полную пару <~ ~>, но не сокращение y из btoa и не PDF. Git b85 отличается от исходного кодирования целого IPv6 в RFC 1924. Z85 не добавляет и не удаляет нули. Группа, превышающая 32 бита, отклоняется.
Пакет разделяется физическими строками
CR, LF и CRLF разделяют записи. Полностью пустые строки пропускаются, значения из пробелов сохраняются. Ошибки входят в JSON. В одиночном режиме переносы являются данными; пакетный отчёт нельзя напрямую подставить обратным действием.
Ограничены ввод и время выполнения
Ввод — до 65 536 единиц UTF-16, пакет — до 1 000 физических строк, включая пустые. Одно значение — до 65 536 байт, Base58 — до 4 096 байт или 5 600 символов. Отчёт свыше 2 000 000 символов или работа дольше двух секунд приводит к отказу всей задачи.
Текст только в UTF-8
Нет загрузки файлов, чтения URL, извлечения PDF или определения другой кодировки. Корректные BOM и комбинируемые символы сохраняются. Просмотр ограничен 20 000 символов на значение и порциями по 50 строк; экспорт содержит полный актуальный результат.

Кодировщик Base32: вопросы и ответы

Почему при декодировании Base32 возникает ошибка дополнения?

MY====== и MY обозначают f, а MY= содержит неполное дополнение. Используйте точное количество знаков либо уберите их все. Проверяются и неиспользуемые биты. Уточните, не использует ли источник base32hex или Crockford вместо стандартного Base32.

Как правильно обрабатывать кириллицу и другие не-ASCII-символы в Base32?

Сначала символы преобразуются в байты UTF-8, затем кодируются. Кириллица, эмодзи и комбинируемые символы сохраняются без нормализации. Если исходные байты не являются UTF-8, выбирайте hex или десятичный вывод вместо текста.

Чем различаются Ascii85, Base85 и Z85?

У них разные алфавиты, маркеры и обработка коротких конечных групп. Ascii85 использует !–u, Git b85 соответствует блоковому формату Python b85encode, Z85 применяется в ZeroMQ. Сокращение z и маркеры Adobe нельзя переносить на другие варианты.

Как Base58 сохраняет нулевые байты в начале?

Каждый начальный нулевой байт даёт начальную 1 в обоих поддерживаемых алфавитах. Например, 00 00 01 превращается в 112. Инструмент сохраняет байтовую последовательность; преобразование только числовой величины потеряло бы начальные нули.

Можно ли автоматически распознать Base85 или Ascii85?

Надёжно — нет. Алфавиты пересекаются, поэтому несколько декодеров могут принять одну строку и получить разные байты. Выберите формат, указанный в исходном протоколе или библиотеке, и проверьте известный пример.

Как кодировать или декодировать адрес с помощью Base58Check?

Base58Check добавляет сведения о версии и контрольную сумму к байтам. Эта страница преобразует только сырой Base58 и не создаёт и не проверяет такую оболочку. Успешное декодирование не доказывает корректность адреса или ключа.

Нашли особый случай кодирования?

Начните с известного значения

Кодировщик Base32 позволяет сначала проверить короткий образец. Убедитесь в правильности алфавита и представления байтов, затем переходите к пакету.