01
숫자 텍스트와 바이트 구분
16진수 입력은 두 자리씩 짝을 맞춰야 합니다. 10진수 바이트는 0–255를 ASCII 공백으로 구분합니다. 쉼표나 배열 괄호, 0x 접두사는 자동으로 지우지 않으며 큰 정수 하나를 변환하는 모드도 아닙니다.
인코딩과 이스케이프
입력이 텍스트인지 바이트인지 정하고, 생성한 쪽과 같은 알파벳을 선택하세요.
현재 브라우저에서만 변환하며 입력을 업로드하지 않습니다.
UTF-8 텍스트, 16진수 바이트 쌍 또는 공백으로 구분한 0–255의 10진수 바이트를 사용합니다. 0x, 쉼표, 배열 괄호는 허용하지 않습니다.
Base32는 대문자만 허용합니다. Base58 체크섬은 검사하지 않습니다. Z85는 4바이트/5문자 단위입니다.
입력 65,536 UTF-16 단위, 최대 1,000줄. 항목당 65,536바이트, Base58은 4,096바이트/5,600문자. 보고서 2,000,000문자, 실행 2초 제한.
텍스트를 입력하거나 예제를 불러오세요. 빈 입력은 빈 결과가 됩니다.
Base32 인코더는 한글이 포함된 값이나 다른 라이브러리에서 만든 토큰을 확인할 때 유용합니다. 먼저 입력의 의미를 구분해야 합니다. 41을 텍스트로 읽으면 두 바이트지만 16진수로 읽으면 A를 나타내는 한 바이트입니다.
Base32 인코딩과 Base32 디코딩 외에 Base16, Base58, Base85를 지원합니다. 읽을 수 없는 바이너리는 텍스트로 억지로 바꾸지 않고 16진수나 10진수 바이트로 확인할 수 있습니다.
Base32 인코더는 표준 방식과 base32hex를 구분합니다. Bitcoin과 Flickr, Ascii85와 Git b85와 Z85도 각각 선택합니다. 배치 보고서에는 설정이 남으므로 같은 조건으로 다시 변환할 수 있습니다.
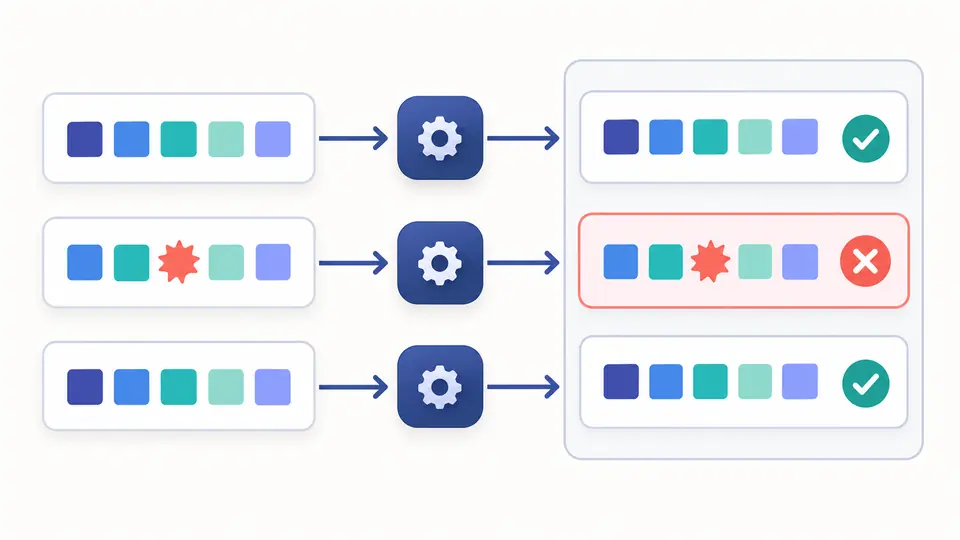
한 행에 잘못된 문자가 있어도 다른 행의 결과는 유지됩니다. 각 항목은 원래 행 번호와 오류를 보존합니다. 디코딩 결과에 줄바꿈이 있어도 JSON 문자열 안에 들어가므로 항목 경계가 바뀌지 않습니다.
16진수 입력은 두 자리씩 짝을 맞춰야 합니다. 10진수 바이트는 0–255를 ASCII 공백으로 구분합니다. 쉼표나 배열 괄호, 0x 접두사는 자동으로 지우지 않으며 큰 정수 하나를 변환하는 모드도 아닙니다.
Base32 패딩 옵션은 인코딩에만 적용됩니다. Ascii85의 Adobe 표시는 Git b85와 다릅니다. Z85는 정확한 4바이트 그룹이 필요하며 원래 길이를 바꾸는 자동 0 채우기는 하지 않습니다.
결과의 상세를 펼쳐 16진수와 10진수를 비교하세요. 자동 변환을 끄면 Ctrl/Cmd + Enter로 실행합니다. 역변환은 미리보기에 적용한 뒤 입력과 방향을 바꾸고, 실행 취소는 이전 입력과 결과를 함께 복원합니다.
Base16은 바이트마다 대문자 두 자리를 출력하고 소문자도 디코딩합니다. 표준 Base32는 A–Z와 2–7, base32hex는 0–9와 A–V를 사용합니다. base32hex는 16진수 입력의 별칭이 아니라 다른 알파벳입니다.
Bitcoin과 Flickr는 같은 문자 집합을 다른 순서로 사용합니다. 앞의 0 바이트 하나마다 1이 남습니다. 숫자의 크기만 변환할 때 사라지는 바이트를 보존하므로 원래 길이를 다시 얻을 수 있습니다.
Ascii85는 완전한 0 블록의 z 축약과 선택적 Adobe 표시를 지원합니다. Git b85는 RFC 1924 알파벳을 네 바이트 단위로 사용합니다. Z85는 ZeroMQ의 전용 알파벳과 완전한 그룹을 요구합니다.
바이트 수, 16진수와 10진수 상세를 제공합니다. 유효하지 않은 UTF-8을 대체 문자로 바꾸지 않습니다. 텍스트 디코딩이 실패해도 얻은 바이트는 남으며 다른 결과 표현을 선택해 다시 변환할 수 있습니다.
MY======와 MY는 모두 f를 나타내지만 MY=는 불완전한 패딩입니다. 정확한 패딩 또는 패딩이 없는 형태를 사용하세요. 끝의 사용하지 않는 비트도 검사하므로 생성한 쪽이 base32hex나 Crockford를 쓰는지도 확인해야 합니다.
문자열을 UTF-8 바이트로 만든 다음 Base32로 인코딩합니다. 한글, 이모지와 결합 문자를 처리하며 정규화하지 않습니다. 원본이 UTF-8이 아니라면 디코딩 결과를 텍스트 대신 16진수나 10진수로 확인하세요.
알파벳, 둘러싸는 표시와 짧은 끝 그룹의 규칙이 다릅니다. Ascii85는 !부터 u까지, Git b85는 Python의 b85encode 방식, Z85는 ZeroMQ용입니다. Ascii85의 z나 Adobe 표시는 다른 방식에서 같은 의미가 아닙니다.
두 Base58 알파벳 모두 앞쪽 0 바이트 하나마다 1을 보존합니다. 예를 들어 00 00 01은 112가 됩니다. 값 전체를 정수로만 취급하면 앞의 0이 사라지지만 이 도구는 바이트열을 유지합니다.
확실하게 판별할 수 없습니다. 알파벳이 많이 겹치므로 여러 디코더가 받아들이면서 서로 다른 바이트를 낼 수 있습니다. 생성한 프로토콜이나 라이브러리를 확인하고 알려진 값으로 검증하세요.
Base58Check는 바이트에 버전 정보와 체크섬을 더합니다. 이 페이지는 원시 Base58 인코딩과 디코딩만 제공하고 그 구조를 생성하거나 검증하지 않습니다. 디코딩 성공만으로 주소나 키가 유효하다고 판단할 수 없습니다.
설명에 없는 변환 문제가 있나요?