Codificación y escape

Codificador Base32y Base16 / 58 / 85

Define cómo interpretar los bytes y elige el alfabeto utilizado por el origen.

Codificador Base32

Entrada

La conversión se realiza en este navegador; la entrada no se sube.

Resultado

Opciones de codificación

Texto UTF-8, pares hexadecimales o bytes decimales de 0–255 separados por espacios. Sin prefijos 0x, comas ni corchetes.

Base32 exige mayúsculas. Base58 no verifica sumas de comprobación. Z85 exige grupos de 4 bytes / 5 caracteres.

Entrada: 65.536 unidades UTF-16; 1.000 líneas físicas. Por valor: 65.536 bytes; Base58: 4.096 bytes / 5.600 caracteres. Informe: 2.000.000 caracteres; ejecución: 2 segundos.

Introduce texto o carga un ejemplo. Una entrada vacía genera una salida vacía.

Un Codificador Base32 permite revisar valores que no coinciden entre bibliotecas. La interpretación de entrada importa antes de elegir el alfabeto: 41 como texto son dos bytes, mientras que 41 como hexadecimal es un solo byte que representa A.

Este decodificador Base32 también ofrece Base16, Base58 y tres variantes Base85. Los acentos y emojis se convierten mediante UTF-8; los datos binarios pueden permanecer como hexadecimal o bytes decimales cuando no representan texto.

Por qué usar este Codificador Base32

Guardar el alfabeto junto al resultado

El Codificador Base32 diferencia RFC 4648 y base32hex. Bitcoin y Flickr, así como Ascii85, Git b85 y Z85, tienen selecciones distintas. El informe de lote incluye los ajustes para que otra persona pueda reproducir la conversión sin adivinar.

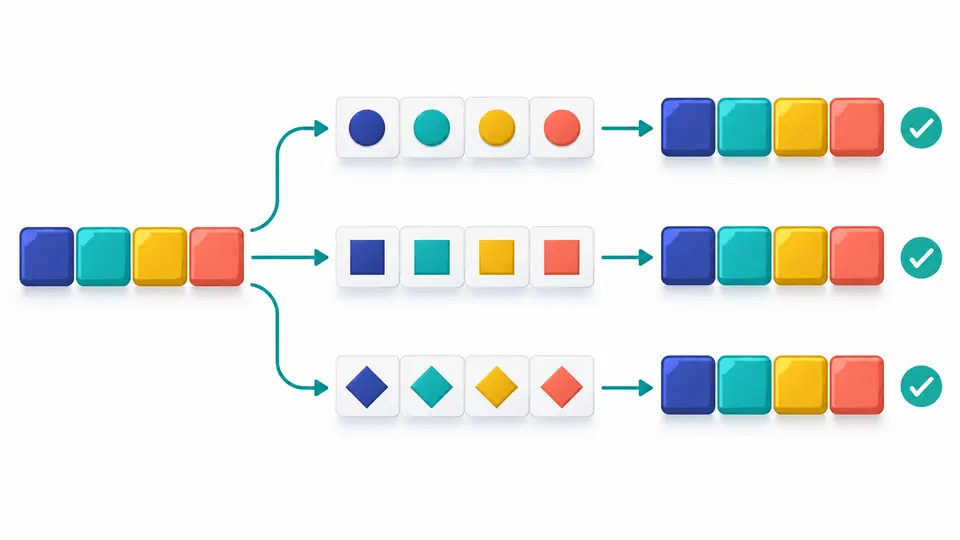
Los mismos bytes pasan por distintas secuencias de símbolos y se recuperan sin cambios.

Mantener visibles las líneas con errores

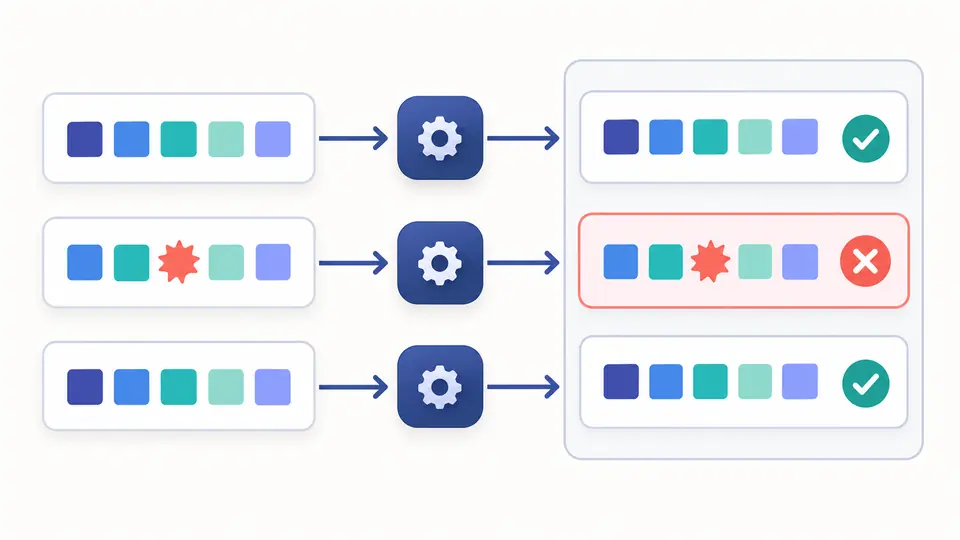
Un carácter inválido en una línea no elimina los resultados de las demás. Cada registro conserva su número de línea y error. Los saltos de línea decodificados quedan dentro de su cadena JSON y no alteran los límites entre registros.

Tres líneas independientes producen dos resultados válidos y un error visible en la línea central.

Comprobar representación y grupos

01

Separar números escritos de bytes

La entrada hexadecimal necesita pares completos. Los bytes decimales van de 0 a 255 y se separan con espacios ASCII. No se quitan automáticamente comas, corchetes ni prefijos 0x; un entero grande no equivale a una lista de bytes.

02

Respetar la biblioteca de origen

El relleno Base32 solo afecta a la codificación. Los marcadores Adobe de Ascii85 no se aplican a Git b85. Z85 necesita grupos de cuatro bytes y no añade ceros. El botón de ejemplo genera una entrada compatible con las opciones actuales.

03

Revisar los bytes antes de invertir

Abre los detalles para comparar hexadecimal y decimal. Si desactivas la conversión automática, usa Ctrl/Cmd + Enter. La inversión presenta una vista previa antes de reemplazar la entrada; Deshacer recupera entrada, ajustes y resultado juntos.

Ocho variantes con diagnóstico de bytes

Base16 y dos alfabetos Base32

Base16 escribe dos dígitos hexadecimales en mayúsculas por byte y acepta minúsculas al decodificar. Base32 usa A–Z y 2–7; base32hex usa 0–9 y A–V. Son alfabetos diferentes: base32hex no significa simplemente introducir hexadecimal.

Base58 sin perder ceros iniciales

Bitcoin y Flickr usan los mismos caracteres en distinto orden. Cada byte cero inicial se conserva como un 1 inicial. Así se mantiene la secuencia de bytes, a diferencia de convertir solo su valor numérico y perder la longitud original.

Tres formatos Base85 separados

Ascii85 admite z para un bloque cero completo y marcadores Adobe opcionales. Git b85 usa el alfabeto RFC 1924 en bloques de cuatro bytes. Z85 aplica el alfabeto ZeroMQ y exige grupos completos. Elegir el formato cambia las reglas, además de los símbolos.

Texto estricto y vistas binarias

La conversión muestra cantidad de bytes, hexadecimal y decimal. UTF-8 inválido no se convierte silenciosamente en caracteres de sustitución. Los bytes ya obtenidos siguen disponibles aunque falle la salida de texto; puedes cambiar de representación para examinarlos.

Formas aceptadas y límites del servicio

Sin corregir caracteres ni relleno
Base32 exige mayúsculas y no sustituye O/0 ni I/1. El relleno debe ser exacto o faltar por completo; los bits no usados deben ser cero. Al decodificar solo se pueden ignorar espacio ASCII, TAB, CR y LF. Al codificar texto, esos caracteres son datos.
Sin validar direcciones o enlaces cortos
No se crea ni comprueba Base58Check, prefijos de red, WIF o direcciones de cartera. El alfabeto Flickr no calcula enlaces cortos de IDs de fotos. No hay alfabetos personalizados, Crockford, Ripple ni conversión de enteros en bases arbitrarias.
Sin mezclar extensiones de Base85
Ascii85 acepta datos sin marco o la pareja completa <~ ~>, pero rechaza y de btoa y no extrae PDF. Git b85 no implementa la codificación original de un entero IPv6 completo del RFC 1924. Z85 no añade ni recorta ceros; los grupos que exceden 32 bits fallan.
Lotes separados por líneas físicas
CR, LF y CRLF delimitan registros. Se omiten las líneas totalmente vacías, pero se conservan valores de espacios. Los errores quedan en JSON. En modo individual, los saltos son datos; el informe del lote no puede reutilizarse directamente con la acción de invertir.
Presupuestos de entrada y ejecución
La entrada admite 65.536 unidades UTF-16 y hasta 1.000 líneas físicas contando las vacías. Cada valor admite 65.536 bytes; Base58, 4.096 bytes o 5.600 caracteres. Si el informe supera 2.000.000 caracteres o el cálculo dura más de dos segundos, falla la tarea completa.
Texto UTF-8 y vista previa limitada
No se importan archivos, leen URLs, extraen PDF ni detectan otros juegos de caracteres. Se conservan BOM válidos y caracteres combinados. La vista muestra 20.000 caracteres por valor y 50 filas cada vez; la exportación contiene el resultado completo y actualizado.

Preguntas sobre el Codificador Base32

¿Por qué aparece un error de relleno al decodificar Base32?

MY====== y MY representan f; MY= tiene relleno incompleto. Utiliza relleno exacto o elimínalo por completo. También se verifican los bits no utilizados. Comprueba que el origen emplee Base32 estándar y no base32hex o Crockford.

¿En qué se diferencian Ascii85, Base85 y Z85?

Cambian el alfabeto, los marcadores y los grupos finales cortos. Ascii85 usa ! hasta u, Git b85 corresponde al formato de bloques de b85encode en Python y Z85 pertenece a ZeroMQ. El atajo z y los marcadores Adobe no se trasladan a las otras variantes.

¿Cómo conserva Base58 los bytes cero iniciales?

Cada byte cero al principio genera un 1 inicial en los dos alfabetos disponibles. Por ejemplo, 00 00 01 se convierte en 112. La herramienta conserva los bytes, mientras que convertir únicamente el valor entero perdería esos ceros iniciales.

¿Cómo se procesan correctamente los caracteres internacionales y especiales en Base32?

Primero se convierten los caracteres en bytes UTF-8. Acentos, emojis y secuencias combinadas se conservan sin normalización. Si los bytes originales no son UTF-8, elige salida hexadecimal o decimal en vez de texto al decodificar.

¿Se puede identificar automáticamente una cadena Base85 o Ascii85?

No de forma fiable. Los alfabetos se solapan y varios decodificadores pueden aceptar la misma cadena pero obtener bytes diferentes. Selecciona el formato indicado por la biblioteca o protocolo de origen y verifica un valor conocido.

¿Cómo se codifica o decodifica una dirección con Base58Check?

Base58Check añade información de versión y una suma de comprobación al contenido. Esta página solo convierte Base58 sin esa estructura y no la crea ni valida. Que una cadena se decodifique correctamente no demuestra que una dirección o clave sea válida.

¿Encontraste un caso de codificación especial?

Empieza con un valor conocido

Prueba el Codificador Base32 con una muestra breve, confirma el alfabeto y la representación de bytes, y después procesa varias líneas.