Kodierung und Maskierung

Base32-Encoderauch Base16 / 58 / 85

Legen Sie die Byte-Darstellung fest und wählen Sie das Alphabet der erzeugenden Anwendung.

Base32-Encoder

Eingabe

Die Umwandlung bleibt in diesem Browser; die Eingabe wird nicht hochgeladen.

Ergebnis

Kodierungsoptionen

UTF-8-Text, Hex-Bytepaare oder dezimale Bytes von 0–255 mit Leerraum als Trenner. Keine 0x-Präfixe, Kommas oder Array-Klammern.

Base32 verlangt Großbuchstaben. Base58 prüft keine Prüfsumme. Z85 verlangt Gruppen aus 4 Bytes bzw. 5 Zeichen.

Eingabe: 65.536 UTF-16-Einheiten; 1.000 physische Zeilen. Je Wert: 65.536 Bytes; Base58: 4.096 Bytes / 5.600 Zeichen. Bericht: 2.000.000 Zeichen; Laufzeit: 2 Sekunden.

Text eingeben oder ein Beispiel laden. Leere Eingabe ergibt leere Ausgabe.

Ein Base32-Encoder ist hilfreich, wenn ein Wert zwischen zwei Bibliotheken nicht übereinstimmt. Die Ursache kann schon die Eingabe sein: 41 als Text enthält zwei Bytes, 41 als Hex dagegen ein Byte für A. Erst danach entscheidet das Alphabet über die ausgegebenen Zeichen.

Sie können Base32 kodieren und Base32 dekodieren sowie Base16, Base58 und drei Base85-Varianten verwenden. Binäre Werte bleiben als Hex oder dezimale Bytes prüfbar, auch wenn sie keinen lesbaren UTF-8-Text ergeben.

Warum dieser Base32-Encoder hilft

Das verwendete Alphabet bleibt nachvollziehbar

Der Base32-Encoder unterscheidet RFC 4648 und base32hex. Auch Bitcoin und Flickr sowie Ascii85, Git b85 und Z85 sind eigene Auswahlwerte. Der Stapelbericht enthält diese Einstellung, damit eine andere Anwendung die Umwandlung reproduzieren kann.

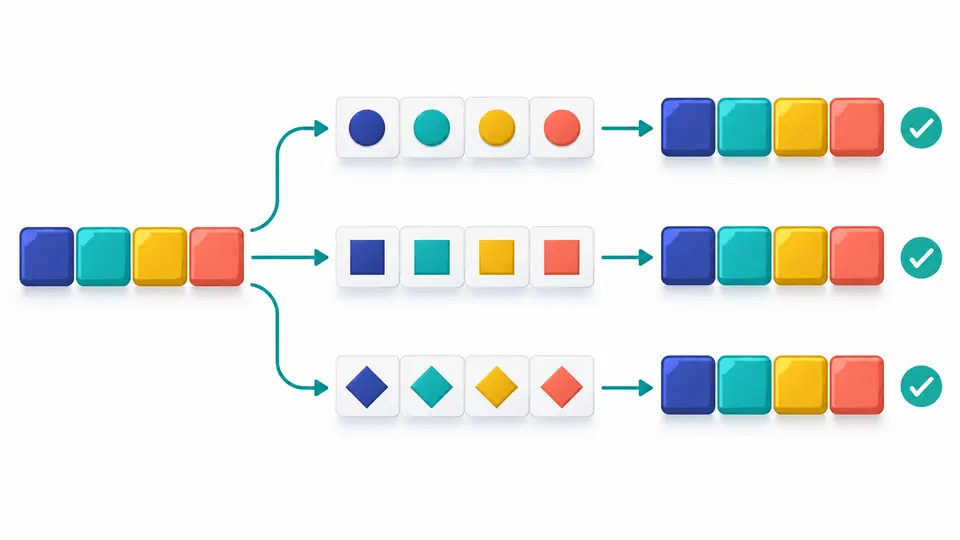
Dieselbe Bytefolge durchläuft verschiedene Symbolfolgen und wird wieder identisch hergestellt.

Fehler behalten ihre ursprüngliche Zeile

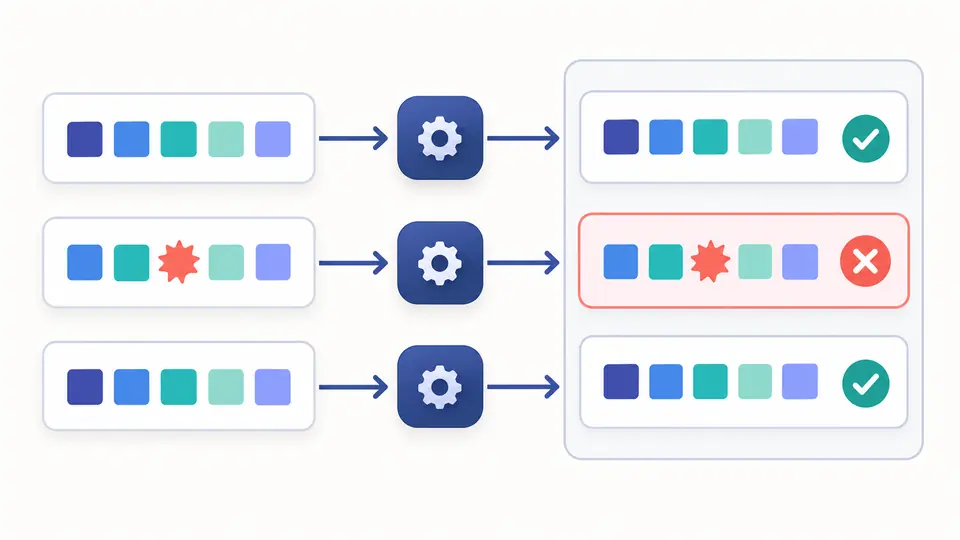
Ein ungültiges Zeichen in einer Zeile entfernt keine anderen Ergebnisse. Jeder Datensatz behält seine Zeilennummer und seinen Fehler. Enthält ein dekodierter Wert einen Umbruch, bleibt er innerhalb seines JSON-Strings und verändert die Anzahl der Datensätze nicht.

Drei getrennte Zeilen ergeben zwei erfolgreiche Werte und einen sichtbaren Fehler in der Mitte.

Darstellung, Gruppen und Rückweg prüfen

01

Bytes von Zahlentext unterscheiden

Hex erwartet vollständige Bytepaare. Dezimale Bytes sind Werte von 0 bis 255 mit ASCII-Leerraum als Trenner. Kommas, Array-Klammern und 0x-Präfixe werden nicht entfernt; ein großer Ganzzahlwert ist keine Byte-Liste.

02

Die Quellimplementierung abgleichen

Padding beeinflusst nur die Base32-Kodierung. Ascii85-Marker gehören nicht zu Git b85. Z85 benötigt Vierergruppen von Bytes und ergänzt keine Nullbytes. Das Beispiel passt sich der aktuell ausgewählten Variante und Richtung an.

03

Vor dem Rückweg die Bytes ansehen

Die Details zeigen Hex und dezimale Bytes. Ohne Automatik führt Ctrl/Cmd + Enter die Konvertierung aus. Die Rückwärtsaktion zeigt erst eine Vorschau; Anwenden ändert Eingabe und Richtung, Rückgängig stellt Eingabe und Ergebnis gemeinsam wieder her.

Acht Varianten mit überprüfbaren Bytewerten

Base16 und zwei Base32-Alphabete

Base16 gibt jedes Byte als zwei große Hex-Ziffern aus und akzeptiert beim Dekodieren auch kleine Buchstaben. Base32 verwendet A–Z und 2–7, base32hex hingegen 0–9 und A–V. Die Hex-Variante ist ein anderes Alphabet, kein anderer Name für Hex-Eingaben.

Base58 mit erhaltenen Nullbytes

Bitcoin und Flickr verwenden denselben Zeichenvorrat in anderer Reihenfolge. Jedes führende Nullbyte bleibt als führende 1 erhalten. Eine reine Umrechnung des Zahlenwerts würde diese Bytes verlieren; hier bleibt die ursprüngliche Bytefolge erhalten.

Drei getrennte Base85-Verfahren

Ascii85 unterstützt z für einen vollständigen Nullblock und optionale Adobe-Marker. Git b85 verarbeitet Vierergruppen mit dem RFC-1924-Alphabet. Z85 verwendet das ZeroMQ-Alphabet und vollständige Gruppen. Eine ähnliche Zeichenfolge beweist daher noch keine Kompatibilität.

Striktes UTF-8 mit Byte-Diagnose

Zu konvertierten Bytes gehören Länge, Hex- und Dezimalansicht. Ungültiges UTF-8 wird nicht durch Ersatzzeichen repariert. Die bereits dekodierten Bytes bleiben sichtbar, sodass Sie die Ergebnisdarstellung wechseln und die Daten erneut prüfen können.

Akzeptierte Formen und feste Grenzen

Keine automatische Zeichenkorrektur
Base32 verlangt Großbuchstaben und ersetzt weder O/0 noch I/1. Padding muss exakt sein oder ganz fehlen; ungenutzte Endbits müssen null sein. Nur ASCII-Leerzeichen, TAB, CR und LF können beim Dekodieren ignoriert werden. Im Textmodus sind sie dagegen Daten.
Keine Adress- oder Prüfsummenprüfung
Base58Check, Netzwerkpräfixe, WIF und Wallet-Adressen werden nicht erzeugt oder geprüft. Das Flickr-Alphabet berechnet keine Foto-Kurzlinks. Eigene Alphabete, Crockford, Ripple und allgemeine Ganzzahl-Konvertierung sind nicht Teil dieses Werkzeugs.
Base85-Erweiterungen bleiben getrennt
Ascii85 akzeptiert rohe Daten oder das vollständige Paar <~ ~>, aber kein btoa-y und keine PDF-Extraktion. Git b85 ist nicht die ursprüngliche RFC-1924-Kodierung einer gesamten IPv6-Zahl. Z85 ergänzt oder entfernt keine Nullen; überlaufende Gruppen werden abgewiesen.
Stapelwerte folgen physischen Zeilen
CR, LF und CRLF trennen Werte. Ganz leere Zeilen werden übersprungen; reine Leerzeichenwerte bleiben erhalten. Fehler gehören in den JSON-Bericht. Im Einzelmodus bleiben Umbrüche Daten. Der Stapelbericht kann nicht direkt über die Rückwärtsaktion eingesetzt werden.
Begrenzte Eingabe und Laufzeit
Die Grenze beträgt 65.536 UTF-16-Einheiten und 1.000 physische Zeilen einschließlich Leerzeilen. Je Wert sind 65.536 Bytes zulässig, bei Base58 4.096 Bytes oder 5.600 kodierte Zeichen. Über 2.000.000 Berichtszeichen oder zwei Sekunden Laufzeit scheitert die gesamte Verarbeitung.
UTF-8 statt Zeichensatzerkennung
Kein Dateiimport, URL-Abruf, PDF-Parser oder automatisches Latin-1. Gültige BOM-Zeichen und kombinierende Folgen bleiben erhalten. Die Vorschau zeigt höchstens 20.000 Zeichen je Wert und 50 Zeilen pro Schritt; der Export enthält das vollständige aktuelle Ergebnis.

Fragen zum Base32-Encoder

Warum meldet die Base32-Dekodierung einen Padding-Fehler?

MY====== und MY stehen beide für f. MY= enthält dagegen unvollständiges Padding. Dieses Werkzeug akzeptiert exaktes oder vollständig fehlendes Padding und prüft auch ungenutzte Bits. Klären Sie außerdem, ob die Quelle base32hex oder Crockford verwendet.

Was unterscheidet Ascii85, Base85 und Z85?

Alphabet, Marker und kurze Endgruppen unterscheiden sich. Ascii85 verwendet ! bis u, Git b85 entspricht dem Blockformat von Pythons b85encode und Z85 gehört zu ZeroMQ. Das Ascii85-Kürzel z und Adobe-Marker lassen sich nicht auf die anderen Verfahren übertragen.

Wie bleiben führende Nullbytes bei Base58 erhalten?

Jedes führende Nullbyte wird in beiden unterstützten Base58-Alphabeten durch eine führende 1 dargestellt. 00 00 01 wird deshalb zu 112. Hier wird die Bytefolge erhalten, nicht nur ihr numerischer Wert, der führende Nullen verlieren würde.

Wie verarbeitet Base32 internationale Zeichen und Sonderzeichen korrekt?

Zeichen werden zuerst zu UTF-8-Bytes und danach kodiert. Umlaute, Emoji und kombinierende Zeichen bleiben korrekt erhalten, ohne Normalisierung. Wenn die ursprünglichen Bytes nicht UTF-8 sind, wählen Sie Hex oder dezimal statt Text als Dekodierausgabe.

Lassen sich Base85 und Ascii85 automatisch erkennen?

Nicht zuverlässig. Die Zeichenvorräte überlappen sich stark; mehrere Decoder können dieselbe Zeichenfolge akzeptieren und verschiedene Bytes liefern. Wählen Sie das Format der Quellanwendung und vergleichen Sie ein bekanntes Beispiel sowie die Byteanzahl.

Wie wird eine Adresse mit Base58Check kodiert oder dekodiert?

Base58Check ergänzt Versionsdaten und eine Prüfsumme um den Byte-Inhalt. Diese Seite bietet nur rohe Base58-Kodierung und Dekodierung. Sie erstellt oder prüft diesen Rahmen nicht; eine erfolgreiche Dekodierung bestätigt keine gültige Adresse oder einen gültigen Schlüssel.

Fehlt eine Erklärung zu Ihrem Kodierungsfehler?

Mit einem bekannten Wert beginnen

Prüfen Sie im Base32-Encoder zunächst einen kurzen bekannten Wert. Stimmen Alphabet und Byte-Darstellung überein, können Sie mehrere Zeilen verarbeiten.