Codificação e escape

Conversor Base32e Base16 / 58 / 85

Defina a representação dos bytes e use o mesmo alfabeto da origem.

Conversor Base32

Entrada

A conversão acontece neste navegador; a entrada não é enviada.

Resultado

Opções de codificação

Texto UTF-8, pares hexadecimais ou bytes decimais de 0–255 separados por espaços. Sem prefixo 0x, vírgulas ou colchetes.

Base32 exige maiúsculas. Base58 não verifica checksum. Z85 exige grupos de 4 bytes / 5 caracteres.

Entrada: 65.536 unidades UTF-16; 1.000 linhas físicas. Por item: 65.536 bytes; Base58: 4.096 bytes / 5.600 caracteres. Relatório: 2.000.000 caracteres; execução: 2 segundos.

Digite texto ou carregue um exemplo. Entrada vazia produz saída vazia.

O Conversor Base32 ajuda quando um token funciona em uma biblioteca, mas não em outra. Antes de trocar o alfabeto, confira a entrada: 41 como texto contém dois bytes; 41 como hexadecimal representa um único byte, o da letra A.

A página reúne codificador Base32 e decodificador Base32, além de Base16, Base58 e Base85. ASCII85, Git b85 e Z85 ficam separados. Acentos e emojis usam UTF-8, enquanto valores binários podem ser informados e inspecionados como bytes hexadecimais ou decimais.

Por que usar este Conversor Base32

Levar o alfabeto junto com o resultado

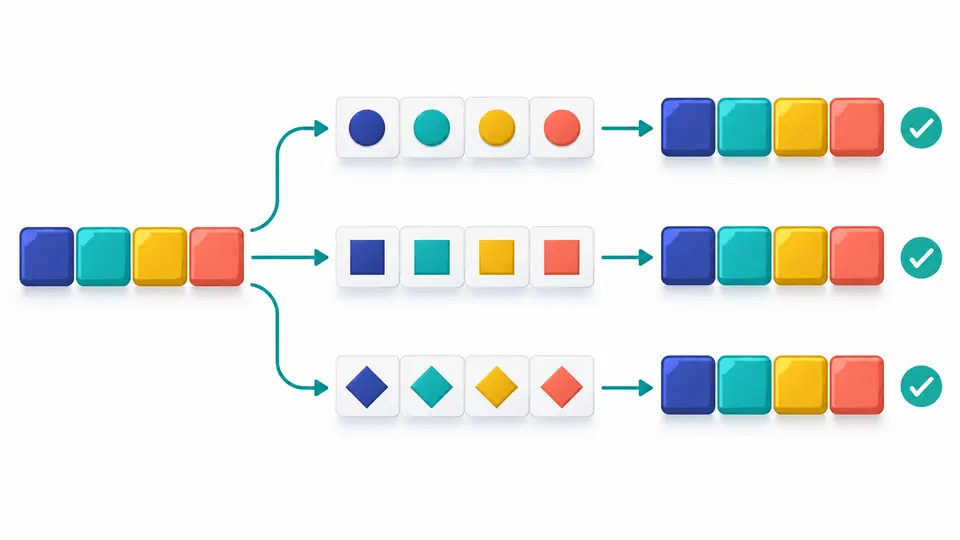
O Conversor Base32 distingue RFC 4648 de base32hex. Bitcoin e Flickr também têm opções separadas, assim como as três variantes Base85. O relatório de lote inclui as configurações para permitir a reprodução do resultado sem tentar adivinhar o formato.

Os mesmos bytes passam por diferentes sequências de símbolos e voltam aos bytes originais.

Preservar os itens que falharam

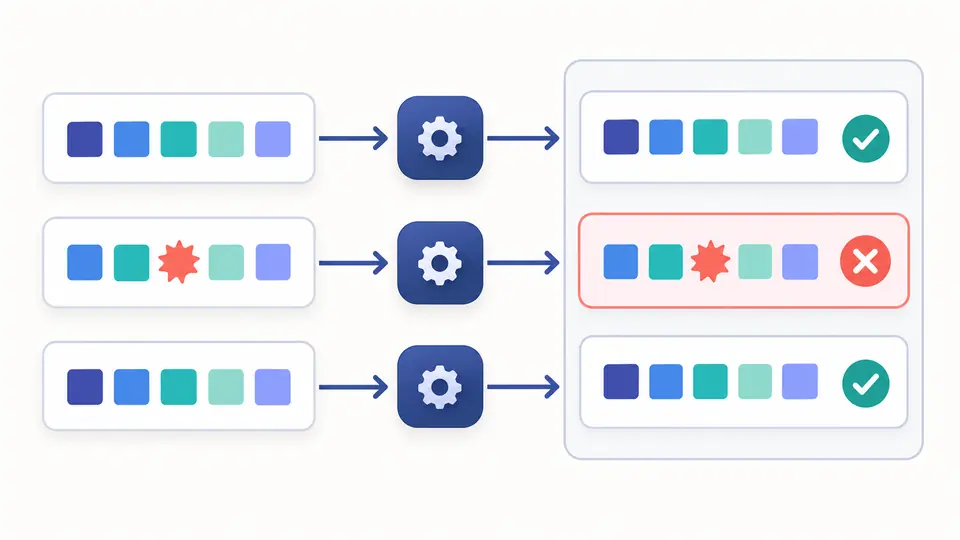
Uma linha com caractere inválido não apaga as demais conversões. Cada registro mantém o número da linha original e o erro. Quebras de linha dentro do texto decodificado ficam na string JSON e não se confundem com novos registros.

Três linhas independentes geram dois resultados válidos e um erro visível na linha central.

Conferir representação, grupos e retorno

01

Separar texto numérico de bytes

Hexadecimal exige pares completos. Bytes decimais são números de 0 a 255 separados por espaços ASCII. Vírgulas, colchetes e prefixos 0x não são removidos automaticamente. Um número inteiro grande não equivale a uma lista de bytes.

02

Seguir as convenções da origem

O padding Base32 só afeta a codificação. Os marcadores Adobe de Ascii85 não valem para Git b85. Z85 exige grupos de quatro bytes, sem completar zeros. O exemplo se adapta à variante, direção e representação selecionadas.

03

Inspecionar antes de inverter

Abra os detalhes e compare os valores hexadecimais e decimais. Com a conversão automática desligada, use Ctrl/Cmd + Enter. A inversão mostra uma prévia antes de substituir a entrada; Desfazer restaura entrada, opções e resultado juntos.

Oito variantes com inspeção dos bytes

Base16 e dois alfabetos Base32

Base16 escreve dois dígitos hexadecimais maiúsculos por byte e aceita minúsculas na decodificação. Base32 usa A–Z e 2–7; base32hex usa 0–9 e A–V. Este último é outro alfabeto, não apenas um nome diferente para entrada hexadecimal.

Base58 com zeros iniciais preservados

Bitcoin e Flickr usam os mesmos caracteres em ordens diferentes. Cada byte zero inicial é mantido como um 1 inicial. Isso preserva a sequência e sua extensão, ao contrário de converter apenas o valor inteiro e perder esses bytes.

Três regras distintas de Base85

Ascii85 aceita z para um bloco inteiro de zeros e marcadores Adobe opcionais. Git b85 usa o alfabeto RFC 1924 em blocos de quatro bytes. Z85 aplica o alfabeto ZeroMQ e exige grupos completos. A escolha define a regra de conversão, não só os caracteres.

UTF-8 estrito com diagnóstico binário

A conversão fornece contagem, hexadecimal e decimal. Bytes UTF-8 inválidos não viram caracteres de substituição silenciosamente. Mesmo se a representação em texto falhar, os bytes já obtidos continuam disponíveis para inspeção e nova conversão em outro formato.

Entradas aceitas e limites de uso

Sem corrigir caracteres ou padding
Base32 exige maiúsculas, sem mapear O/0 ou I/1. O padding deve ser exato ou totalmente ausente, e os bits não utilizados precisam ser zero. Na decodificação, apenas espaço ASCII, TAB, CR e LF podem ser ignorados; em texto, esses caracteres são conteúdo.
Sem validar endereços ou links curtos
Não criamos nem verificamos Base58Check, prefixos de rede, WIF ou endereços de carteiras. O alfabeto Flickr não calcula links curtos de IDs de fotos. Alfabetos personalizados, Crockford, Ripple e conversão geral de inteiros ficam fora deste escopo.
Extensões Base85 não se misturam
Ascii85 aceita dados brutos ou o par completo <~ ~>, rejeita y do btoa e não extrai PDF. Git b85 não é a codificação original de um inteiro IPv6 completo do RFC 1924. Z85 não acrescenta nem remove zeros. Grupos acima de 32 bits são recusados.
O lote segue as linhas físicas
CR, LF e CRLF separam os registros. Linhas totalmente vazias são ignoradas, mas valores só com espaços permanecem. Erros ficam no relatório JSON. No modo individual, a quebra de linha é dado. O relatório não pode ser inserido diretamente pela ação de inverter.
Limites de entrada e execução
A entrada aceita 65.536 unidades UTF-16 e o lote aceita 1.000 linhas físicas, incluindo vazias. Cada item aceita 65.536 bytes; Base58 aceita 4.096 bytes ou 5.600 caracteres. Relatórios acima de 2.000.000 caracteres ou execução acima de dois segundos fazem a tarefa inteira falhar.
Texto apenas em UTF-8
Não há importação de arquivos, leitura de URL, extração PDF nem detecção de outras codificações. BOM válido e caracteres combinados são preservados. A prévia mostra até 20.000 caracteres por item e 50 linhas por vez; a exportação usa o resultado completo e atualizado.

Dúvidas sobre o Conversor Base32

Por que a decodificação Base32 apresenta erro de padding?

MY====== e MY representam f, mas MY= tem padding incompleto. Use o padding exato ou remova todos os sinais. Os bits finais não usados também são verificados. Confira ainda se a origem usa Base32 padrão, base32hex ou Crockford.

Qual é a diferença entre Ascii85, Base85 e Z85?

Mudam o alfabeto, os marcadores e os grupos finais curtos. Ascii85 usa ! até u, Git b85 segue o formato em blocos de b85encode do Python e Z85 é usado pelo ZeroMQ. O atalho z e os marcadores Adobe não têm o mesmo significado nas outras variantes.

Como o Base58 preserva os bytes zero no início?

Cada byte zero no início produz um 1 inicial nos dois alfabetos suportados. Assim, 00 00 01 vira 112. A ferramenta preserva a sequência de bytes; converter apenas o valor inteiro perderia os zeros e impediria recuperar o comprimento original.

Como tratar corretamente caracteres internacionais e especiais em Base32?

Primeiro, os caracteres são convertidos em bytes UTF-8. Acentos, emojis e sequências combinadas são mantidos sem normalização. Se os bytes originais não forem UTF-8, escolha hexadecimal ou decimal na saída, em vez de tentar interpretar como texto.

É possível identificar automaticamente uma cadeia Base85 ou Ascii85?

Não de forma confiável. Os alfabetos se sobrepõem, e vários decodificadores podem aceitar a mesma string, gerando bytes diferentes. Selecione o formato documentado pela biblioteca ou protocolo de origem e confira um valor conhecido.

Como codificar ou decodificar um endereço com Base58Check?

Base58Check acrescenta versão e checksum ao conteúdo em bytes. Esta página só faz a conversão Base58 bruta e não cria nem valida essa estrutura. Decodificar sem erro não significa que um endereço ou uma chave seja válido.

Encontrou um caso de codificação inesperado?

Comece com um valor conhecido

Use o Conversor Base32 com uma amostra curta, confirme o alfabeto e a representação dos bytes e só depois amplie para um lote.