Protocols & Binary Serialization

Kafka-Partition berechnenmit den richtigen Bytes

Prüfen Sie einen Schlüssel und die Gesamtzahl der Partitionen mit Java-kompatiblem Murmur2.

Kafka-Partition berechnen

Serialisierter Schlüssel

Leerzeichen und Zeilenumbrüche bleiben erhalten. Eine leere Bytefolge ist gültig. Für einen fehlenden Schlüssel wählen Sie null.

Partitionsergebnis

Partition (ab 0)
9
Byteanzahl
5
Hash mit Vorzeichen (32 Bit)
2132663229
Hash ohne Vorzeichen (32 Bit)
2132663229
Hash ohne Vorzeichenbit
2132663229

Rechenschritte

  1. Schlüssel in 5 Bytes decodieren.
  2. Murmur2 mit Seed 0x9747b28c → 2132663229.
  3. 2132663229 & 0x7fffffff → 2132663229.
  4. 2132663229 % 12 → Partition 9.

Schlüsselbytes als Hex

68 65 6c 6c 6f

Die Berechnung bleibt in diesem Browser. Schlüssel werden weder gesendet noch gespeichert; es gibt keine Verbindung zum Kafka-Cluster.

Optionen

Gilt für Java-kompatibles Murmur2 mit Schlüssel. Eine explizite Partition, ignorierte Schlüssel, andere Serializer oder Partitioner können das tatsächliche Ziel ändern.

Berechnung abgeschlossen.

Wer eine Kafka-Partition berechnen möchte, muss zunächst die Serialisierung kennen. Eine sichtbare Kundennummer kann als Text, Integer oder strukturierte Nachricht übertragen werden. Dieser Rechner zeigt die Bytes und Zwischenwerte, damit sich ein Unterschied im Schlüssel von einer anderen Routingregel trennen lässt.

Ein Partitionsschlüssel ist für die Hashfunktion eine Bytefolge. Ein zusätzliches Leerzeichen oder ein Zeilenumbruch aus dem Log gehört dazu. Liegen bereits serialisierte Daten vor, geben Sie diese als Hex oder Base64 ein, statt ihre lesbare Darstellung nachzubauen.

Warum hier eine Kafka-Partition berechnen?

Die Eingabe vor dem Routing vergleichen

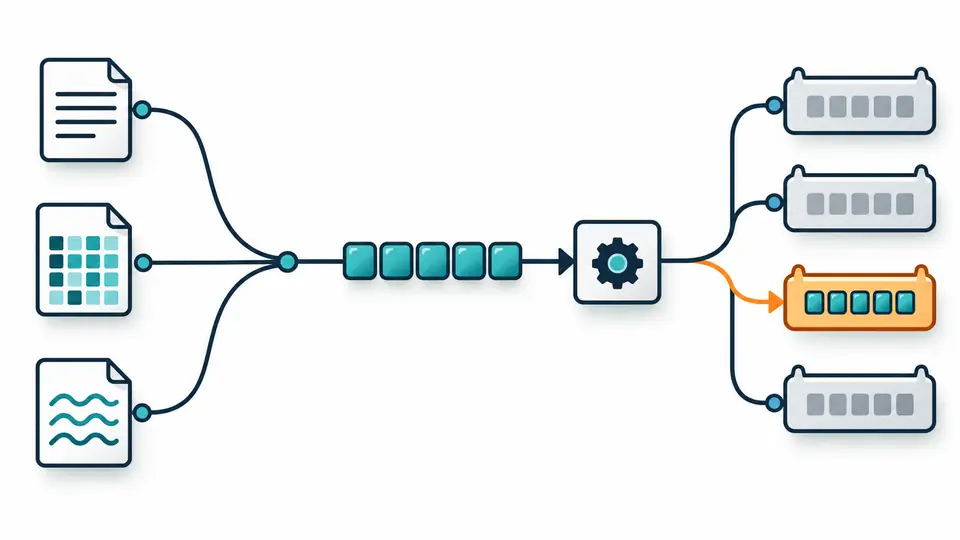
Sie können eine Kafka-Partition berechnen und zugleich die zugrunde liegenden Bytes kontrollieren. Drei Eingabeformate führen bei identischen Bytes zum gleichen Hashwert. Die Hexansicht macht Nullen, Zeilenumbrüche und mehrbyteige Zeichen sichtbar, die beim Vergleich zweier Textfelder leicht übersehen werden.

Drei Eingabekanäle münden in identische Byteblöcke und ein gemeinsames Ergebnis.

Leer und fehlend getrennt behandeln

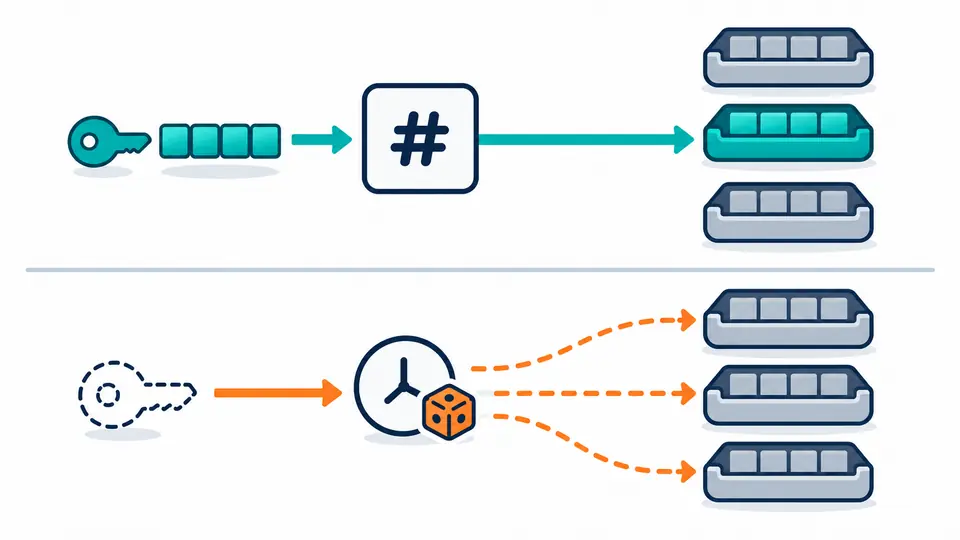
Ein leerer UTF-8-String ergibt ein vorhandenes Array mit null Bytes. Ein null-Schlüssel hat dagegen keine Bytefolge. Der erste Fall lässt sich deterministisch hashen; der zweite benötigt den Laufzeitzustand des Producers. Deshalb erscheint für null keine erfundene Zielnummer.

Ein Byteschlüssel folgt einem festen Pfad; ein fehlender Schlüssel zeigt mehrere gestrichelte mögliche Ziele.

Die Annahmen des Producers nachbilden

01

Nach der Serialisierung ansetzen

UTF-8 erhält Leerzeichen und Zeilenumbrüche. Hex erlaubt ASCII-Leerraum, benötigt aber vollständige Bytepaare ohne 0x. Standard-Base64 erfordert das passende Padding. Ein Wechsel der Codierung interpretiert die vorhandene Eingabe neu und wandelt sie nicht automatisch um.

02

Die aktuelle Gesamtzahl verwenden

12 ist ein Beispielwert, keine Empfehlung für die Dimensionierung. Die Nummerierung beginnt bei null: 12 Partitionen ergeben die Ziele 0 bis 11. Ändert sich die Anzahl, kann derselbe Hash einen anderen Rest und damit ein anderes zukünftiges Ziel liefern.

03

Den signierten Referenzwert prüfen

Laden Sie abc oder foobar aus den Testvektoren und vergleichen Sie den angezeigten Hash mit dem festen Sollwert. Automatisch wird nach 350 ms gerechnet. Bei deaktivierter Automatik startet Strg/Cmd + Enter; veraltete Ergebnisse bleiben vom Export ausgeschlossen.

Bytes, Hash und Rest nachvollziehen

Die feste Kafka-Variante von Murmur2

Der Seed lautet 0x9747b28c. Vier-Byte-Blöcke werden Little Endian gelesen, Produkte auf 32 Bit begrenzt. Die Anzeigen mit und ohne Vorzeichen beschreiben dieselben Bits. Für das Routing wird das Vorzeichenbit mit 0x7fffffff gelöscht; der Absolutbetrag wäre eine andere Rechnung.

Strenge Prüfung der Byteformate

Hex und Standard-Base64 bilden beliebige Bytes einschließlich 00 und ff ab. Ungerade Hexlängen, falsches Padding und ungültige abschließende Base64-Bits werden abgelehnt. Text bleibt hinsichtlich Großschreibung, Leerraum und Unicode-Normalform unverändert, damit keine stillen Korrekturen den Hash verschieben.

Feste Vektoren und vollständiger Bericht

abc, foobar und 21 enthalten erwartete Hashwerte aus Apache Kafka. Die Vorschau zeigt zunächst 100 Bytes und lässt sich jeweils um 100 erweitern. Im JSON-Bericht stehen alle Bytes, Codierung, Schlüsseltyp, Partitionsanzahl, Algorithmus und die numerischen Zwischenwerte für den Vergleich mit Logs.

Gültigkeitsbereich und Grenzen

Kein universeller Clientstandard
Implementiert ist ausschließlich Java-kompatibles Murmur2. librdkafka kann standardmäßig CRC32 verwenden. Ein eigener Partitioner, partitioner.ignore.keys oder eine ausdrücklich gesetzte Partition kann die Formel umgehen. CRC32, Murmur3, FNV und frei wählbare Seeds sind hier keine zusätzlichen Optionen.
Keine feste Vorhersage für null
Der Typ null erhält den Text, ignoriert ihn aber bei der Berechnung. Sticky- und Zufallsverfahren benötigen Laufzeitinformationen. Die Buchstaben null im Byteschlüssel-Modus sind dagegen vier normale UTF-8-Bytes. Prüfen Sie außerdem, ob Ihr Client leere Bytefolgen wie fehlende Schlüssel behandelt.
Keine eingebauten Geschäftsdaten-Serializer
Avro, Protobuf, Integer-Serializer und Schema-Registry-Abfragen werden nicht ausgeführt. Leerraum wird nicht entfernt und Unicode nicht normalisiert. Ungepaarte Surrogate werden abgelehnt, statt sie unbemerkt zu ersetzen. Für abweichende Serializer müssen Sie die tatsächlichen Bytes liefern.
Ein begrenztes Browserbudget
Erlaubt sind 196608 UTF-16-Codeeinheiten und 65536 decodierte Bytes. Die Partitionsanzahl muss eine Dezimalzahl zwischen 1 und 2147483647 sein. Datei-, URL- und Stapelimport fehlen bewusst. Diese Werte sind lokale Verarbeitungsgrenzen und keine Aussage über das Nachrichtenlimit eines Brokers.
Keine Kapazitätsplanung oder Datenverschiebung
Aus einem einzelnen Schlüssel lassen sich weder eine empfohlene Anzahl noch Broker, Consumer oder Offset ableiten. Eine höhere Anzahl kann zukünftige Schreibziele ändern, verschiebt aber keine bereits gespeicherten Nachrichten. Verteilung, Migration und Reihenfolge über Partitionsgrenzen werden nicht vorhergesagt.

Kafka-Partition berechnen: häufige Fragen

Wie lässt sich die Zielpartition eines Schlüssels bestimmen?

Für das gewählte schlüsselbasierte Verfahren berechnen Sie Murmur2 über die serialisierten Bytes, löschen das Vorzeichenbit und bilden den Rest zur Gesamtzahl. abc ergibt den signierten Hash 479470107 und bei 12 Partitionen das Ziel 3. Die tatsächliche Anzahl müssen Sie anhand der Topic-Metadaten prüfen.

Können unterschiedliche Schlüssel in derselben Partition landen?

Ja. Sehr viele Schlüssel teilen sich eine endliche Anzahl von Zielen. Dafür müssen die vollständigen 32-Bit-Hashes nicht identisch sein: Verschiedene positive Hashwerte können denselben Rest ergeben. Die gemeinsame Partition beweist daher weder gleiche Schlüssel noch eine vollständige Hashkollision.

Warum erreichen Nachrichten mit gleichem Schlüssel unterschiedliche Partitionen?

Vergleichen Sie Bytes, Partitionsanzahl und Partitioner-Konfiguration. Unterschiedliche Clients können andere Algorithmen und Serializer verwenden. Auch eine explizite Partition oder das Ignorieren von Schlüsseln kann die Ursache sein. Ein Consumer-Rebalancing ändert die Zuständigkeit für Partitionen, aber nicht diese Hashformel.

Ist beim Senden an Kafka ein Schlüssel erforderlich?

Nein. Ob ein Schlüssel nötig ist, hängt von den Anforderungen an Gruppierung und Reihenfolge ab. Ohne Schlüssel kann ein Producer ebenfalls senden. Das Ziel ergibt sich dann jedoch nicht allein aus der hier berechneten Murmur2-Formel. Eine leere Zeichenfolge ist ein eigener, davon verschiedener Fall.

Wie wird die Partition ohne Schlüssel ausgewählt?

Das hängt von Client, Version, Konfiguration und Laufzeitzustand wie der Batchbildung ab. Java-Producer können Sticky-Verhalten nutzen; andere Clients folgen ihren eigenen Regeln. Der Rechner gibt für null keine feste Partition aus und setzt auch nicht pauschal ein älteres Round-Robin-Verfahren voraus.

Ändert sich der Murmur2-Seed zwischen Programmstarts?

Die Kafka-Variante verwendet den festen Seed 0x9747b28c. Identische Bytes erzeugen deshalb über Programmstarts hinweg denselben Hash. Das endgültige Ziel kann sich trotzdem ändern: Eine andere Partitionsanzahl verändert den Modulo-Schritt, ein anderer Partitioner gegebenenfalls die gesamte Zuordnung.

Eine unerwartete Berechnung entdeckt?

Den nächsten Schlüssel abgleichen

Jetzt eine Kafka-Partition berechnen: Verwenden Sie die Bytes Ihres Serializers und vergleichen Sie die Zwischenwerte mit der Routingimplementierung des Producers.